이미 완성되어 내보낸 이미지 안의 글자를 현지화하는 열 가지 방법 — 레이아웃과 폰트, 배경은 디자이너가 남긴 그대로 유지하면서.
영어로 만든 캠페인 포스터. 일본어 메뉴판. 독일어 제품 라벨. 스페인어로 표기된 기술 도해. 이 모두를 다른 언어로 바꿔야 하는데, 손에 쥔 것은 내보낸 이미지뿐입니다.
문서를 번역하는 일은 간단합니다. 텍스트를 번역가에게 넘기고 번역문을 받으면 됩니다. 하지만 이미지 속 텍스트를 번역하는 일은 전혀 다른 문제입니다. 단순히 단어만 바꾸는 것이 아닙니다. 디자이너의 레이아웃이 어깨 너머로 지켜보는 가운데 픽셀 단위의 정밀 수술을 하는 셈이고, 조금이라도 실수하면 — 폰트가 미묘하게 어긋나거나, 배경이 제대로 정렬되지 않거나, 번역문이 원문보다 30% 길어지기만 해도 — 즉시 눈에 띕니다.
바로 이것이 이미지 현지화를 그토록 까다롭게 만드는 문제입니다. 의미는 바꾸되 디자인은 바꾸지 않아야 합니다. 아래 보고서는 그 일을 해내는 열 가지 실제 접근법을 정리한 것으로, 완전 수작업 디자인부터 원클릭 AI까지 아우르며 각 방법의 보존도, 비용, 실패 양상을 함께 제시합니다.
이미지 텍스트 번역
무료 온라인 이미지 번역기로 이미지에 포함된 글자를 자동 번역하고 시각 요소를 깔끔하게 복원해 보세요.
이미지 속 텍스트 번역이 이렇게 어려운 이유
문서를 번역할 때는 레이아웃이 유연하게 늘어납니다. 그러나 이미지에 각인된 텍스트를 번역할 때는 레이아웃이 픽셀 단위로 고정되어 있습니다. 이 하나의 제약이 연쇄적인 문제를 만들어냅니다.
텍스트 길이가 바뀝니다. 짧은 영어 구절 하나가 독일어나 프랑스어로 번역되면 30% 이상 부풀어 오르고, 중국어나 일본어로 번역되면 크게 줄어듭니다. 원본 디자인의 공간은 고정되어 있으므로, 번역문은 구도를 깨뜨리지 않으면서 다시 맞춰야 합니다 — 크기를 조정하거나, 줄바꿈을 다시 하거나, 자간을 다시 조정하는 식입니다.
폰트와 스타일이 일치해야 합니다. 원래의 서체, 굵기, 색상, 자간, 그리고 그림자나 외곽선 같은 효과까지 모두 재현해야 합니다. 이걸 틀리면 현지화 버전은 원본 옆에서 미묘하게 ‘이질적으로’ 보입니다.
배경을 다시 만들어야 합니다. 원문 텍스트를 지우면 그 아래 픽셀이 파괴됩니다. 단색 배경에서는 사소한 일이지만, 사진이나 그라데이션, 질감이 있는 배경이라면 사라진 이미지를 재구성해야 합니다.
텍스트가 아닌 요소도 신경 써야 합니다. 화살표, 콜아웃, 번호, 범례는 종종 텍스트를 포함하거나 텍스트를 가리키므로, 깔끔한 현지화는 이들까지 고려해야 합니다.
아래의 모든 방법은 이 네 가지 문제 사이에서 균형을 잡는 서로 다른 방식입니다. 어떤 것을 선택할지는 결과물이 얼마나 충실해야 하는지, 이미지에 담긴 텍스트가 얼마나 많은지, 그리고 원본 소스 파일이 있는지에 따라 달라집니다.
가장 빠른 길: 온라인 AI 이미지 번역
수작업 방법으로 들어가기 전에, 지름길이 존재한다는 것 — 그리고 대부분의 사람이 가장 먼저 시도해야 할 방법이라는 것을 알아두십시오.
바로 이 작업을 위해 만들어진 온라인 AI 도구, 예컨대 ReWords AI는 텍스트 감지, 기계 번역, AI 이미지 인페인팅(inpainting)을 하나의 흐름으로 결합합니다. 새로운 텍스트 상자를 덧씌우는 대신, 이미지에 이미 들어 있는 텍스트를 감지하고, 번역하고, 원문을 지우고, 배경을 재구성한 뒤, 번역문을 어울리는 폰트와 색상, 크기로 다시 그려 넣습니다 — 그래서 레이아웃은 그대로 유지됩니다.
작동 방식:
- 이미지를 업로드합니다. 도구를 열고 “Translate Text in Image” 기능을 선택한 다음, 사진(예: “SUMMER SALE” 배너가 들어간 광고)을 업로드합니다.
- 언어를 고르고 편집합니다. 플랫폼이 모든 텍스트 줄을 자동으로 감지합니다. 대상 언어를 선택하면 줄 단위 번역 제안을 돌려주며, 이를 직접 수정할 수 있습니다. 브랜드 이름처럼 바뀌면 안 되는 단어는 잠가 둡니다.
- 생성합니다. Generate 또는 Apply를 클릭하면 AI가 원문을 제거하고 원래의 폰트, 색상, 배경을 사용해 번역문을 다시 그립니다.
- 다운로드합니다. 결과를 확인하고 현지화된 이미지를 다운로드합니다.
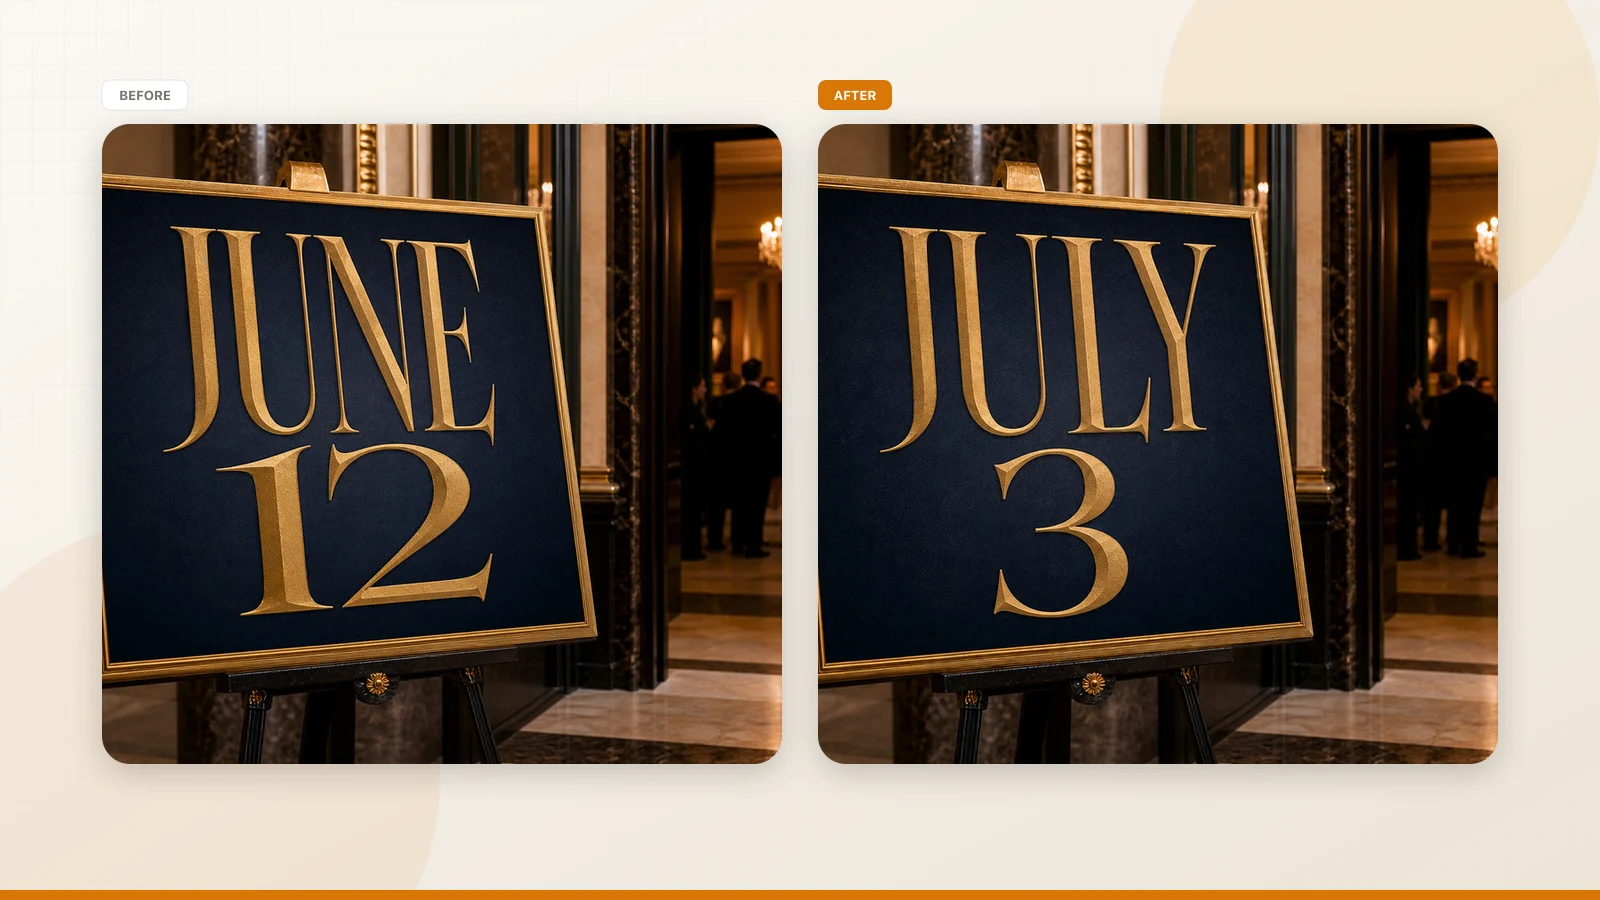
그림: 온라인 AI 번역 예시(왼쪽: 원본, 오른쪽: 번역 후).
왜 이것이 기본 선택인가: 원본 디자인 파일도, 소프트웨어 설치도, 디자인 실력도 필요하지 않습니다. 일반적인 이미지는 몇 초에서 1분 안에 결과가 나옵니다. 이 범주의 도구들은 보통 무료 사용 한도가 있으며(ReWords는 이미지당 몇 회의 무료 생성을 제공), 그 이상은 유료 크레딧을 사용합니다.
주의해야 할 점: 번역문 자체를 점검할 가치가 있습니다 — 특히 숫자와 고유명사 — 그리고 텍스트가 빽빽하거나 조명이 복잡하거나 폰트가 지나치게 장식적이면 AI의 재구성이 간혹 실수를 저지를 수 있습니다. 또한 저작권과 민감한 콘텐츠에 유의할 만합니다.
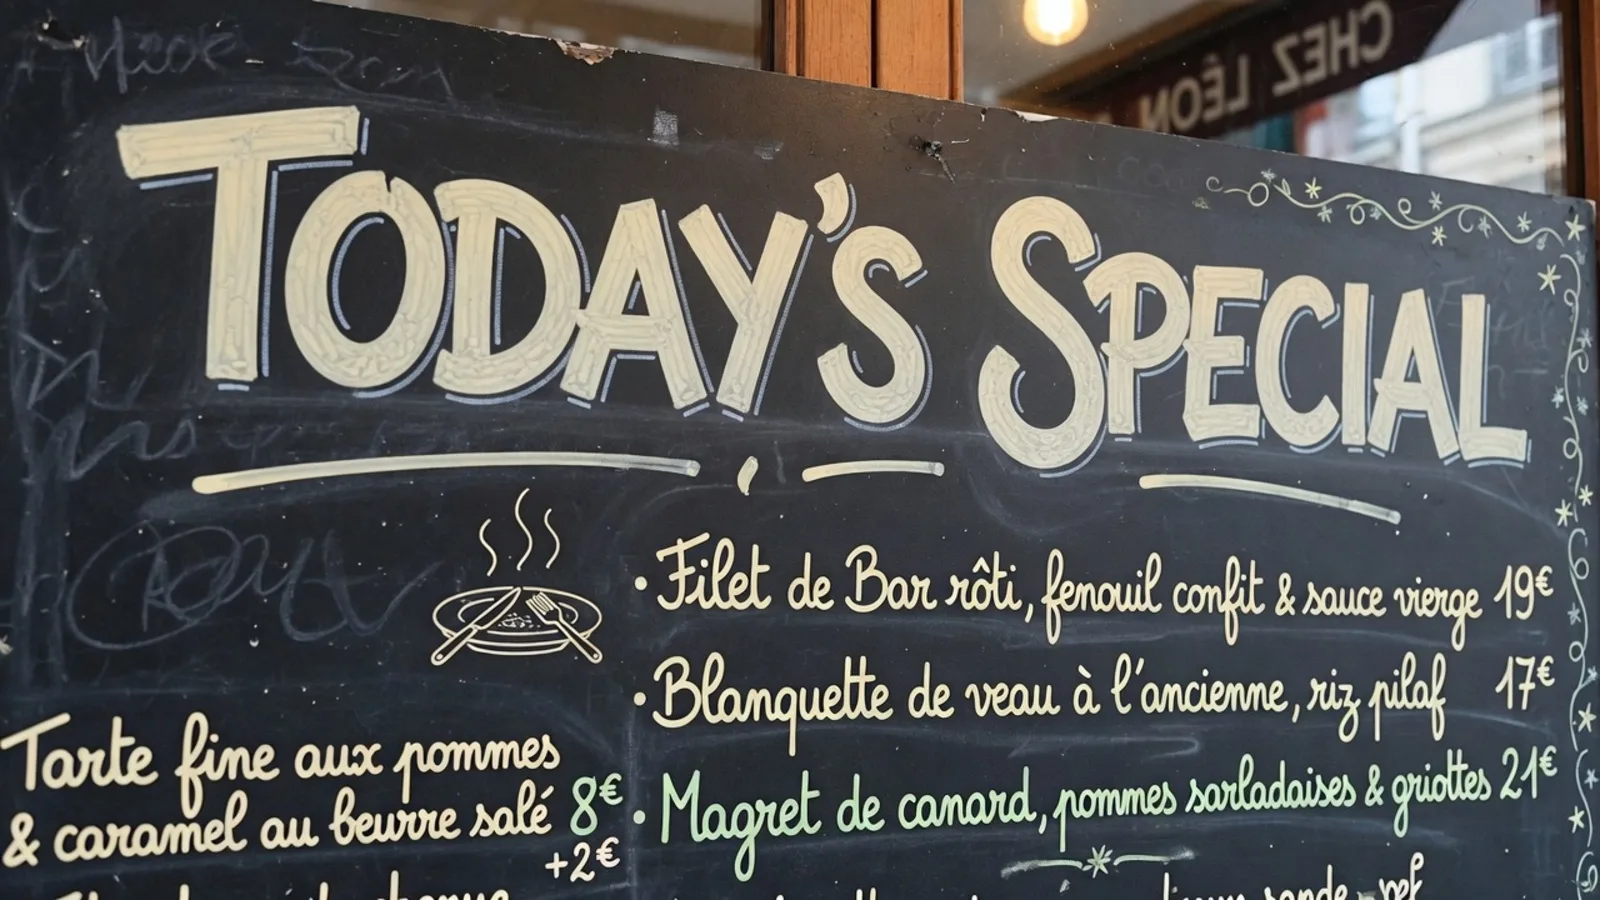
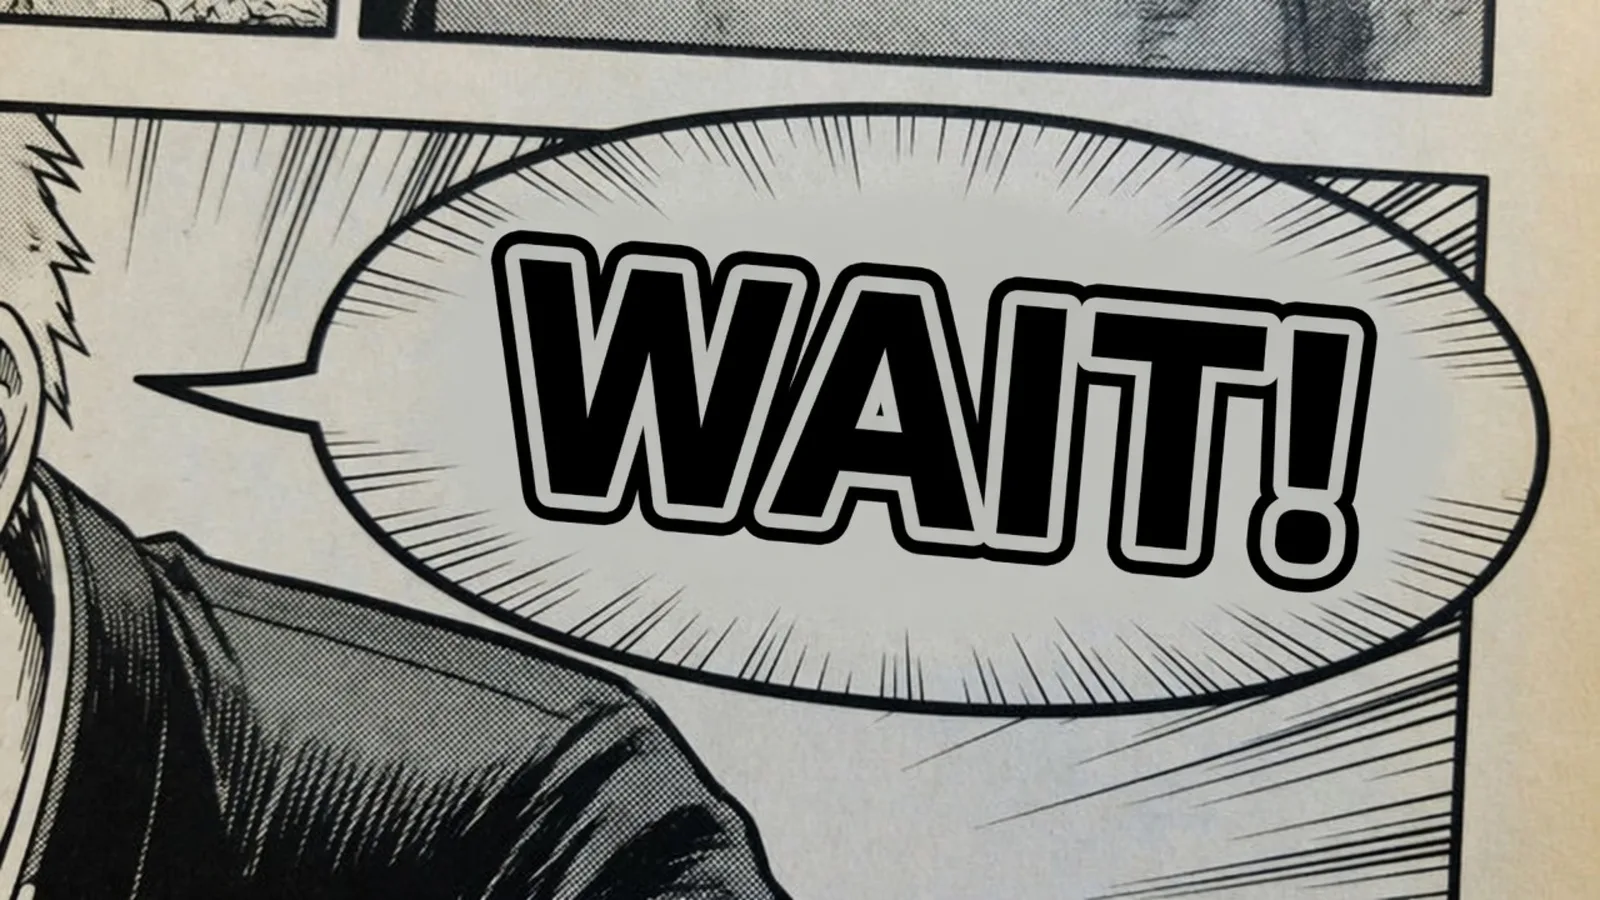
가장 현실에 맞는 용도: 이커머스 제품 이미지, 현지화된 광고와 소셜 그래픽, 메뉴, 전단지, 만화 — 원본 파일이 더 이상 남아 있지 않은 일상적인 현지화 작업에 적합합니다.
완전한 도구 상자: 디자인을 망가뜨리지 않고 이미지 텍스트를 번역하는 10가지 방법
이미지가 복잡하거나, 위험 부담이 크거나, 아니면 직접 파이프라인을 구축하고 싶다면, 알아 둘 가치가 있는 열 가지 접근법을 여기 모두 정리했습니다. 각 방법은 작동 방식, 필요한 것, 보존도, 그리고 누구에게 맞는지를 함께 제시합니다.
방법 1: 수동 디자인 편집(Photoshop / Illustrator)
작동 방식: 전문 디자이너가 손으로 처리합니다. 먼저 원문 텍스트를 추출하고(OCR 또는 수동 전사), 번역합니다. 그런 다음 Photoshop, Illustrator 또는 유사한 도구에서 번역문을 어울리는 폰트와 스타일로 원문 영역 위에 다시 입력합니다. 흐름은 텍스트 추출 → 번역 및 교정 → 일치하는 폰트 찾기 또는 제작 → 원문 삭제, 번역문 삽입, 효과 조정으로 이어집니다.
도구: Adobe Photoshop, Illustrator, InDesign, GIMP, Figma; Tesseract 같은 OCR 도구가 추출을 도울 수 있습니다.
입력 / 출력: 입력은 모든 이미지 형식(PNG/JPEG); 출력은 동일한 형식의 새 이미지, 또는 레이어 편집이 가능한 PSD/AI 파일입니다.
자동화: 낮음. 대부분 수작업이며, OCR 추출 단계에서만 자동화됩니다.
정확도 및 보존도: 최고. 디자이너가 폰트, 위치, 스타일을 완전히 통제하며 원본 디자인을 픽셀 단위까지 재현할 수 있습니다. 보존도는 실력에 달려 있고, 속도가 느리며, 번역문 길이 증가에 민감합니다.
시간 및 비용: 높음. 전문 편집은 복잡도에 따라 몇 분에서 몇 시간까지 걸릴 수 있고, 소프트웨어 자체에도 학습 부담이 있습니다 — 대량 번역 시 비효율적입니다.
장단점: 레이아웃과 스타일을 완전히 보존(이론상 이음새 없는 교체)한다는 것이 장점이며, 요구 수준이 높은 마케팅 및 브랜드 문구에 적합합니다. 하지만 느리고 비싸며 오류가 나기 쉽고, 동일한 폰트가 없으면 완벽한 일치가 어렵습니다.
적합한 용도: 고충실도 현지화를 요구하는 광고 포스터, 패키징 디자인, UI 프로토타입, 인쇄 홍보물.
사례 메모: Atlas Cloud는 OCR이 텍스트를 추출한 뒤에도 여전히 이를 손으로 “디자인 안에 다시 배치”해야 한다고 지적합니다. 반면 순수 이미지 편집은 변경을 새로운 래스터 레이어에 병합하므로 개별 글자에 대한 통제가 적습니다 — 수동 조판이 더 느리지만 가장 정밀합니다.
방법 2: OCR + 디자인 소프트웨어 조판
작동 방식: 자동화가 약간 더해진 반수동 파이프라인입니다. 먼저 이미지에 OCR을 실행해 각 텍스트 상자의 내용과 위치를 추출합니다. 그다음 기계 번역이나 인간 번역으로 번역문을 얻습니다. 마지막으로 조판 소프트웨어나 스크립트를 사용해 번역문을 원래 위치와 스타일로 이미지에 다시 렌더링합니다. 파이프라인: OCR 인식 → 텍스트 번역 → 레이아웃 재구성 → 이미지 출력.
도구: OCR 라이브러리와 앱(Tesseract, EasyOCR, Adobe Acrobat OCR); 번역 API(Google Translate, DeepL, Baidu Translate); 조판 도구(Adobe InDesign, Photoshop, 또는 프로그래밍 환경의 Pillow/Matplotlib).
입력 / 출력: 입력은 모든 이미지 형식(PNG/JPEG); 출력은 새 이미지. 중간에 벡터 문서(PDF/AI)를 사용해 레이아웃을 보존할 수 있습니다.
자동화: 중간. OCR과 번역은 자동화할 수 있지만, 최종 조판은 대개 사람의 손이 필요합니다 — 특히 원문과 대상 언어의 길이 차이가 클 때 폰트 크기와 줄 간격을 조정해야 하기 때문입니다.
정확도 및 보존도: 높음. 폰트와 프레임 위치를 맞추면 레이아웃이 잘 보존됩니다. 하지만 번역문 증가가 원래의 공간 배치를 깨뜨릴 수 있어 크기 조정이나 줄바꿈이 필요하며, 복잡한 그래픽에서의 위치 오류는 보존도를 떨어뜨립니다.
시간 및 비용: 중간. OCR과 번역 부분은 빠르지만(몇 초에서 몇 분), 후속 조판에 몇 분에서 수십 분이 걸립니다.
장단점: 순수 수작업보다 빠르지만, OCR 정확도와 폰트 매칭에 의존하며, 커닝(kerning)과 합자(ligature)에서 미세한 차이가 생길 수 있습니다. 디자인 요구가 높은 텍스트 위주 이미지에 적합합니다. 문제는 텍스트가 아닌 요소(지시선, 번호)를 처리하지 못한다는 점입니다 — 이런 것은 수작업이 필요합니다.
적합한 용도: 텍스트 요소가 많은 차트 주석, 기술 매뉴얼, 교육용 도해의 현지화.
배경: PDF 번역 도구는 대체로 이 논리를 따릅니다 — 문서 구조를 분석하고, 영역별로 번역한 뒤 “텍스트를 제자리에서 교체하고 레이아웃을 보존”합니다. 이미지에 OCR과 블록 단위 번역을 적용하면 동일한 제자리 교체 결과를 얻습니다.
방법 3: 전용 문서 번역 서비스(형식 보존형)
작동 방식: 기업용 또는 온라인 형식 보존 번역 서비스를 사용합니다. 이 도구들은 입력 파일이나 이미지의 레이아웃과 폰트를 분석하고, 각 텍스트 블록을 기계 번역한 뒤, 출력물을 다시 조판합니다. 핵심 단계: 레이아웃 분석(텍스트 상자 좌표, 폰트 식별) → 텍스트 번역(클라우드 서비스 또는 로컬 MT) → 레이아웃 재렌더링 → 파일 출력. 이미지 부분은 대개 그대로 보존됩니다.
도구: PDFTranslator(Gemini + ChatGPT 엔진), Pangeanic ECO 플랫폼, Pairaphrase, Smartcat 같은 온라인 플랫폼 또는 상용 소프트웨어. 대부분 PDF나 이미지 입력을 받아 원래 스타일을 유지한 번역 PDF 또는 그래픽을 출력합니다.
입력 / 출력: 스캔본, 이미지 또는 PDF 입력(JPG/PNG/PDF); 레이아웃, 표, 그래픽 위치가 사실상 그대로 유지된 동일 형식의 번역 파일 출력.
자동화: 높음. 시스템이 처음부터 끝까지 자동으로 처리하며, 약간의 인간 교정만 필요합니다.
정확도 및 보존도: 높음. 고급 서비스는 고정밀 OCR에 전용 LLM/번역 시스템을 결합해 텍스트와 형식의 좌표 수준 매핑을 구현합니다. 레이아웃과 폰트가 보존되며(문서 수준 보존도는 90% 이상에 달할 수 있음), 오류는 주로 번역문 길이 차이에서 비롯됩니다.
시간 및 비용: 낮음. 번역이 빠릅니다 — 대부분의 작업이 몇 초에서 몇 분이면 끝납니다(60페이지 PDF도 몇 분 안에). 하지만 보통 유료 서비스이거나 구매한 API 할당량이 필요합니다.
장단점: 장점은 자동화 수준이 높고 시간이 절약되며 보존도가 좋다는 것입니다. 단점은 API 요금에 민감하다는 점(대량이나 장문 문서는 비용이 듦)과 특이한 레이아웃이나 손글씨에 대한 지원이 제한적이라는 점입니다. 대량 문서나 이미지 번역에 적합합니다.
적합한 용도: 레이아웃을 충실히 보존해야 하는 기업 다국어 기술 문서, 제품 매뉴얼, 교육 자료, 재무 보고서. 내부적으로 이런 시스템은 본질적으로 OCR + 번역 + 자동 조판 파이프라인입니다.
방법 4: 온라인 AI 이미지 번역 도구
작동 방식: 전용 AI 서비스가 이미지 안의 텍스트를 직접 번역하고 수정하며, 흔히 딥러닝을 사용해 자동으로 “마스킹하고 다시 칠합니다.” 일반적인 흐름: 원본 업로드 → 텍스트 영역 자동 OCR → 자동 번역(수동 교정 가능) → 모델이 원문을 지우고 번역문을 유사한 폰트 스타일로 다시 그림 → 새 이미지 다운로드. 이 도구들은 OCR, MT, 이미지 완성을 하나로 묶어 원클릭 번역으로 만들어 줍니다.
도구: ReWords AI, ImageGPT, EditTextImage, Codia, VisualGPT 등. 인터페이스는 대개 바뀌면 안 되는 텍스트 줄을 잠그고 제안된 번역문을 편집할 수 있게 해 줍니다.
입력 / 출력: 입력은 일반 비트맵(PNG/JPEG); 출력은 동일 해상도의 비트맵이며, 번역문은 원래 스타일로 렌더링됩니다.
자동화: 높음. 업로드하고 “생성”을 클릭하면 AI가 중간 단계를 처리합니다.
정확도 및 보존도: 전반적으로 높음. 최신 생성 모델은 폰트 스타일과 배경 질감을 충분히 잘 맞춰 “편집 흔적이 보이지 않는” 결과를 만들어 냅니다. 다만 텍스트가 매우 빽빽하거나 조명이 복잡하거나 폰트가 지나치게 장식적이면 결함이 생길 수 있습니다. OCR 정확도는 원본 품질에 달려 있고, 기계 번역은 대부분 신경망 방식이라 품질이 들쭉날쭉하므로 사람의 검토가 필요합니다.
시간 및 비용: 낮음에서 중간. 대부분의 온라인 도구는 몇 초에서 1분 안에 결과를 반환하며(무료 사용 한도가 있는 경우가 많음), 로컬 설치가 필요 없고 비기술 사용자에게도 친화적입니다. 대량 작업에는 결제나 크레딧이 필요합니다.
장단점: 편리하고 효율적이며, 원본 디자인 파일 없이 이미지 위에서 텍스트를 직접 교체합니다. 하지만 품질이 AI에 달려 있어 때때로 재시도나 프롬프트 미세 조정이 필요하고, 저작권과 민감 정보는 주의 깊게 다루어야 합니다.
적합한 용도: 이커머스 제품 이미지, 현지화된 광고와 소셜 그래픽, 메뉴, 전단지, 만화의 일상적 현지화. 예를 들어 ReWords는 제품 패키징의 “SUMMER SALE”을 “夏季特卖”로 바꾸면서 배경을 그대로 유지하는 결과를, EditTextImage는 “Summer sale — 30% off everything”을 독일어 “Sommer-Sale — 30 % auf alles”로 번역하면서 레이아웃을 바꾸지 않는 결과를 보여 줍니다. 이들은 전형적인 현지화 시나리오입니다.
그림: 온라인 AI 도구 번역 예시(왼쪽: 원본, 오른쪽: 번역 후).
방법 5: 모바일 즉석 번역 앱
작동 방식: 휴대폰의 이미지 번역 앱(Google Translate, Baidu Translate 카메라 모드, Microsoft Translator)을 사진이나 가져온 이미지에 사용합니다. 대부분 텍스트를 실시간으로 인식해 화면 위에 번역문을 덧씌우거나, 번역문이 들어간 스냅샷을 생성합니다. 흐름: 사진 촬영/가져오기 → 자동 OCR → 자동 번역 → 원문 위에 덧씌우거나 표시 → 결과 확인.
도구: Google Translate 앱, Baidu Translate 카메라, WeChat 내장 스캔-번역 등.
입력 / 출력: 입력은 휴대폰 사진이나 스크린샷; 출력은 대개 덧씌운 이미지나 번역 텍스트. 일부는 주석이 달린 이미지 저장 기능을 제공합니다.
자동화: 완전 자동. 텍스트 입력이 필요 없어 조작이 간단합니다.
정확도 및 보존도: 낮음. 주목적은 이해이며, 번역문은 기본 폰트와 거친 배경 마스크를 사용하고, 원래 레이아웃과 스타일은 전혀 보존되지 않습니다. OCR과 번역 품질은 전문 도구에 가깝지만, 출력물은 게시 가능한 디자인 파일로 사용할 수 없습니다.
시간 및 비용: 극히 낮음. 실시간 번역이며 대개 몇 초면 됩니다.
장단점: 전문 지식 없이 빠르고 편리해 일상 사용에는 충분합니다. 하지만 원래 디자인을 보존할 수 없고, 로고나 워터마크가 추가될 수 있으며, 출력물은 참고용 읽기에만 적합하고 최종 게시용은 아닙니다.
적합한 용도: 여행 중이나 일상에서 외국어 메뉴, 도로 표지판, 설명서를 빠르게 이해하는 것. Baidu Translate로 텍스트를 촬영해 이미지를 저장하는 사용자들은 종종 도구의 브랜드 표시나 일부를 가리는 패치를 보게 됩니다. 이런 도구는 공식 현지화보다 읽기 보조에 더 적합합니다.
방법 6: 멀티모달 대형 모델 편집(예: GPT-4 Vision)
작동 방식: 최신 멀티모달 AI 모델(GPT-4V/4.5, ChatGPT 이미지 편집, OpenAI DALL·E 3 편집)을 사용해 고수준 명령 기반 이미지 편집을 합니다. 원본 이미지를 입력하고 자연어 프롬프트로 “디자인은 그대로 두고 텍스트를 번역”하게 합니다. 모델은 텍스트 감지, 의미 이해, 이미지 생성을 결합해 레이아웃 요소와 스타일을 보존하면서 단어를 바꿉니다. 흐름: 이미지 + 명령 입력 → 모델이 텍스트를 인식하고 번역 → 모델이 새 이미지 생성 → 사람이 교정.
도구: OpenAI ChatGPT(GPT-4V 등 이미지 기능 포함), DALL·E 3 이미지 편집 API, Google Imagen Editor(주로 연구 단계), 그리고 OpenAI API를 통한 개발자 접근.
입력 / 출력: 입력은 이미지와 텍스트 프롬프트; 출력은 새 이미지(대개 원래 해상도 또는 지정한 해상도).
자동화: 높음. 간단한 프롬프트면 충분하고 나머지는 모델이 처리합니다.
정확도 및 보존도: 대체로 높음. 이런 모델은 레이아웃 관계와 스타일을 잘 보존합니다. OpenAI 공식 예시는 커피 머신 설명 도해를 레이아웃을 유지한 채 스페인어로 번역하는 것을 보여 주고, Atlas Cloud는 GPT-4V가 인포그래픽 텍스트를 다른 언어로 번역하면서 나머지 모든 것을 그대로 유지한다고 보고합니다. 그래도 일부 텍스트를 놓치거나 작은 어긋남이 생길 수 있습니다 — 특히 번역문 길이가 원문과 크게 다를 때 — 그래서 후속 수정이 필요할 수 있습니다.
시간 및 비용: 중간. 이미지 한 장 생성에 보통 몇 초에서 수십 초가 걸리지만, 고급 모델은 API 또는 구독 비용이 드는 서버 호출이 필요하며, 프롬프트 작성과 결과 검토에 드는 시간도 더해집니다.
장단점: 원클릭으로 번역된 이미지를 얻는 친화적인 경험이 장점이고, 복잡한 배경에서 시각적 관계(화살표, 범례, 레이아웃 계층)를 보존합니다. 하지만 세밀한 통제가 제한적이라 — 맞춤법 오류, 번역되지 않은 텍스트, 사람의 눈이 필요한 합성 아티팩트를 예상해야 합니다. 아직 정밀 조판을 대체할 수는 없지만 대부분의 마케팅 시나리오에서는 좋은 성능을 냅니다.
적합한 용도: 인포그래픽, 포스터, 삽화형 홍보물의 빠른 현지화. 예를 들어 ChatGPT에 영어 광고 이미지와 “모든 텍스트를 중국어로 번역하고 다른 것은 바꾸지 마”라는 프롬프트를 주면, 모델이 해당 언어의 이미지를 생성합니다.
그림: GPT-4V 멀티모달 번역 예시(왼쪽: 한국어 입력, 오른쪽: 베트남어 출력).
방법 7: 심층 확산 모델 편집(DALL·E, Stable Diffusion)
작동 방식: 확산 기반 이미지 편집은 원본 이미지에서 텍스트 영역을 마스킹한 뒤, 프롬프트로 대체 콘텐츠를 생성합니다. 일반적인 흐름: 텍스트 감지 및 마스크 생성 → 프롬프트 설계(예: “X를 Y로 바꾸고 배경은 그대로 유지”) → DALL·E 3 또는 Stable Diffusion Inpainting으로 채우기 → 새 이미지 얻기. 예를 들어 원본과 텍스트 마스크를 OpenAI API에 업로드한 뒤 “replace text” 편집 요청을 보냅니다.
도구: OpenAI DALL·E 3 편집 API, Adobe Firefly Generative Fill, HuggingFace Diffusers(예: runwayml/stable-diffusion-inpainting). ControlNet 텍스트 감지, LaMa 인페인팅 같은 제어 기능이 교체할 영역을 표시하는 데 도움이 됩니다.
입력 / 출력: 입력은 원본 + 텍스트 마스크 + 프롬프트; 출력은 이미지 파일. 모델은 보통 번역문 언어와 스타일을 자동으로 맞춥니다.
자동화: 중간에서 높음. 마스킹 단계에는 추가 도구가 필요하지만(손으로 그리거나 프로그램으로 생성), 생성 자체는 원클릭입니다.
정확도 및 보존도: 높지만 전용 텍스트 편집 모델보다는 약간 낮습니다. 확산 모델은 긴 텍스트에서 자주 부정확하며(단어가 끊길 수 있음), 스타일 일관성은 프롬프트 품질에 달려 있습니다. 강점은 배경 복원으로, 번역문을 복잡한 질감에 자연스럽게 녹여 넣을 수 있습니다. 약점은 때때로 불완전한 글자 형태, 약간의 흐림, 원하지 않는 디테일입니다. 최상의 결과에는 조정된 마스크와 프롬프트가 필요합니다.
시간 및 비용: 중간. 이미지 한 장 생성에 보통 10초에서 수십 초가 걸립니다(로컬 GPU 환경에서는 달라짐); 클라우드 서비스는 대기 시간이 더해집니다.
적합한 용도: 창의적 번역 — 컨셉 아트, 삽화 속 슬로건 — 그리고 약간의 스타일 변화가 허용되는 모든 경우. 아래 예시에서 Stable Diffusion은 영어 배너 “Summer sale — 30% off everything”을 독일어 “Sommer-Sale — 30 % auf alles”로 번역하고, 배경을 그대로 유지한 채 다시 렌더링했습니다.
그림: Stable Diffusion 텍스트 교체 예시(왼쪽: 원본 영어 배너, 오른쪽: 독일어 결과).
방법 8: 맞춤형 컴퓨터 비전 + 스크립트 파이프라인
작동 방식: 완전히 자체 구축한 자동화 파이프라인입니다. 컴퓨터 비전으로 텍스트 영역을 감지하고(예: OpenCV 엣지/윤곽선 감지 또는 딥 OCR 모델), 기계 번역 API와 결합한 뒤, 이미지 라이브러리(Pillow/OpenCV)로 번역문을 원본 이미지 위에 그립니다. 단계: 텍스트 감지 → 상자별 OCR 및 번역 → 텍스트 영역의 배경을 오려내고 채우기(인페인팅 알고리즘 사용) → 새 텍스트 그리기 → 출력.
도구: Python(Pillow, OpenCV, EasyOCR, pytesseract, Baidu 또는 Google Translate API), Adobe PixelSense, C#/.NET 이미지 처리 등.
입력 / 출력: 입력은 일반 비트맵; 출력은 동일 해상도의 비트맵. 전체 흐름은 자체 구축 또는 스크립트 방식이며 기성 GUI가 없습니다.
자동화: 높음(스크립트를 잘 만들 경우). 완전 배치 처리가 가능합니다.
정확도 및 보존도: 알고리즘 세부 사항에 달려 있습니다. 레이아웃은 대략 맞출 수 있지만 보통 폰트를 자동으로 맞추지 못합니다 — 가장 가까운 것을 손으로 골라야 합니다. 또한 확산 모델만큼 배경을 매끄럽게 복원하지 못하며, 흔히 단색이나 인접 영역 평균으로 빈 곳을 채우고, 복잡한 배경이나 비표준 폰트에서는 제한적입니다.
시간 및 비용: 개발 비용이 높고(프로그래밍 필요), 실행 시간은 OCR과 그리기 효율에 달려 있습니다(이미지당 몇 초). 서드파티 서비스와 비교하면 금전적으로는 무료지만 코딩 노력이 많이 듭니다.
장단점: 파이프라인을 완전히 통제할 수 있고 배치 자동화에 좋지만, 디자인 디테일 보존도는 전용 AI 도구에 못 미치며 파라미터 조정과 사후 수정이 필요합니다. 심층 커스터마이징이나 데이터 프라이버시 시나리오(공용 네트워크 미사용)에 맞습니다.
적합한 용도: 특별한 프로세스 요구가 있는 기업 환경, 또는 소규모의 단순 라벨 교체 — 예를 들어 판매자가 제품 이미지 라벨을 OCR하고 번역해 다시 쓰는 흐름을 스크립트로 작성하는 경우. 기술적으로 까다롭지만 유연합니다.
방법 9: 전문 인력 + DTP 서비스
작동 방식: 번역 및 디자인 팀에 외주를 줍니다. 전문 번역가가 먼저 텍스트를 번역하고, 데스크톱 퍼블리싱(DTP) 디자이너가 원본을 기준으로 단계별로 교체합니다. 여기에는 소스 파일(PSD/InDesign) 식별 및 편집 → 텍스트 번역 → 동일한 소프트웨어에서 레이아웃 조정 및 재렌더링이 포함됩니다.
도구: 보통 Adobe 제품군, InDesign, Illustrator. 업체는 용어 일관성을 유지하기 위해 CAT 도구(Trados, MemoQ)를 사용할 수 있지만, 최종 출력은 디자인 소프트웨어에 달려 있습니다.
입력 / 출력: 입력은 모든 이미지 또는 소스 파일; 출력은 대개 고품질의 현지화 이미지 또는 편집 가능한 파일.
자동화: 낮음. 모든 단계에서 인간의 개입이 필요한 완전 수작업 서비스입니다.
정확도 및 보존도: 최고. 번역가와 디자이너가 문화적 뉘앙스에 맞게 텍스트를 조정하면서 디자인을 정밀하게 보존하거나 조정할 수 있고, 출력 품질은 전문가가 보장합니다.
시간 및 비용: 최고. 비용은 번역료와 디자인 시간이 합쳐지며, 보통 기계 방식보다 훨씬 많습니다. 고가치 프로젝트나 매우 민감한 콘텐츠에 적합합니다.
장단점: 최상급 품질과 신뢰성, 다만 비용과 시간 부담이 어떤 자동화 방법보다도 훨씬 큽니다.
적합한 용도: 브랜드 이미지 캠페인, 주요 전시회 자료, 정부 또는 법률 문서의 이미지 콘텐츠, 사람의 교정이 필요한 현지화 출판물.
방법 10: 벡터 / 소스 파일을 통한 자동 번역
작동 방식: 원본 이미지가 벡터나 디자인 소프트웨어에서 나왔다면, 디자인 환경 안에서 텍스트를 교체할 수 있습니다. 예를 들어 InDesign이나 Illustrator의 플러그인이나 스크립트로 OCR 또는 자동 변환을 통해 텍스트를 추출하고, 번역한 뒤 텍스트 프레임에 다시 삽입합니다. 또는 이미지를 PDF로 변환하고 OCR 번역한 뒤 다시 가져올 수도 있습니다.
도구: Adobe Acrobat(OCR + Word로 내보내기), Illustrator의 텍스트 찾기 및 바꾸기 기능, InDesign 스크립트, 또는 서드파티 플러그인(Lokalise, Transifex의 InDesign 플러그인 등).
입력 / 출력: 입력은 대개 편집 가능한 문서 또는 PDF; 출력은 원본 파일에서 텍스트를 직접 교체한 결과.
자동화: 중간. 소프트웨어의 자동화 및 스크립트 지원에 달려 있습니다.
정확도 및 보존도: 높음. 소스를 직접 편집하기 때문에 모든 레이어와 효과가 보존됩니다 — 원본 파일이 있는 경우에 한해. 이미 평탄화된 이미지라면 OCR의 도움이 필요하고 방법 2처럼 동작합니다.
시간 및 비용: 중간. 자동 교체 후에도 사람의 미세 조정이 필요합니다.
장단점: 소스 파일에서 정밀하게 조판할 수 있지만, 원본 편집 가능 파일과 적절한 소프트웨어가 있어야 합니다.
적합한 용도: 디자인 소스를 보유한 번역 프로젝트 — 예를 들어 InDesign으로 조판한 매뉴얼 번역 — 또는 긴급 상황에서 OCR로 대략 번역한 뒤 소스 파일에서 다듬는 경우.
나란히 비교하기
| 방법 | 디자인 보존도 | OCR / 인식 | 다국어 지원 | 기술 난이도 | 비용 | 속도 | 최적 용도 |
|---|---|---|---|---|---|---|---|
| 1. 전문 디자인 소프트웨어(수동) | 매우 높음 | N/A(인간) | 제한 없음 | 높음(디자이너 필요) | 최고(인건비) | 느림(수동) | 고사양 브랜드 / 마케팅 자산 |
| 2. OCR + 조판 | 높음 | 높음(구조화된 텍스트) | 다양함 | 중상(소프트웨어/스크립트) | 낮음(오픈 소스) | 중간 | 기술 문서, 라벨 도해, 구조화된 차트 |
| 3. 문서 번역 서비스 | 높음 | 높음(전문 OCR) | 매우 다양함 | 낮음(턴키) | 중상(서비스 요금) | 빠름 | 대량 PDF/스캔본, 전문 문서 |
| 4. 온라인 AI 도구(ReWords 등) | 높음 | 높음(AI) | 다양함 | 낮음(턴키) | 낮음/중간(무료 + 유료) | 빠름 | 이커머스 포스터, 만화, 일상적 다중 이미지 현지화 |
| 5. 휴대폰 카메라 앱 | 낮음 | 중상(휴대 촬영) | 다양함 | 매우 낮음(턴키) | 낮음(무료) | 실시간 | 여행 / 일상에서 빠른 읽기 |
| 6. 멀티모달 대형 모델 편집 | 높음 | 높음(모델) | 매우 다양함 | 낮음(턴키) | 중상(API 요금) | 중간 | 빠른 추론이 필요한 인포그래픽, 광고 포스터, UI 스크린샷 |
| 7. 확산 모델(DALL·E 등) | 중상 | 중간(마스크 필요) | 다양함 | 중간(프롬프트 기술) | 중간(API/연산) | 중간 | 창의적 디자인, 스타일 요건이 관대한 경우 |
| 8. 맞춤형 Python 파이프라인 | 중간 | 중간(도구 의존) | 다양함 | 높음(프로그래밍) | 낮음(오픈 소스) | 유연(배치 자동) | 자동화 환경(기업 맞춤, 대량 처리) |
| 9. 전문 인력 + DTP | 매우 높음 | N/A(인간) | 제한 없음 | 매우 높음(전문 팀) | 최고(서비스 요금) | 매우 느림(수동) | 고급 출판물, 엄격한 텍스트/형식 요건 |
| 10. 소스 파일 직접 번역 | 매우 높음 | 높음(소스에서) | 다양함 | 중간(디자인 소프트웨어) | 낮음(기존 소프트웨어) | 중간 | 편집 가능 소스가 있는 프로젝트(InDesign 도서, 보고서 번역) |
주: 여기서 “보존도”는 번역된 이미지가 원래 디자인과 얼마나 일치하는지를 뜻합니다. 휴대폰 앱은 이해를 위한 것이고 큰 마스크를 덧씌우므로 보존도가 낮고, 전문 디자인과 문서 번역 서비스는 레이아웃과 폰트를 완전히 보존하므로 점수가 높습니다.
세 가지 엔드투엔드 튜토리얼
버튼을 누르는 것보다 더 깊이 들어가고 싶다면, 배울 가치가 있는 세 가지 접근법이 있습니다. 각각 전체 흐름과 실제 작동하는 코드를 포함합니다.
튜토리얼 1: GPT-4 Vision 멀티모달 편집
개요: 이 예시는 OpenAI의 이미지 기능이 있는 GPT-4(또는 DALL·E)를 사용해 이미지 안의 텍스트를 편집하는 방법을 보여 줍니다. 준비: OpenAI에 등록하고 API 키를 발급받습니다. 텍스트가 있는 샘플 이미지와 일치하는 마스크를 준비합니다. 영어 “Summer sale”을 중국어 “夏季特卖”로 번역한다고 가정합니다.
흐름: 원본 이미지 입력 → GPT-4V 또는 DALL·E 편집 엔드포인트 호출 → 모델이 텍스트를 인식하고 번역 → 모델이 새 이미지 생성 → 다운로드 및 교정.
- 이미지와 마스크를 준비합니다. 원본(
orig.png)과 마스크(mask.png)가 정렬되어 있고, 마스크가 “Summer sale” 텍스트 영역만 덮도록 합니다. - API를 호출합니다(OpenAI Python SDK를 예로 듦):
```python import openai openai.api_key = "YOUR_API_KEY"
모델에게 마스크된 영역의 텍스트를 중국어로 번역하되
나머지는 그대로 두라고 요청합니다.
response = openai.Image.create_edit( image=open("orig.png", "rb"), mask=open("mask.png", "rb"), prompt="用中文翻译上面的文字,不改变其他内容。", n=1, size="1024x768" )
반환된 이미지를 디스크에 저장합니다.
with open("output.png", "wb") as f: f.write(response['data'][0]['image']) ```
이것은 모델에게 마스크된 영역의 텍스트를 중국어로 번역하고 나머지는 그대로 두라고 지시한 뒤 결과를 생성하게 합니다.
- 출력을 검토합니다.
output.png를 확인합니다. 모델이 “Summer sale”을 “夏季特卖”로 교체했을 것이며, 폰트 스타일은 유사하고 배경은 동일해야 합니다.
그림: GPT-4V 번역 예시(왼쪽: 원본 한국어, 오른쪽: 베트남어로 된 모델 출력).
- 결과를 저장합니다.
output.png를 사용하고, 필요하면 이미지 편집기에서 텍스트 위치나 스타일을 미세 조정합니다.
주의사항: GPT-4V가 생성한 텍스트는 항상 교정하십시오. 누락된 것이 있으면 더 상세한 프롬프트를 시도하거나 더 작은 블록으로 나눠 번역하십시오. OpenAI API는 이미지 크기와 생성 횟수로 과금됩니다.
튜토리얼 2: 온라인 AI 도구(ReWords / EditTextImage)
개요: ReWords 앱이나 유사한 사이트를 사용해 이미지를 번역합니다 — 이 예시에서는 ReWords. 준비: ReWords나 EditTextImage 같은 온라인 도구를 엽니다. 설치가 필요 없습니다.
흐름: 원본 업로드 → 시스템이 OCR로 텍스트 감지 → 자동 번역 후 제안 텍스트 표시 → 텍스트 조정 및 유지할 부분 잠금 → AI가 새 이미지 렌더링 → 번역된 이미지 다운로드.
- 이미지를 업로드합니다. ReWords 사이트를 열고 “Translate Text in Image” 기능을 선택한 뒤 번역할 사진(여기서는 “SUMMER SALE”이 들어간 광고)을 업로드합니다.
- 언어를 고르고 편집합니다. 플랫폼이 모든 텍스트 줄을 감지하고, 대상 언어(예: 중국어)를 고르면 줄 단위 제안을 돌려줍니다. 오역을 수정하고 바뀌면 안 되는 단어(브랜드 이름 등)는 잠급니다.
- 이미지를 생성합니다. Generate 또는 Apply를 클릭하면 AI가 원문을 제거하고 원래의 폰트, 색상, 배경으로 번역문을 다시 그립니다.
- 결과를 다운로드합니다. 새 이미지를 다운로드합니다. 아래 예시에서 왼쪽은 원본 “SUMMER SALE” 이미지, 오른쪽은 ReWords가 생성한 “夏季特卖” 버전입니다.
그림: ReWords 이미지 번역 예시(왼쪽: 원본, 오른쪽: AI 번역 후).
팁: 이런 도구는 보통 무료 한도가 있으며(ReWords는 이미지당 몇 회의 무료 생성을 포함), 그 이상은 결제나 크레딧이 필요합니다. 번역 품질은 높지만 텍스트를 확인하는 것이 좋습니다 — 특히 숫자와 고유명사. 원본 디자인 파일을 구할 수 없고 이미지를 직접 현지화해야 할 때 이상적입니다.
튜토리얼 3: Python OCR + OpenCV 자동 번역
개요: 이미지에서 텍스트를 추출하고, 번역하고, 이미지에 다시 렌더링하는 스크립트입니다. Tesseract OCR과 OpenCV/Pillow를 사용해 스페인어 이미지를 영어로 번역합니다.
흐름: 원본 로드 → 텍스트 감지 및 OCR(Tesseract) → 번역 엔진 호출(Google Translate API) → OpenCV로 원문 영역 제거 → Pillow로 번역문 그리기 → 현지화 이미지 출력.
- 의존성을 설치합니다(먼저 Tesseract-OCR과 Python 라이브러리):
```bash
Tesseract 설치 (Ubuntu 예시)
sudo apt-get install tesseract-ocr
Python 라이브러리 설치
pip install pytesseract pillow googletrans==4.0.0-rc1 ```
- 스크립트:
```python from PIL import Image, ImageDraw, ImageFont import pytesseract from googletrans import Translator
원본 이미지 로드
image = Image.open("image_with_text.png")
OCR 실행 (스페인어 텍스트 인식)
text = pytesseract.image_to_string(image, lang='spa') print("Recognized text:", text)
텍스트 번역
translator = Translator() result = translator.translate(text, src='es', dest='en') print("Translation:", result.text)
이 예시에서는 텍스트 위치를 알고 있습니다. 실제 환경에서는
pytesseract.image_to_boxes를 사용해 문자별 상자를 얻습니다.
x, y, w, h = 50, 50, 300, 50 # 예시 좌표
이미지에서 원문 텍스트 지우기
draw = ImageDraw.Draw(image) draw.rectangle(((x, y), (x + w, y + h)), fill="white") # 흰색으로 덮기
번역된 텍스트 그리기
font = ImageFont.truetype("arial.ttf", size=36) draw.text((x, y), result.text, font=font, fill="black")
출력 저장
image.save("translated_image.png") ```
- 작동 방식: 스크립트는 먼저 Tesseract로 원본을 OCR하고, Google Translate(
googletrans)로 번역문을 가져온 뒤, Pillow를 사용해 원래 영역을 지우고 번역문을 그립니다. 이 예시는 하나의 고정된 영역을 처리합니다. 실제 애플리케이션은 OCR 결과로 영역을 동적으로 결정하고 폰트를 맞춥니다(여기서는 설명을 위해 단순화했습니다). - 출력: 실행하면
translated_image.png가 생성되며, 원래 텍스트 영역이 영어 번역문으로 대체됩니다.
주의사항: 이 흐름은 OCR 위치 정확도와 폰트 매칭 능력에 달려 있습니다. 실제로는 OpenCV 윤곽선 감지를 결합해 정밀하게 오려내고, Pillow로 텍스트 너비를 측정해 자동 줄바꿈을 적용하십시오. 여러 줄 텍스트는 각 세그먼트를 순회 처리합니다. 전체를 배치화할 수 있지만, 레이아웃 보존도는 AI 인페인팅 방식에 못 미치므로 테스트하고 파라미터 조정을 예상해야 합니다.
선택 방법: 결정 가이드
방법을 세 가지 기준에 맞추십시오 — 보존도, 비용, 그리고 소스 파일을 보유했는지 여부:
- 소스 파일이 없고 빠르게 원한다(가장 흔한 경우): ReWords AI 같은 온라인 AI 도구(방법 4)를 사용합니다. 업로드, 언어 선택, 생성, 다운로드.
- 이미지가 텍스트 중심이고 구조화되어 있다(차트, 매뉴얼, 도해): OCR + 조판(방법 2), 대량 작업에는 형식 보존 문서 서비스(방법 3).
- 결과가 인쇄 수준으로 완벽하고 브랜드에 중요하다: 수동 디자인(방법 1) 또는 전문 인력 + DTP(방법 9).
- 자신의 워크플로 안에서 자동화하고 싶다: 멀티모달 모델 API(방법 6) 또는 맞춤형 Python 파이프라인(방법 8).
- 읽기 위해 간단히 스냅샷을 번역하고 싶을 뿐이다: 휴대폰 카메라 앱(방법 5) — 하지만 게시용으로는 절대 사용하지 마십시오.
- 여전히 편집 가능한 소스 파일을 보유하고 있다: 직접 편집합니다(방법 10). 가능할 때 이것이 가장 깔끔한 경로입니다.
원본 디자인을 지키는 다섯 가지 원칙
어떤 경로를 택하든, 다음 습관이 “번역됨”과 “전문적으로 현지화됨”을 가릅니다.
- 텍스트 길이 변화를 대비하십시오. 독일어와 프랑스어는 보통 늘어나고, 중국어와 일본어는 줄어듭니다. 크기 조정, 줄바꿈, 자간 조정을 예상하고, 번역문이 원래 상자에 그대로 들어간다고 가정하지 마십시오.
- 단어가 아니라 폰트를 맞추십시오. 원래의 굵기, 색상, 자간, 그리고 획이나 그림자를 재현하십시오. 잘못된 서체의 완벽한 번역도 여전히 틀려 보입니다.
- 배경을 깨끗하게 재구성하십시오. 텍스트 뒤의 복원된 영역은 주변과 구별되지 않아야 합니다 — 가장자리를 페더링하고, 1:1 확대에서 이음새를 확인하십시오.
- 텍스트가 아닌 요소를 처리하십시오. 화살표, 콜아웃, 번호, 범례는 종종 텍스트를 담거나 가리키므로, 이들을 고려해 현지화 버전이 일관되게 유지되도록 하십시오.
- 번역문 자체를 교정하십시오. 기계 번역은 빠르지만 완벽하지 않습니다. 숫자, 단위, 브랜드 이름, 고유명사는 게시 전에 사람이 확인할 가치가 있습니다.
결론
이미지 속 텍스트를 번역하는 데 원본 디자인 파일은 필요하지 않습니다. 목표로 하는 보존도에 맞는 올바른 방법을 고르면 됩니다 — 그리고 대부분의 일상적인 이미지에서 그 방법은 텍스트를 읽고, 번역하고, 레이아웃을 흔들지 않은 채 제자리에 다시 그리는 원클릭 AI 도구입니다.
위험 부담이 크고 이미지가 복잡할 때는 더 무거운 도구 — 수동 디자인, 문서 서비스, 전문 DTP — 가 여전히 제 몫을 합니다. 그러나 대다수의 메뉴, 포스터, 제품 이미지, 소셜 그래픽은 몇 분 만에 현지화할 수 있습니다.
번역하려고 마음먹었던 이미지 하나를 골라 ReWords AI에 업로드하고, 수동 경로를 고려하기 전에 1분짜리 AI 번역이 디자인을 얼마나 충실히 보존하는지 먼저 확인해 보십시오.
References
- OpenAI 이미지 편집 및 DALL·E 편집 문서.
- 형식 보존을 적용한 PDF 및 이미지 번역 연구.
- OCR 추출과 디자인 워크플로 내 재배치에 관한 Atlas Cloud 보고.
- 온라인 이미지 번역 도구의 제품 문서(ReWords AI, EditTextImage 등).
- 맞춤형 파이프라인을 위한 Tesseract OCR, OpenCV, Pillow 문서.