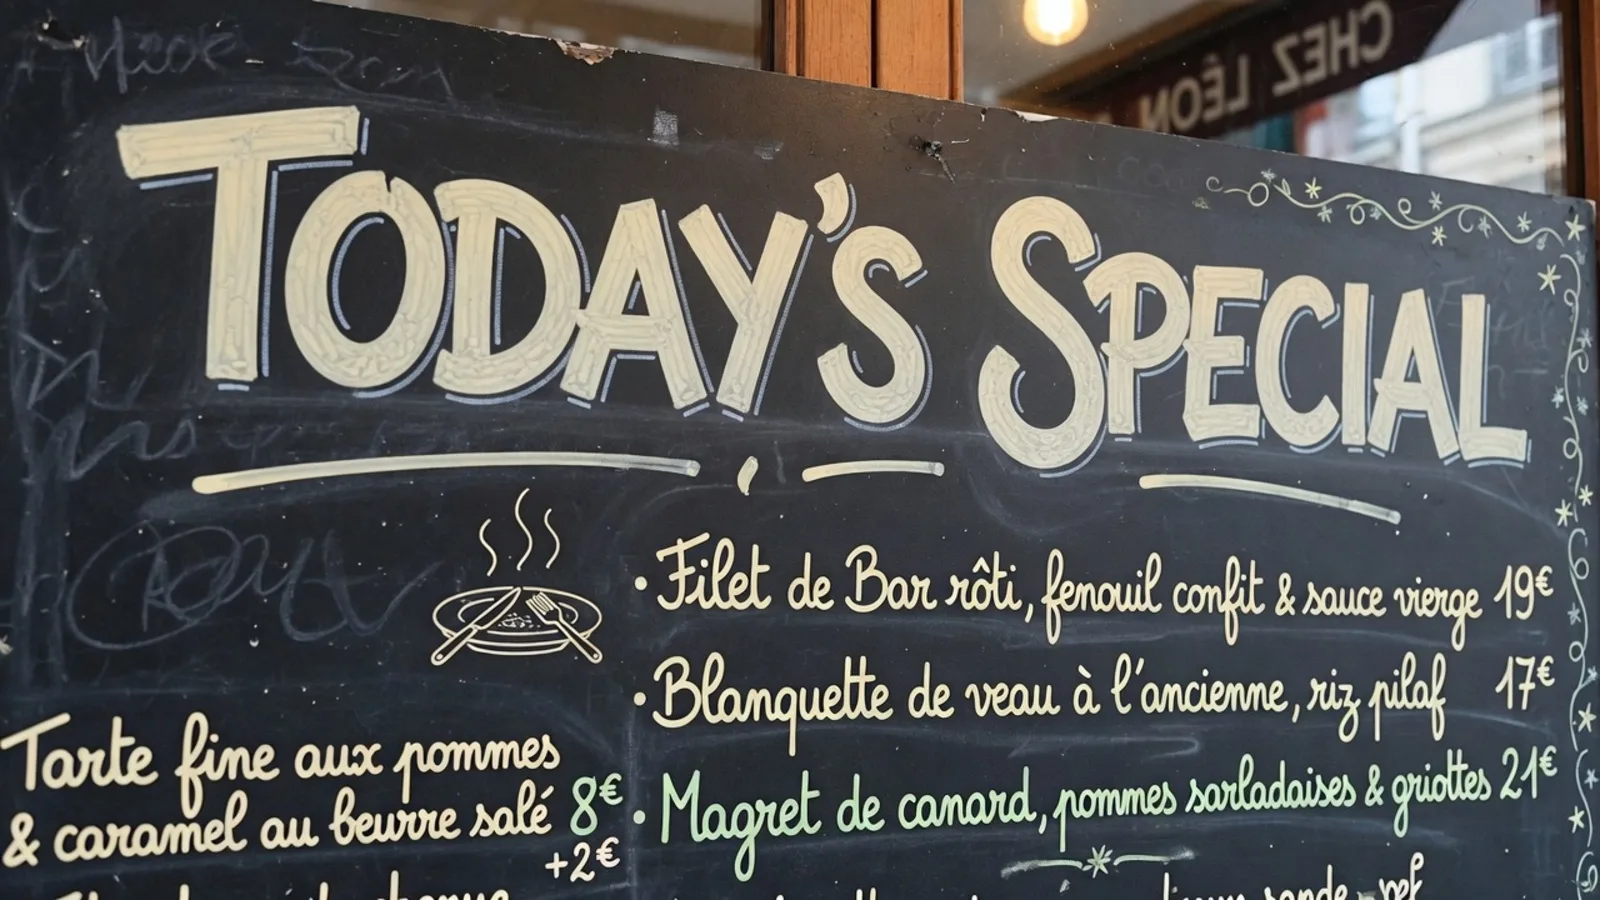
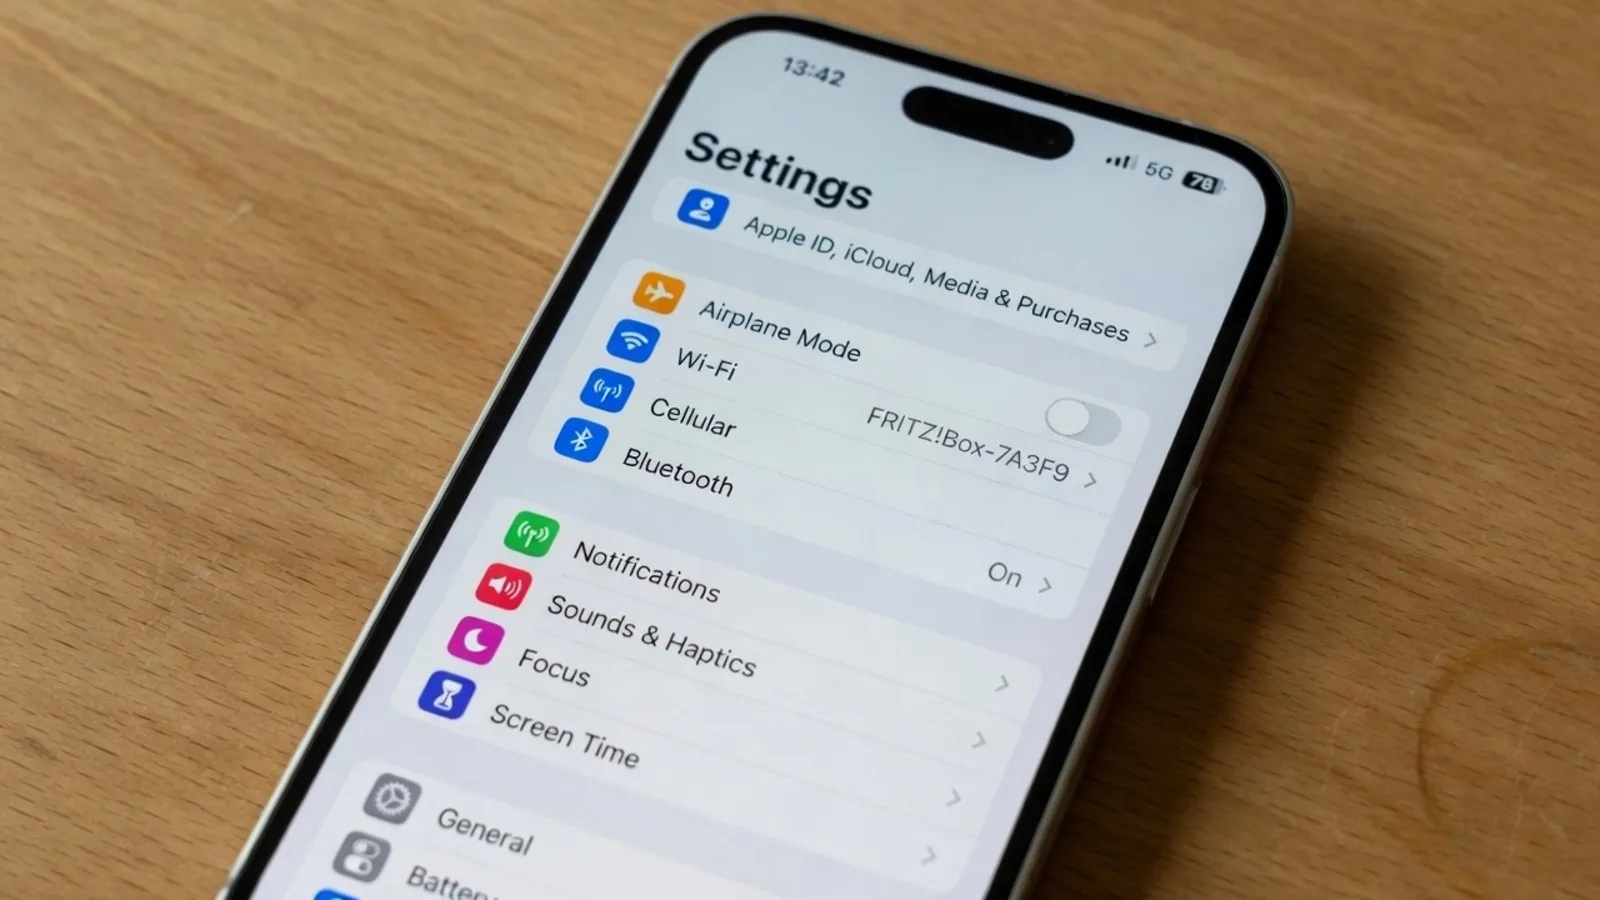
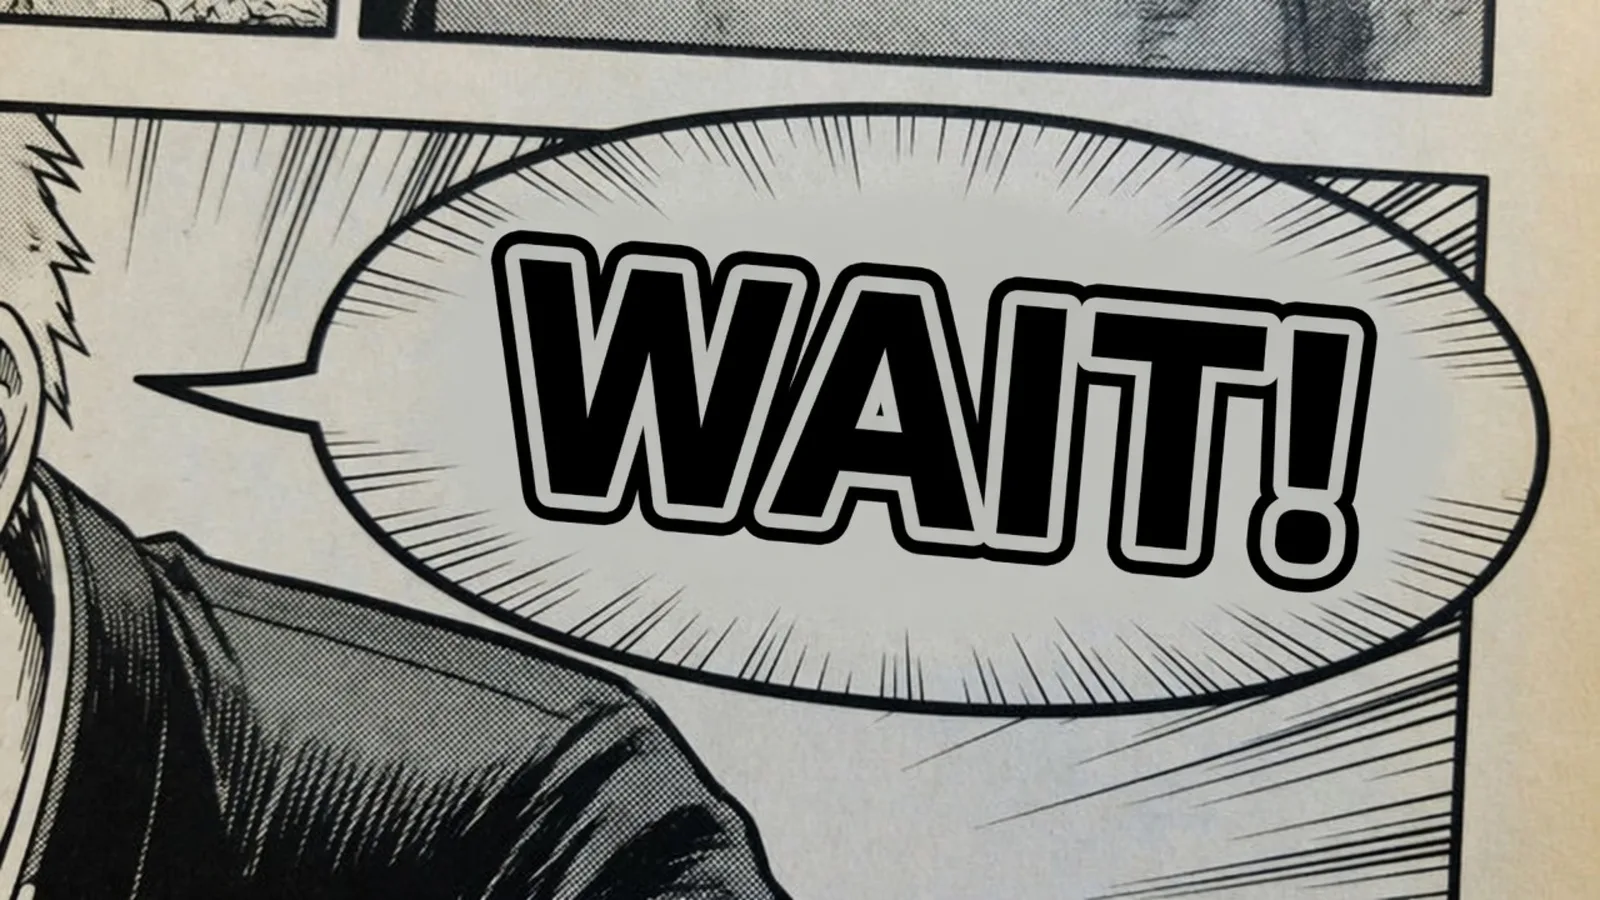
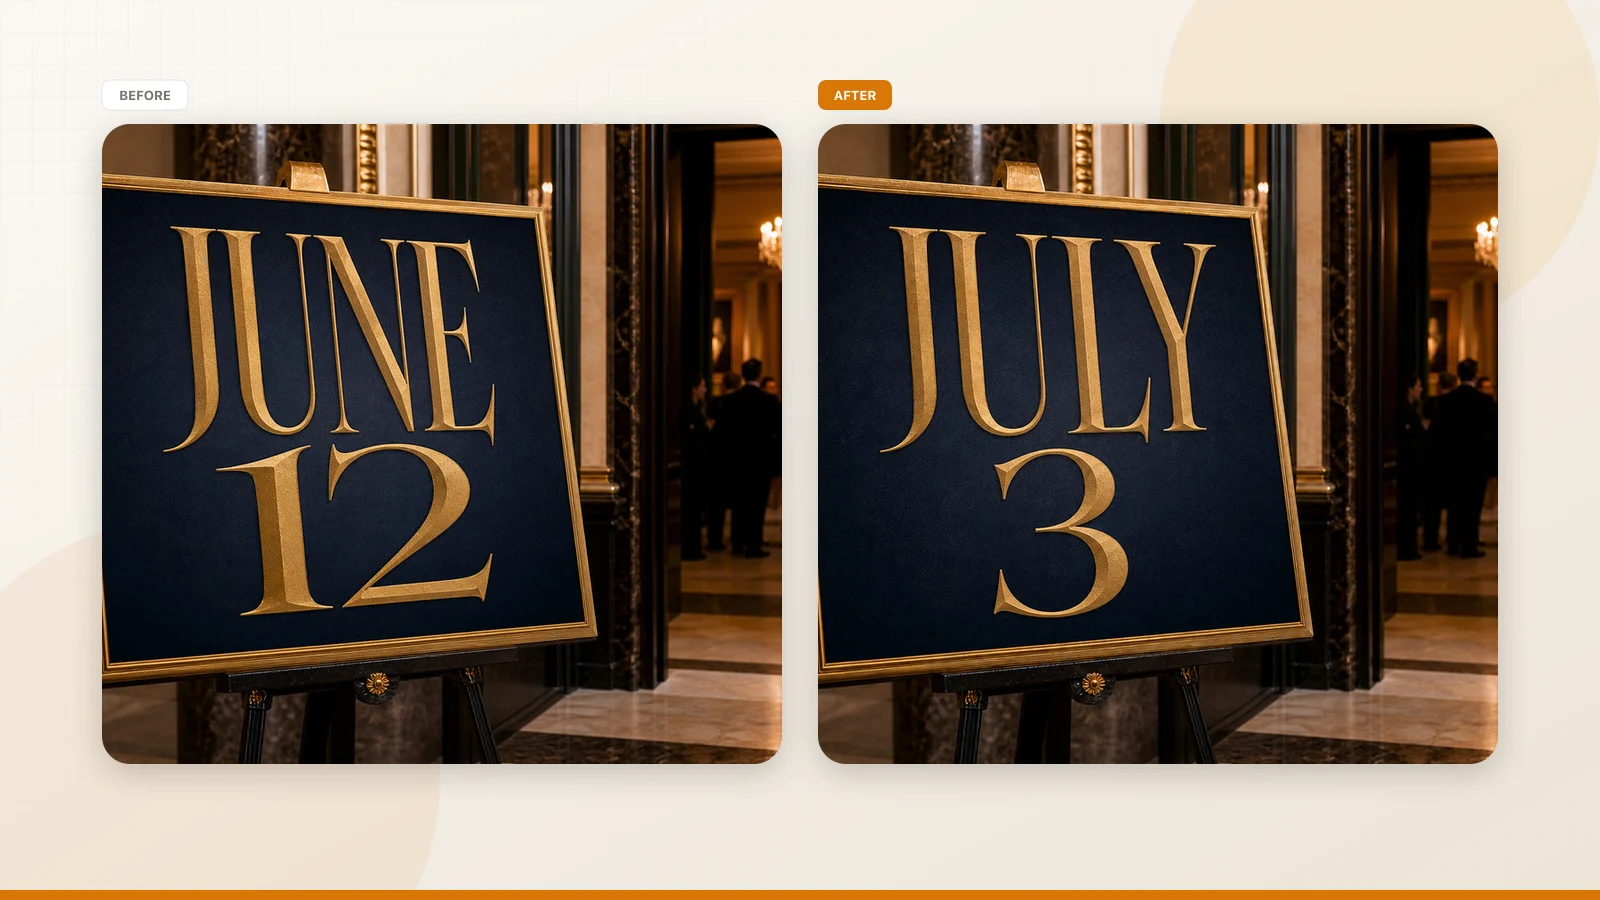
想在已经导出的图片里做本地化——一共十种方法,既能换掉文字,又能让版式、字体和背景保持设计师留下的原样。
一张英文活动海报,一份日文菜单,一张德文产品标签,一张西班牙语标注的技术图。你需要把它们换成另一种语言,而你手上只有导出的成品图片。
翻译一份文档很简单:把文字交给译者,拿回译文即可。但翻译图片里的文字完全是另一回事。你改的不只是词,而是在设计师的版式注视下,做一场像素级的手术——字体差一点、背景没对齐、译文比原文长了 30%,都会一眼被看出来。
这正是图片本地化最别扭的地方:你必须改变含义,却不能改变设计。 下面这份报告梳理了十种真实可行的做法,从纯人工设计到一键 AI,每一类都标明了保真度、成本和失败模式。
图片文字翻译
使用我们的免费在线图片翻译器自动翻译嵌入图片的原有文字并重绘视觉区域。用户可以在最终渲染前编辑译文行。完成登录后可获得有限试用积分,以便体验和测试图像翻译与重绘功能。
为什么翻译图片里的文字这么难
翻译文档时,版式是会伸缩的;而翻译被烙进图片里的文字时,版式被冻结在像素中。这一个约束,衍生出一连串问题:
文字长度会变。 一句简短的英文,翻成德语或法语可能膨胀 30% 以上,翻成中文或日文又会大幅收缩。原设计的空间是固定的,译文必须被重新适配——缩放、换行、调字距——同时不能破坏构图。
字体与样式必须匹配。 原字体、字重、颜色、字距,以及阴影、描边之类的效果都得复现。一旦不对,本地化版本摆在原作旁边就会显得「有点外来」。
背景必须重建。 擦掉原文字会毁掉它底下的像素。纯色背景很简单;换成照片、渐变或纹理,你就是在重建缺失的画面。
非文字元素也要照顾到。 箭头、标注、编号、图例往往本身带文字或指向文字,干净利落的本地化必须把它们一并考虑。
下面每一种方法,都是在上述四个问题之间做不同的权衡。选哪种,取决于结果需要多保真、图里文字有多少、以及你是否手握原始源文件。
最快的路径:在线 AI 图像翻译
在进入手动方法之前,先知道这条捷径存在——而且它是大多数人应该最先尝试的。
专门为这件事打造的在线 AI 工具,比如 ReWords AI,把文字检测、机器翻译和 AI 图像补全揉进了一条流程。它不会在图上再叠一个文字框,而是检测图片里已有的文字、翻译它、擦掉原文、重建背景,再用匹配的字体、颜色、字号把译文重绘进去——版式原封不动。
操作流程:
- 上传图片。 打开工具,选择「Translate Text in Image」功能,上传要翻译的图片(示例是一张带「SUMMER SALE」横幅的广告图)。
- 选择语言并编辑。 平台会自动识别每一行文字。选定目标语言后,它会给出逐行翻译建议,你可以手动修正,并把不能改的词(如品牌名)锁定。
- 生成图像。 点击 Generate 或 Apply,AI 会去掉原文,并依据原字体、颜色、背景重绘译文。
- 下载结果。 检查并下载本地化后的图片。
图:在线 AI 翻译示例(左:原图,右:翻译后)。
为什么它是默认首选: 不需要原始设计文件、不需要安装软件、不需要设计技能。一张普通图片几秒到一分钟就能返回。这类工具通常都带免费额度(ReWords 每张图提供数次免费生成),超出后按付费或积分计。
需要留神的地方: 译文本身值得复核——尤其是数字和专有名词;而文字过密、光影复杂或字体极度装饰化时,AI 的重绘偶尔会出瑕疵。同时要留意版权与敏感信息的处理。
最贴合的真实场景: 电商商品图、本地化的广告与社媒图、菜单、传单、漫画——这些日常的本地化任务里,你早就没有原始文件了。
完整工具箱:不破坏设计翻译图片文字的十种方法
如果图片复杂、要求高,或者你想自建流水线,下面这十种做法值得了解。每一种都列出了原理、所需工具、保真度,以及它适合谁。
方法一:人工设计编辑(Photoshop / Illustrator)
原理/流程: 由专业设计师手工完成。先用 OCR 或人工抄录得到图中文字并翻译,然后在 Photoshop、Illustrator 等软件里,用相匹配的字体和样式把译文重新排版、覆盖在原文字区域上。流程为:文本提取 → 翻译校对 → 寻找或制作相同字体 → 图形软件中删除原文、插入译文并调整效果。
工具: Adobe Photoshop、Illustrator、InDesign、GIMP、Figma;OCR 工具(如 Tesseract)可辅助提取文字。
输入输出: 输入为任意图片格式(PNG/JPEG);输出为带译文的新图片(同格式),或可图层编辑的 PSD/AI 文件。
自动化程度: 低。主要靠人工,自动化仅存在于 OCR 提取环节。
准确率/保真度: 最高。设计师可完全控制字体、位置和样式,能像素级复刻原始设计。保真度取决于人工水平,耗时长,且对译文长度膨胀很敏感。
时间成本: 高。一次专业修改可能需数分钟到数小时,依图像复杂度而定,软件本身也有学习成本,翻译量大时效率很低。
优缺点: 优点是完整保留布局与风格(理论上可做到无差别替换),适合高要求的营销物料与品牌文案;缺点是耗时、昂贵、易出错,且必须有相同字体,否则难以完全一致。
典型场景: 广告海报、包装设计、UI 原型、印刷宣传品等需要高保真本地化的场合。
引用案例:Atlas Cloud 指出,OCR 提取文本后仍需人工「将该文本放回设计中」,而纯图像编辑则是在新的光栅图层上合并修改,对单个字母的控制更少——可见手动排版虽费时,却最为精准。
方法二:OCR + 设计软件排版
原理/流程: 自动化程度略高的半自动流程。先对图片做文字识别(OCR),提取各文本框的内容与位置;再通过机器翻译或人工翻译得到译文;最后用排版软件(如 InDesign、Illustrator)或脚本,把译文按原文字的位置和样式重新渲染到图上。流程为:OCR 文本识别 → 文本翻译 → 版式重建 → 输出图像。
工具: OCR 库/软件(Tesseract、EasyOCR、Adobe Acrobat OCR);翻译 API(Google Translate、DeepL、百度翻译等);排版软件(Adobe InDesign、Photoshop,或编程环境中的 Pillow/Matplotlib)。
输入输出: 输入图片格式不限(PNG/JPEG),输出为新图片。中间可借助矢量文档(PDF/AI)来保持布局。
自动化程度: 中等。OCR 和翻译可以自动完成,但最后的排版常需人工辅助——尤其中外文长度差异大时,要手动调整字号、行距。
准确率/保真度: 较高。若能匹配字体与框架位置,布局可得到较好保留。但译文的膨胀可能打破原始空间分布,需要缩放或换行;复杂图形下的定位误差也会影响保真度。
时间成本: 中等。OCR 与翻译的自动化部分较快(秒到分钟),后续排版调整需几分钟到十几分钟。
优缺点: 比纯手工快,但依赖 OCR 准确度和字体匹配效果,字距、连写等细节可能有细微差别。适合文字多、设计又有要求的场景。缺点是处理不了图中的非文字元素(指向线、编号等需人工处理)。
典型场景: 图表说明、技术手册、教育图示等多文本元素图像的本地化。
背景:PDF 翻译工具通常遵循这类思路——先解析文档结构,再逐区翻译后「原位替换文本、保留布局输出」。同理,对图片做 OCR 与逐块翻译,就能得到原位替换的译文。
方法三:专用文档翻译服务(格式保留型)
原理/流程: 利用企业级或在线「格式保留翻译」服务。这类工具先解析输入文件或图片中的版式与字体,再对每个文本块做机器翻译,最后重新排版输出。关键步骤:布局解析(识别文本框坐标、字体)→ 文本翻译(云译服务或本地 MT)→ 布局重建与渲染 → 输出文件。图片部分通常原样保留。
工具: 在线平台或商用软件,如 PDFTranslator(Gemini + ChatGPT 引擎)、Pangeanic ECO 平台、Pairaphrase、Smartcat 等。它们多支持 PDF/图片输入,输出保留原样式的 PDF 或图文。
输入输出: 可输入扫描件、图片或 PDF(JPG/PNG/PDF);输出为翻译后的同格式文件,布局、表格、图形位置基本无损。
自动化程度: 高。全流程由系统自动完成,只需少量人工校对。
准确率/保真度: 较高。先进服务采用高精度 OCR 加专用 LLM/翻译系统,实现文字与格式的「坐标级精准映射」。布局与字体可完整保留(文档级保真度可达 90%+),误差主要来自译文长度差异。
时间成本: 低。翻译速度快,多数任务秒级或分钟级完成(例如 60 页 PDF 几分钟内搞定)。但通常为收费服务,或需购买 API 配额。
优缺点: 优势是自动化程度高、省时、保真度好;缺点是对接口费用敏感(大批量或长文档需付费),对特殊版式或手写文字支持有限。适合批量文档或图片翻译。
典型场景: 企业多语言技术文档、产品手册、培训资料、财务报表等需要忠实保留版式的场合。本质上,这类系统也是「OCR + 翻译 + 自动排版」的流水线。
方法四:在线 AI 图像翻译工具
原理/流程: 使用专门的 AI 服务或软件,直接对图片内文字自动翻译并就地修改,常结合深度学习自动「掩膜遮挡 + 内容重绘」。流程通常是:上传原图 → 自动 OCR 识别文本区域 → 自动翻译并可人工校对 → AI 模型将原文字去除,并用译文及相似字体风格重新「绘制」进去 → 生成新图并下载。 这类工具把 OCR、MT 和图像补全结合在一起,一键完成翻译。
工具: ReWords AI、ImageGPT、EditTextImage、Codia、VisualGPT 等。界面通常允许锁定不动的文字行,并编辑建议译文。
输入输出: 输入为普通位图(PNG/JPEG);输出为同分辨率的位图,译文以原始风格呈现。
自动化程度: 高。整个过程只需上传并点击「生成」,中间步骤由 AI 完成。
准确率/保真度: 整体较高。现代生成模型能较准确地匹配字体样式与背景纹理,实现「看不出修改」的效果;但文字太密、光影复杂或字体极度装饰化时偶有瑕疵。OCR 准确度取决于源图质量;机器翻译多为神经网络,质量良莠不齐,需要人工复核。
时间成本: 低至中等。多数在线工具数秒至一分钟内返回(可能限制免费次数),无需本地安装,对非技术用户友好;大批量则需付费或消耗积分。
优缺点: 优点是使用方便、效率高,不需要原始设计文件即可在图片上直接替换文字;缺点是生成质量依赖 AI,有时需要反复尝试或精调提示。此外,版权或敏感信息须谨慎处理。
典型场景: 电商商品图、本地化广告与社媒图、菜单、传单、漫画等日常图片翻译需求。比如 ReWords 展示了把产品包装上的「SUMMER SALE」替换为「夏季特卖」而背景一致的效果;EditTextImage 也给出把「Summer sale — 30% off everything」翻成德文「Sommer-Sale — 30 % auf alles」且版式不变的示例。这些都是典型的本地化场景。
图:在线 AI 工具翻译示例(左:原图,右:翻译后)。
方法五:手机即时翻译应用
原理/流程: 用手机端的图像翻译 APP(如谷歌翻译、百度翻译摄像头模式、Microsoft 翻译)翻译拍摄或导入的图片。这些 APP 大多实时识别并在屏幕上覆盖译文,或生成带译文的图片快照。流程:拍照/导入图片 → 自动 OCR 识别 → 自动翻译 → 覆盖或标记原文 → 查看结果。
工具: Google Translate APP、百度翻译摄像头、微信内置翻译(扫描)等。
输入输出: 输入为手机拍摄的照片或截图;输出通常为覆盖显示的图像或译文文本。有些提供带标注图片的保存功能。
自动化程度: 全自动。无需用户输入文本,操作简单。
准确率/保真度: 低。主要目的是帮助理解,译文往往采用系统默认字体和背景遮罩,覆盖区域较粗糙,版式与样式完全不保留。OCR 和翻译质量接近专业工具,但输出不能直接用作正式发布的设计文件。
时间成本: 极低。实时翻译,一般几秒完成。
优缺点: 优点是方便快捷、无需专业知识,日常使用足够;缺点是不能保留原图设计,还会加上 logo 或水印,输出仅供阅读参考,不适合作为最终出版物。
典型场景: 个人旅行或日常生活中快速理解外文菜单、路牌、说明书等。有些用户用百度翻译拍照后保存图片,但会出现工具商标或贴片遮挡。这类工具更适合「阅读辅助」而非正式本地化。
方法六:多模态大模型编辑(如 GPT-4 Vision)
原理/流程: 利用最新的多模态 AI 模型(GPT-4V/4.5、ChatGPT 图像编辑、OpenAI DALL·E 3 编辑等)做高层指令式图像编辑。你把原图输入模型,用自然语言提示让它「翻译文字、保持设计不变」。模型内部结合文本检测、语义理解与图像生成,在改字的同时尽量保留版面元素和风格。流程:输入原图 + 指令 → 模型识别文字并翻译 → 模型生成新图 → 人工校对。
工具: OpenAI ChatGPT(含 GPT-4V 等图像能力)、DALL·E 3 图像编辑 API、Google Imagen Editor(目前主要处于研究阶段)等;开发者可通过 OpenAI API 调用。
输入输出: 输入为图片加文字提示;输出为新图像(通常与原分辨率相同,或可指定)。
自动化程度: 高。只需简单提示词,模型自动完成修改。
准确率/保真度: 一般较高。这类模型对版式关系和风格有较强的保持能力。例如 OpenAI 官方示例展示了把咖啡机说明图翻译成西班牙语而保留布局;Atlas Cloud 报道 GPT-4V 能把信息图中的文字翻译为他语、同时保持其他内容不变。但仍可能漏译部分文字或出现微小偏移,尤其当译文长度与原文差异较大时,需要后续修正。
时间成本: 中等。生成一张图片通常数秒到十几秒;但高级模型需通过服务器调用,对应 API 费用或订阅成本。用户还需投入提示词编写与结果审查的时间。
优缺点: 优点是体验友好,可一键输出完整的翻译图;能在复杂背景中保留视觉关系(箭头、图例、布局层级)。缺点是对细节控制有限,可能出现拼写错误、部分文字未翻译或合成伪影,需要人工把关。目前尚不能取代精细排版,但在多数营销场景中表现出色。
典型场景: 跨语言信息图、海报、宣传插图等图文并茂素材的快速本地化。例如可以向 ChatGPT 提供一张英文广告图和提示「翻译所有文字为中文,不改动其他任何部分」,模型会直接生成对应语言的图像。
图:GPT-4V 多模态模型翻译示例(左:输入韩文图,右:输出越南文图)。
方法七:深度扩散模型编辑(DALL·E、Stable Diffusion)
原理/流程: 基于扩散模型的图像编辑技术:在原图上遮罩待替换的文字区域,再用提示词生成替代内容。通用流程为:文本检测并生成遮罩 → 设计生成提示词(如「将 X 替换为 Y,保持背景不变」)→ 用 DALL·E 3 或 Stable Diffusion Inpainting 进行修补 → 得到新图像。 例如,先用 OpenAI API 上传原图和文字遮罩,再发起「replace text」编辑请求。
工具: OpenAI DALL·E 3 编辑 API、Adobe Firefly Generative Fill、HuggingFace Diffusers(如 runwayml/stable-diffusion-inpainting)等。ControlNet 文本检测、LaMa inpainting 等控件可辅助标定待替换区域。
输入输出: 输入为原图 + 文字遮罩 + 提示词;输出为图像文件。模型通常自动匹配译文语言与风格。
自动化程度: 中高。遮罩步骤需要额外工具辅助(人工画出或程序生成),但整体也是一键式生成。
准确率/保真度: 较高,但略低于专门的文本编辑模型。扩散模型对长文本往往不够精确(可能断字),风格统一性也依赖提示质量。优点是对背景修补能力强,能把译文自然融入复杂纹理;缺点是字体形状有时不完美,可能出现轻微模糊或不必要的细节。最佳效果需调节遮罩与提示。
时间成本: 中等。生成一张图片通常需十秒到几十秒(本地 GPU 环境则取决于显卡性能),用云服务还需等待队列。
典型场景: 创意类翻译,如设计概念图、插画中的标语,以及可以容忍少许风格变化的场景。下图示例中,Stable Diffusion 把英文横幅「Summer sale — 30% off everything」翻成德文「Sommer-Sale — 30 % auf alles」,重新渲染但背景保持不变。
图:Stable Diffusion 文本替换示例(左:原英文横幅,右:德文翻译结果)。
方法八:自定义计算机视觉 + 脚本流水线
原理/流程: 完全自建的自动化流水线。用计算机视觉检测文字区域(如 OpenCV 边缘/轮廓检测或深度 OCR 模型),结合机器翻译 API,最后用图像处理库(如 Pillow/OpenCV)把译文绘制到原图上。步骤:文本检测 → 按框 OCR 识别并翻译 → 抠除文本区域并填补背景(可用修复算法)→ 把新文字绘制入图 → 输出结果。
工具: Python(Pillow、OpenCV、EasyOCR、pytesseract、百度或谷歌翻译 API)、Adobe PixelSense、C#/.NET 图像处理等。
输入输出: 输入普通位图;输出同分辨率位图。整个流程需自建或编写脚本,不依赖现成 GUI。
自动化程度: 高(脚本开发完善的前提下),可实现完全批量化。
准确率/保真度: 取决于算法细节。基本能匹配布局,但通常无法自动匹配字体,需要人为选择最接近的字体。也难以像扩散模型那样无缝修复背景,常用纯色或邻域平均等方法补洞。对复杂背景或非标准字体支持有限。
时间成本: 开发成本高(需编程能力),运行效率取决于 OCR 与绘制效率,单张图片处理为秒级。相对第三方服务,此方法零金钱成本,但编码工作量大。
优缺点: 可完全控制流程,适合批量自动化;但对设计细节的还原不如专用 AI 工具,需要调参和后期校正。适合需要深度定制或保护数据隐私的场景(不走公网)。
典型场景: 对流程有特殊要求的企业环境,或只需对少量标签做简单替换——比如商家自行编写脚本,把商品图标签 OCR 后翻译再写回。这种方法技术难度较大,但很灵活。
方法九:专业人工 + DTP 服务
原理/流程: 委托翻译与设计专业团队完成。专业译者先翻译文本,再由排版设计师(DTP)依据原图逐步替换。包括:识别并编辑源文件(如 PSD/InDesign)→ 翻译文本 → 在同样软件中调整布局并重新渲染图像。
工具: 通常使用 Adobe 全家桶、InDesign、Illustrator 等专业软件。服务商可能用 CAT 工具(Trados、MemoQ)辅助文本一致性,但最终输出依赖设计软件。
输入输出: 输入可为任意图片或源文件;输出通常是高质量的本地化图片或可编辑文件。
自动化程度: 低。完全人工服务,每一步都需人工干预。
准确率/保真度: 最高。译者和设计师可针对文化差异优化文本,同时精准保留或调整设计,输出质量由专业人员保证。
时间成本: 最高。成本包括翻译费 + 设计时间,通常比机器方案贵得多。适合高价值项目或非常敏感的内容。
优缺点: 极高质量与可靠性;缺点是成本和时间都远高于任何自动化方法。
典型场景: 品牌形象宣传、重要展会资料、政府或法律文件的图像内容、本土化出版物等需要人工校对的场合。
方法十:矢量 / 源文件自动翻译
原理/流程: 如果源图来自矢量或设计软件,可在设计环境里直接替换文字。例如 InDesign、Illustrator 带插件或脚本,先用 OCR 或自动转换提取文字,翻译后再插回文本框。也可把图片转 PDF,再 OCR 翻译后导回。
工具: Adobe Acrobat(OCR + 导出到 Word)、Illustrator 的文本查找替换、InDesign 的脚本,或第三方插件(如 Lokalise、Transifex 的 InDesign 插件)等。
输入输出: 输入通常为可编辑文档或 PDF;输出可直接在原文件上替换文字。
自动化程度: 中等。依赖软件的自动化能力与脚本支持。
准确率/保真度: 高。因为直接编辑源文件,所有图层与效果都能保留(前提是原文件可用)。若原始文件已是扁平化图片,则需 OCR 辅助,与方法二类似。
时间成本: 中等。自动替换后仍需人工微调。
优缺点: 优点是利用源文件精确排版;缺点是依赖原始可编辑文件与相应软件。
典型场景: 拥有设计源文件时的翻译需求,如 InDesign 排版的手册翻译;或紧急情况下先用 OCR 粗翻,再在源文件中复盘。
横向对比表
| 方法类别 | 设计保真度 | OCR/识别准确率 | 多语言支持 | 技术难度 | 成本 | 处理速度 | 适用场景 |
|---|---|---|---|---|---|---|---|
| 1. 专业设计软件(手工) | 很高 | N/A(人工) | 任意 | 高(需设计师) | 最高(人力成本) | 较慢(手动) | 高要求品牌/营销素材 |
| 2. OCR + 排版 | 高 | 高(结构化文本) | 多 | 中高(需软件/脚本) | 低(开源工具) | 中等 | 技术文档、说明图、结构化图表 |
| 3. 文档翻译服务 | 高 | 高(专业 OCR) | 很多 | 低(即用) | 中高(服务费) | 快速 | 大批量 PDF/扫描件、专业文档 |
| 4. 在线 AI 工具(ReWords 等) | 高 | 高(AI 识别) | 多 | 低(即用) | 低/中(免费 + 付费) | 快速 | 电商海报、漫画、日常多图本地化 |
| 5. 手机摄像头应用 | 低 | 中高(手持拍摄) | 多 | 很低(即用) | 低(免费) | 实时 | 个人旅行/生活场景快速阅读 |
| 6. 多模态大模型编辑 | 高 | 高(模型识别) | 很多 | 低(即用) | 中高(API 费) | 中等 | 信息图、广告海报、UI 截图等需快速推理的素材 |
| 7. 扩散模型(DALL·E 等) | 中高 | 中(需要遮罩) | 多 | 中(需提示技法) | 中(消耗 API 或算力) | 中等 | 创意设计类、宽松样式要求的场合 |
| 8. 自定义 Python 流程 | 中 | 中(依赖工具) | 多 | 高(编程) | 低(开源) | 灵活(批量自动) | 自动化需求环境(企业定制、多图批量) |
| 9. 专业人工 + DTP | 很高 | N/A(人工) | 任意 | 很高(专业团队) | 最高(服务费) | 很慢(人工) | 高端出版物、对译文/格式要求极严的场合 |
| 10. 源文件直接翻译 | 很高 | 高(源中提取) | 多 | 中(设计软件) | 低(利用现有软件) | 中等 | 可编辑源文件的项目(如 InDesign 书籍、报表翻译) |
注:表中「保真度」指翻译后图像与原始设计的一致程度。比如手机 APP 只用于理解,图像会加大块遮罩,故保真度低;而专业设计与文档翻译服务可完整保留布局和字体,故评分高。
三个端到端教程
如果你想比「点一下按钮」走得更深,这三种做法值得学。每个都附完整流程与可运行代码。
教程 1:GPT-4 Vision 多模态编辑
概述: 本示例展示如何用 OpenAI 的 GPT-4 图像能力(或 DALL·E)编辑图片中的文字。 准备: 注册 OpenAI 并获取 API 密钥。准备一张带文字的示例图和对应遮罩。假设我们要把英文「Summer sale」翻译为中文「夏季特卖」。
流程: 输入原图 → 调用 GPT-4V 或 DALL·E 编辑接口 → 模型识别文字并翻译 → 模型生成新图 → 下载并校对译文。
- 准备图像与遮罩。 确保原图(
orig.png)与遮罩图(mask.png)对齐,遮罩只覆盖「Summer sale」文字区域。 - 调用 API(以 OpenAI Python SDK 为例):
```python import openai openai.api_key = "YOUR_API_KEY"
让模型把遮罩区域的文字翻译成中文,其余内容保持不变
response = openai.Image.create_edit( image=open("orig.png", "rb"), mask=open("mask.png", "rb"), prompt="用中文翻译上面的文字,不改变其他内容。", n=1, size="1024x768" )
把返回的图片写入磁盘
with open("output.png", "wb") as f: f.write(response['data'][0]['image']) ```
这段代码告诉模型「把遮罩区域文字翻译为中文,其余不变」,并生成结果。
- 查看结果。 检查
output.png。模型应已把「Summer sale」替换为「夏季特卖」,字体风格相似,背景一致。
图:GPT-4V 编辑翻译示例(左:原始韩文,右:模型输出越南文)。
- 保存输出。 保存并使用
output.png,必要时可用图像编辑软件微调文字位置或样式。
注意: GPT-4V 生成的文字需要校对;若有遗漏,建议提供更详细的提示或分块翻译。OpenAI API 按图像大小与生成次数计费。
教程 2:在线 AI 工具(ReWords / EditTextImage)
概述: 使用 ReWords App 或类似网站做图像翻译,以 ReWords 为例。 准备: 访问 ReWords 或 EditTextImage 等在线工具,无需安装。
流程: 上传原图 → 系统 OCR 检测文字 → 自动翻译并显示建议文本 → 用户调整文字、锁定保持原样的部分 → AI 渲染新图 → 下载翻译后的图像。
- 上传图片。 打开 ReWords 官网,选择「Translate Text in Image」功能,上传需要翻译的图片(示例为含「SUMMER SALE」的广告图)。
- 选择语言并编辑。 平台自动识别所有文本行,你选定目标语言(如中文),系统给出逐行翻译建议。可手动修改错误翻译,必要时锁定不需变更的词(如品牌名)。
- 生成图像。 点击「Generate」或「Apply」,AI 会自动去除原文字,并依据原字体、颜色、背景重绘译文。
- 下载结果。 完成后下载新图。示例中左图为原始「SUMMER SALE」图,右图为 ReWords 生成的「夏季特卖」版本。
图:ReWords 生成的图像翻译示例(左:原图,右:AI 翻译后)。
提示: 这类工具通常有免费额度(ReWords 每张图提供数次免费生成),超额需付费或积分。翻译质量高,但最好检查文本是否正确,尤其数字与专有名词。适合无法获取原设计文件时直接本地化图片。
教程 3:Python OCR + OpenCV 自动化翻译
概述: 用 Python 脚本实现从图片中提取文字、翻译、再渲染入图。我们以 Tesseract OCR 和 OpenCV/Pillow 为基础,示例流程为把西班牙语图片翻译成英语。
流程: 加载原图 → 文本检测与 OCR(Tesseract)→ 调用翻译引擎(Google Translate API)→ 用 OpenCV 抠除原文区域 → 用 Pillow 在图上绘制译文 → 输出本地化图像。
- 安装依赖(需先安装 Tesseract-OCR 和 Python 库):
```bash
安装 Tesseract(示例为 Ubuntu)
sudo apt-get install tesseract-ocr
安装 Python 库
pip install pytesseract pillow googletrans==4.0.0-rc1 ```
- 代码示例:
```python from PIL import Image, ImageDraw, ImageFont import pytesseract from googletrans import Translator
读取原图
image = Image.open("image_with_text.png")
运行 OCR 识别(识别西班牙语)
text = pytesseract.image_to_string(image, lang='spa') print("识别结果:", text)
翻译文本
translator = Translator() result = translator.translate(text, src='es', dest='en') print("译文:", result.text)
本示例已知文本位置,此处手动定义
实际可用 pytesseract.image_to_boxes 获得每个字符的框
x, y, w, h = 50, 50, 300, 50 # 示例坐标
在原图上抹去原文
draw = ImageDraw.Draw(image) draw.rectangle(((x, y), (x + w, y + h)), fill="white") # 用白底覆盖
绘制译文
font = ImageFont.truetype("arial.ttf", size=36) draw.text((x, y), result.text, font=font, fill="black")
保存输出
image.save("translated_image.png") ```
- 说明: 脚本先用 Tesseract 识别原图文字,再用 Google 翻译(
googletrans)获取译文,接着用 Pillow 在原图上擦除原文区域并绘制译文。上例演示了单个固定区域的处理;实际应用需根据 OCR 结果动态确定区域并匹配字体(此处为示例简化)。 - 输出效果: 运行后生成
translated_image.png,原文字区域已被替换为英文译文。
注意: 本流程依赖 OCR 定位精度与字体匹配能力。实际项目可结合 OpenCV 做轮廓检测以精确抠图,也可用 Pillow 测量文字宽度自适应换行。如需处理多行文字,请循环处理各段。整个过程可批量化,但布局保留效果不及 AI 补全方法,需要测试并可能微调参数。
如何选择:一份决策指南
把方法与三件事对齐——保真度、成本、以及你是否手握源文件:
- 没有源文件、又要快(最常见的情况): 用在线的 ReWords AI(方法四)。上传、选语言、生成、下载。
- 图片文字多且结构规整(图表、手册、示意图): OCR + 排版(方法二),批量文件则用格式保留的文档翻译服务(方法三)。
- 结果必须印刷级完美、且关乎品牌: 人工设计(方法一)或专业人工 + DTP(方法九)。
- 想把它自动化进自己的工作流: 多模态模型 API(方法六)或自定义 Python 流水线(方法八)。
- 只想快速拍张照读懂内容: 手机摄像头应用(方法五)——但绝不要用于发布。
- 你仍持有可编辑源文件: 直接改源文件(方法十)。能用时,这是最干净的路径。
保持原设计的五条法则
不管走哪条路,下面这些习惯,就是「翻译过了」和「专业本地化」的分界线:
- 为文字长度变化留余地。 德语、法语通常会变长,中文、日文会变短。要预期到缩放、换行或调字距,别假设译文能原样塞进原来的框。
- 匹配字体,而不只是匹配文字。 复现原字重、颜色、字距,以及描边或阴影。字体不对,译文再准也显得别扭。
- 干净地重建背景。 文字背后被修复的区域应与四周浑然一体——羽化边缘,并在 1:1 缩放下检查接缝。
- 照顾好非文字元素。 箭头、标注、编号、图例往往带文字或指向文字,处理到位,本地化版本才连贯。
- 校对译文本身。 机器翻译快但不完美。数字、单位、品牌名和专有名词,发布前值得人工检查一遍。
总结
你不需要原始设计文件,也能翻译图片里的文字。 你需要的是,按你所求的保真度选对方法——而对大多数日常图片来说,那个方法就是一键 AI 工具:读出文字、翻译它、再就地重绘,全程不扰动版式。
当要求高、图片复杂时,更重的工具——人工设计、文档翻译服务或专业 DTP——依然物有所值。但对绝大多数菜单、海报、商品图与社媒图来说,你可以在几分钟内完成本地化。
挑一张你一直想翻译的图片,上传到 ReWords AI,先看看一分钟的 AI 翻译能把设计保留到什么程度,再考虑要不要走人工路线。
References
- OpenAI 图像编辑与 DALL·E 编辑官方文档。
- 关于 PDF 与图像翻译的格式保留研究。
- Atlas Cloud 关于 OCR 提取与设计工作流中重新放置文字的报道。
- 在线图像翻译工具的产品文档(ReWords AI、EditTextImage 等)。
- 用于自定义流水线的 Tesseract OCR、OpenCV 与 Pillow 文档。