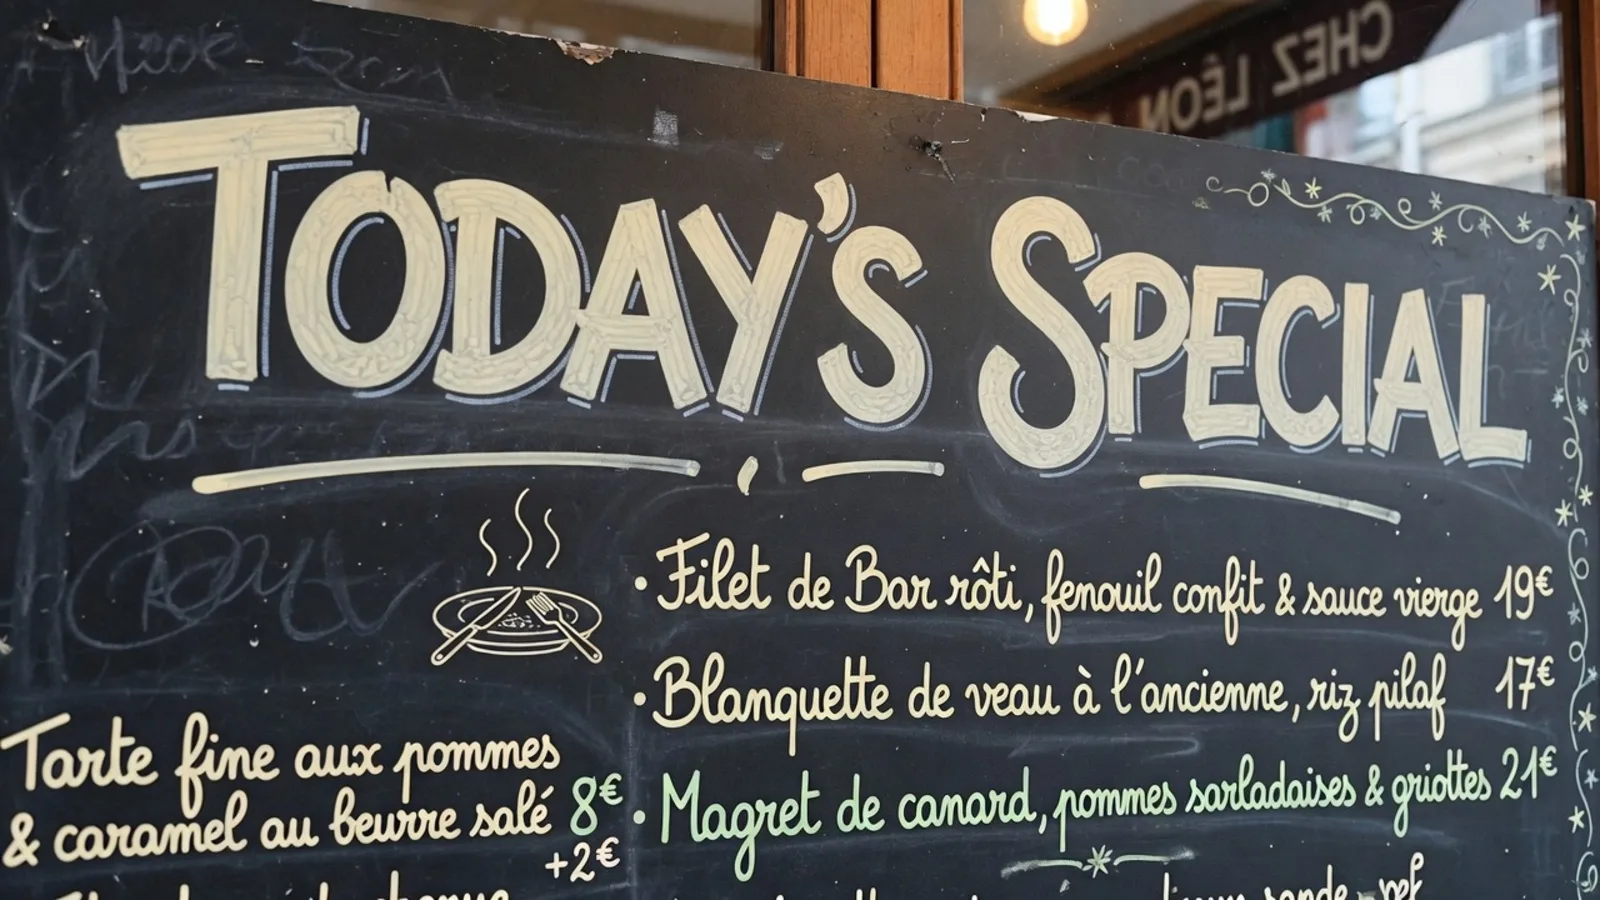
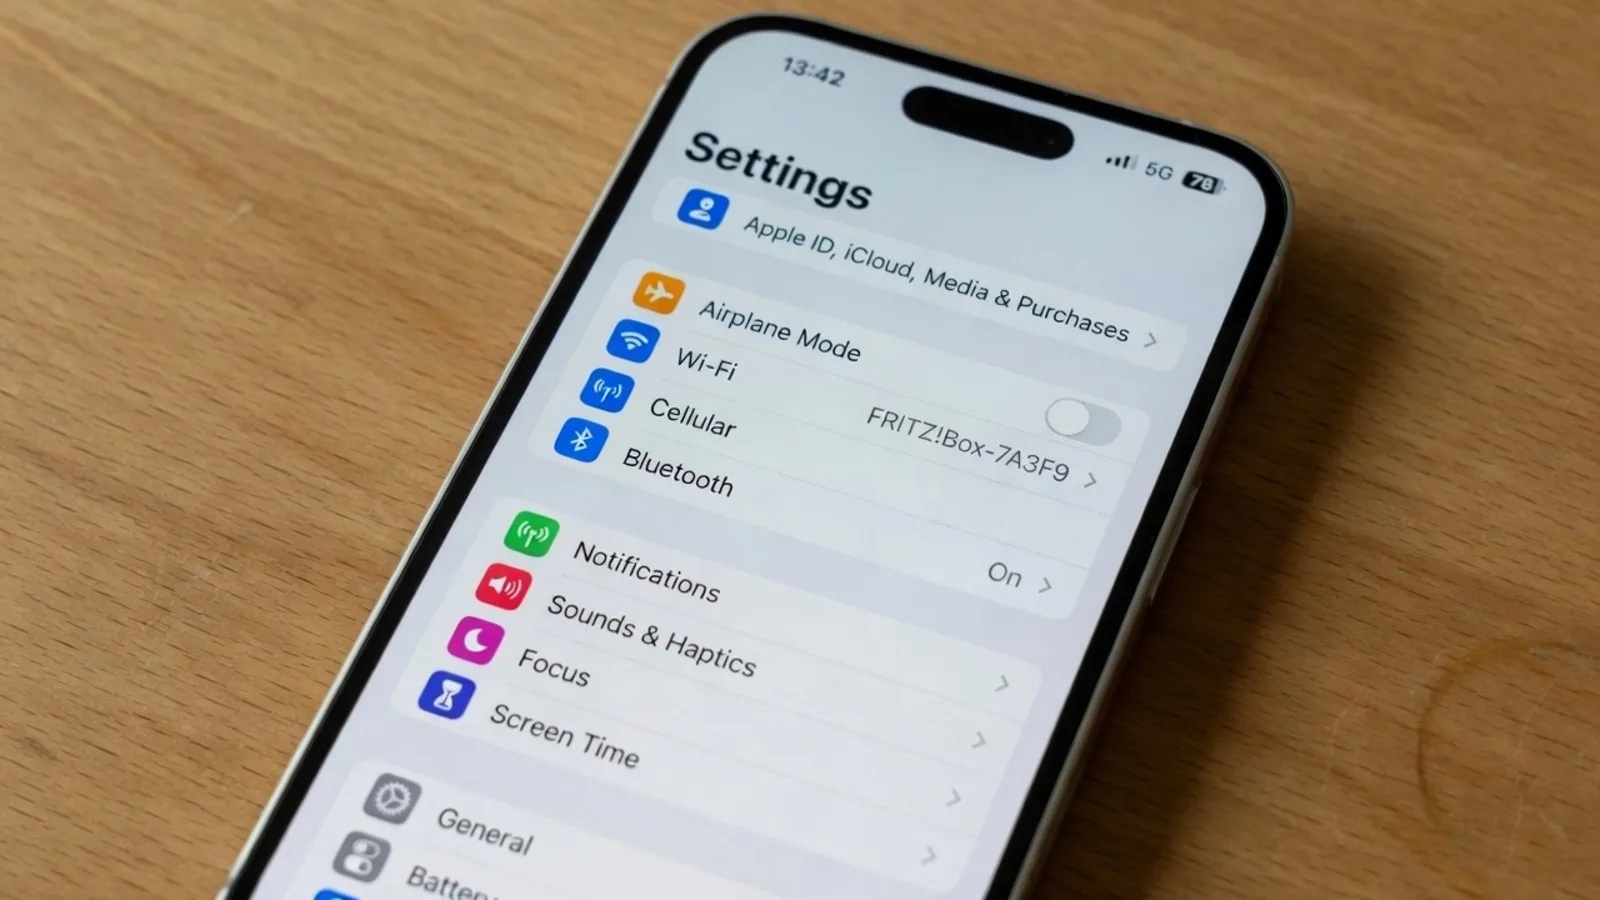
想象你正站在一家咖啡馆门外,面对一块写着草书体今日特价菜(PLAT DU JOUR)的手写黑板招牌。你可能只是想把上面的菜名摘录进旅行随笔,也可能需要一张干净的视觉图像素材来制作宣传单。尽管这两个诉求源于同一张照片,但它们所需的处理路径截然不同。
我经常看到团队在这个技术分支前产生困惑,把所有图片问题都当成文本提取来处理,而实际上他们真正需要的是视觉层面的画面重构。决定是提取纯文字字符,还是直接将翻译好的词句重绘到图片上,取决于你最终需要交付的是结构化数据,还是一幅制作完成的视觉作品。认清这一本质差异,能避免你在桌面图形设计软件中耗费数小时去反复做无意义的排版修补。
图片文字翻译
使用我们的免费在线图片翻译器自动翻译嵌入图片的原有文字并重绘视觉区域。用户可以在最终渲染前编辑译文行。完成登录后可获得有限试用积分,以便体验和测试图像翻译与重绘功能。
核心区别:纯文本字符串与重绘像素
光学字符识别(OCR)的核心目标,是将语言信息从其所依托的视觉媒介中剥离出来。算法通过扫描像素网格来勾勒字符边缘、推断 Unicode 码点,并将纯文本输出到你的剪贴板中。在整个处理过程中,原始位图完全不受触碰,底部的纹理、噪点颗粒以及原始字迹都会原封不动地保留下来。
如果你的直接目标是为电子表格、数据库或研究笔记收集信息,提取字符无疑是最为干净高效的途径。借助图片转文字,你可以在不改变图像像素、不消耗生成积分的前提下获取可编辑的文本行。这种工作流将后续的视觉呈现完全交由你自己把控,这也意味着任何后续的视觉设计都必须在外部软件中手动拼装搭建。
原位图片翻译则秉持截然相反的理念来处理画布——它将整体视觉排版视为主要交付物。系统不再只是为了文档而抽取字符,而是在原图环境中直接擦除原始文字,并生成翻译后的新文本。其目的在于交付一张和谐自然的视觉素材,让翻译后的语言在原本的位置上自然替代外语字面。
这一功能上的分流直接改变了你处理后续编辑工作的方式。如果你依赖纯文本提取来制作一张带有文字的招牌或海报,你就必须打开 Photoshop、Figma、Canva 或 GIMP 等图像编辑器,手动将画面上原有的文字区域涂抹遮盖,再从零开始重构字体排版。而原位视觉替换则能直接在图像画布上自动完成底色修复与字体视觉合成。
文字提取的工作原理与边界范围
传统的光学字符识别流程会将画面中的阴影、纹理质感、拍摄透视以及艺术装饰花纹统统视为干扰项。识别引擎会专门剥离出高对比度的笔画图案来判定字符,一旦纯文本字符串生成完毕,就会丢弃所有的空间版面上下文。当输出了纯文本字符后,该工具的既定任务便宣告完成,它无法为接下来的图像重构提供任何辅助。
这种专注的设计目标使得字符提取显得十分干净、轻量且完全是非破坏性的。由于工具不会去合成任何替换像素,你的原始文件能够完整保留原有的压缩属性,不会产生任何代际画质劣化。你获得的是纯粹的文本字符串,可以毫无负担地直接粘贴到翻译记忆库、文字处理软件或数据库中,不带任何多余的视觉包袱。
然而,当团队寄希望于纯文本提取来解决图像排版需求时,麻烦就随之而来了。把外语句子复制到翻译框中固然能得到译文,但这些翻译出来的词句对实体招牌的物理边界或整体视觉美学一无所知。要想把译文重新放回可印刷的图像中,你不得不手动挑选字体、小心翼翼地调整换行折行,并费时费力地在背景上进行仿制图章纹理修补。
原位图片翻译的运作机制
原位翻译将光学识别、多语言翻译和视觉修复修补(Inpainting)融为一个连贯的工作流。当你想要翻译图片中的文字时,平台处理的是静态的 PNG、JPG 和 WebP 图片,而非实时摄像头画面。引擎会识别静态画面中的各个文字区域,并为你指定的目标语言提供建议译文。
你绝不会被机器的自动化猜测所束缚,因为在像素被真正修改之前,你可以逐一审阅每一处短语。你可以润色生硬别扭的词汇、根据受众调整表达方式,也可以选择锁定(Lock)某一行被识别出的文字以保持其原文不变。需要强调的是,这里的锁定操作严格针对检测出来的这一行字,而不是像在 Photoshop 中锁定整个图像图层。
未注册的访客每个任务只能请求一次建议译文,以便在正式生成前评估用词表达。注册并登录账户后会获得试用积分,方便你在真实的视觉素材上测试出图效果。文本检测与建议预览不会扣除任何积分,让你无需承担费用即可核对词句。只有当你点击生成(Generate)时才会扣除积分:1K 渲染消耗 10 积分,2K 消耗 20 积分,4K 消耗 30 积分。
当你确认用词并开始生成后,系统会擦除画面中的原始文字,并将翻译后的文本重新绘制在画面之中。这种画面重绘并非无损处理,也不会加载原版专有字体文件,更绝不能用作公证翻译或官方过审翻译。渲染器做的是尽力匹配原始字迹在周围场景中的字重粗细、倾斜角度、光影明暗与材质纹理。
由于你对检测出的每一行文本拥有完整的编辑控制权,因此你需要对最终输出中的所有词汇选择自行负责。平台没有无限免费出图模式,也不提供用于自动化高并发渲染的批量 API。每一张生成的图像素材,都是在人工审校与机器合成协同下的精细视觉转换。
输出产物与工作量的横向对比
究竟是选择提取文字还是原位视觉翻译,取决于你的项目最终需要交付什么形态的成果物。文字提取产生的是干净的剪贴板字符串,而原位图片翻译输出的则是一张渲染完毕的栅格位图文件。这一差异直接决定了你后续的工作是在文本编辑器中展开,还是在图形制作软件中进行。
| 评估维度 | OCR / 纯文字提取 | 原位视觉翻译 |
|---|---|---|
| 核心输出成果 | 纯文本字符串或剪贴板文本 | 全新渲染的栅格图像(PNG、JPG、WebP) |
| 原图像素状态 | 完全保持原样,未经任何修改 | 擦除旧文字并以目标语言字形重新绘制 |
| 后续设计工作 | 若制作视觉素材则必须手动排版 | 常规本地化设计排版无需额外操作 |
| 生成积分消耗 | 消耗 0 生成积分 | 每次渲染扣除积分(1K=10,2K=20,4K=30) |
正如上表对比所示,你的技术选择将直接左右你的制作周期与资源分配。如果你需要一张能立即发布的宣传推广图(例如带有 SUMMER SALE「夏季特卖」或 FREE SHIPPING 等标识的电商横幅),原位翻译能免去反复抠图遮罩背景和排版字体的繁琐流程。相反,如果你的目标只是记录菜谱原料或搭建术语数据库,去调用视觉合成反而成了一项多余的开销。
两者的成本模式也反映了这一功能划分。在图像分析阶段,检查文字边界和请求建议译文不消耗任何积分,因为此时并没有发生图形合成计算。只有当你触发生成式渲染器,去绘制新字形、平衡环境光影并在画布上重建背景纹理时,系统才会按规格扣除相应积分。
排版重排与空间尺寸限制
不同语言在书写表达上的转换,必然会导致文本长度的膨胀或收缩。一种语言中只有两三个词的简短表达(例如 LIMITED TIME 或 NEW ARRIVAL),翻译成另一种语言后往往会变成更长的短语。如果你手动把翻译好的文字粘贴到图形设计稿中,经常会遇到译文撑破原有容器边界、或者挤压周围设计元素的情况。
原位翻译在生成式合成的过程中直接应对了这一空间尺寸维度的挑战。系统会动态调整字符间距、比例缩放与折行换行,让翻译后的词句自然适配在原始的空间边界内。尽管引擎能调整文字排版以契合周边的视觉风格,但它无法改变底层图片既定的物理几何结构。
这种物理边界的限制,更加说明了在生成前审阅建议译文有多么必要。如果系统给出的短语对于狭窄的飘带或装饰性横幅来说显得过于冗长,你可以手动将其精简改写为更短的对应表达。随后锁定(Lock)这行改好的文本,就能确保你的定制文字保持不变,同时让引擎将算力专注于合成协调自然的视觉质感。
为你的项目选择合适的技术方案
技术路径的选择应当始终以翻译素材的最终用途为导向。如果你的最终目标是一张可直接发布的英文视觉图片,单纯复制外文字符串只相当于拿到了拼图的中间碎片。如果你需要让异国咖啡馆门口的手写黑板直接呈现为地道的英文视觉招牌而无需手动排版,前往图片翻译成英文即可直接获得本地化渲染的成图。
另一方面,如果你的工作是整理参考资料、分析法律合同或归档采购发票,你就应该将工作流保留在文字提取的轨道上。为密密麻麻的单据截图去生成全新图片,除了增加不必要的视觉负担外,并不能提升任何数据使用效率。在这些场景中,将纯文本字符串复制到 Markdown 文档或电子表格里才能发挥最大的实用价值。
在开展任何图片翻译任务前,建议先评估你的核心诉求:弄清楚你的受众最终需要看到的是一张干净、自成一体的完整视觉素材,还是你的工作流仅仅需要底层的语义信息。明确了这个关键问题,你就能清楚地知道该调用纯字符提取,还是直接对图形画布进行重绘翻译。
总结
光学文本提取与原位图片翻译在数字出版与内容处理中扮演着截然不同的角色。字符提取能在原图像素完全不受触碰的情况下捕获文字,非常适合数据归档、内容分析以及多图层的手动设计工程;而原位视觉翻译则直接重构画面,将本地化短语无缝融入现有的视觉场景中,省去了枯燥的手动字体排版工作。
需要注意的是,这两种方法都无法替代针对具有法律约束力合同的专业公证翻译,视觉重绘也不会提供完全一致的矢量重构或专有字体文件。然而,只要根据具体需求匹配正确的技术路径,就能避免在桌面修图软件中浪费精力,让内容制作与本地化工作保持高效推进。当你需要可编辑的数据时,选择提取文字;当你需要一张完整的视觉成品图时,直接使用原位图片翻译。
参考来源
关于光学字符识别(OCR)实现方式的相关讨论 图像文字替换工作流程的技术解析 图文排版重构技术方案的对比评估 Tesseract OCR 提升识别质量指南 双语词典对齐与词义映射维基百科条目 W3C 国际化排版规范与断行处理标准