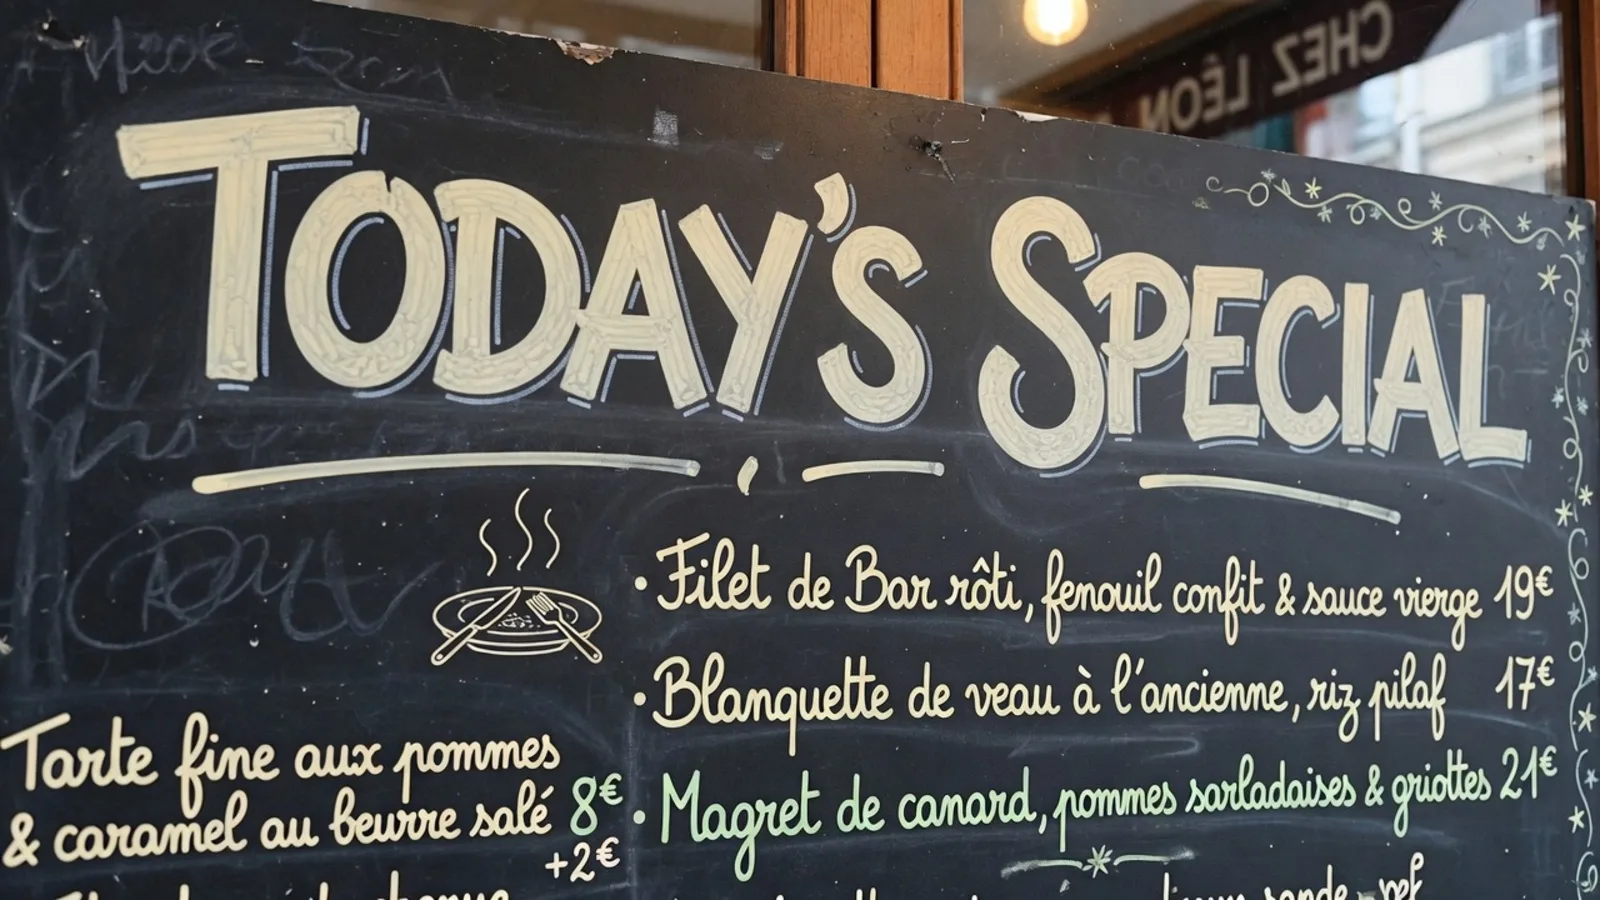
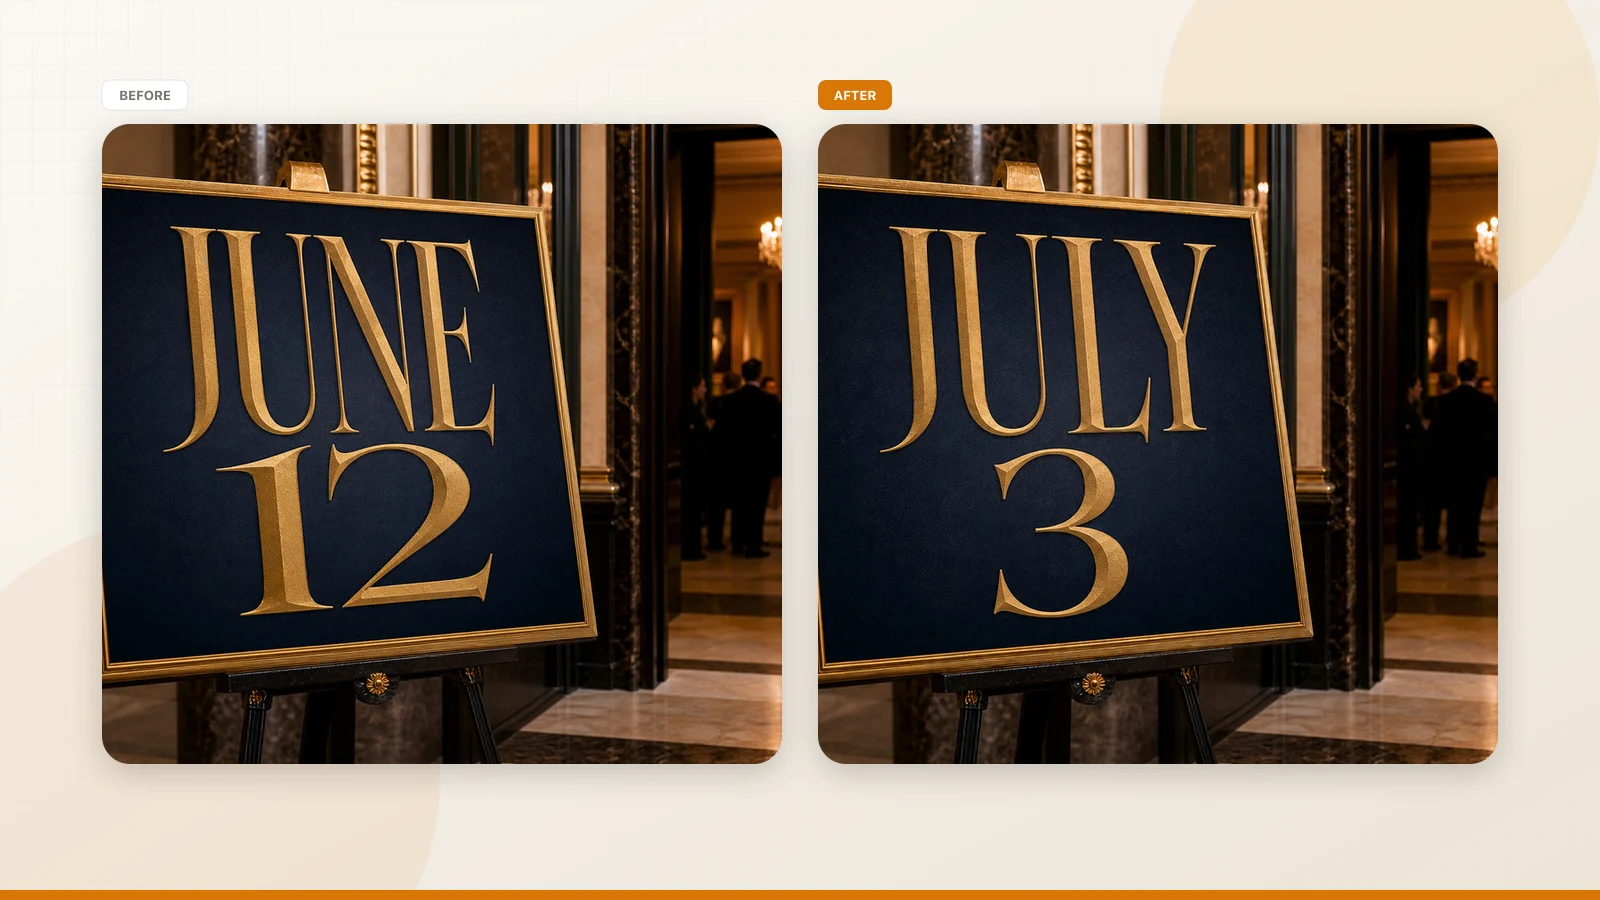
Dez formas de localizar as palavras dentro de uma imagem finalizada — mantendo o layout, as fontes e o fundo exatamente como o designer os deixou.
Um pôster de campanha em inglês. Um menu em japonês. Um rótulo de produto em alemão. Um diagrama técnico rotulado em espanhol. Você precisa de cada um deles em outro idioma — e tudo o que tem é a imagem exportada.
Traduzir um documento é fácil: entregue o texto a um tradutor e receba as palavras de volta. Traduzir o texto dentro de uma imagem é uma história completamente diferente. Você não está apenas trocando palavras. Você está editando pixels de forma cirúrgica, enquanto o layout de um designer observa por cima do seu ombro, e qualquer erro — uma fonte ligeiramente errada, um fundo que não se alinha direito, uma palavra traduzida 30% mais longa que o original — fica imediatamente visível.
É exatamente esse o problema que torna a localização de imagens tão complicada: você precisa mudar o significado sem mudar o design. O relatório abaixo mapeia dez abordagens reais para fazer exatamente isso, do trabalho totalmente manual do designer até o clique único com IA, com a fidelidade, o custo e os modos de falha de cada uma.
Traduzir Texto em Imagem
Traduza automaticamente textos inseridos e redesenhe elementos com nosso tradutor de imagem grátis online.
Por Que Traduzir Texto Dentro de uma Imagem É Tão Difícil
Quando você traduz um documento, o layout se flexiona. Quando você traduz texto embutido em uma imagem, o layout fica congelado em pixels. Essa única restrição gera uma pilha de problemas:
O comprimento do texto muda. Uma frase curta em inglês pode crescer 30% ou mais em alemão ou francês, enquanto a mesma frase encolhe drasticamente em chinês ou japonês. O espaço no design original é fixo, então a tradução precisa ser reajustada — redimensionada, requebrada ou com espaçamento ajustado — sem quebrar a composição.
Fontes e estilos precisam combinar. A tipografia original, o peso, a cor, o espaçamento entre letras e efeitos como sombras ou contornos têm todos de ser reproduzidos. Se errar, a versão localizada parece sutilmente estrangeira ao lado da original.
O fundo precisa ser reconstruído. Apagar o texto de origem destrói os pixels por baixo dele. Em uma cor sólida, isso é trivial; em uma foto, degradê ou textura, você está reconstruindo uma imagem que falta.
Elementos não textuais também exigem cuidado. Setas, chamadas, numeração e legendas geralmente contêm texto ou apontam para texto, então uma localização limpa precisa levá-los em conta.
Cada método abaixo é uma forma diferente de equilibrar esses quatro problemas. A escolha certa depende de quão fiel o resultado precisa ser, de quanto texto a imagem contém e de você ter ou não o arquivo de origem original.
O Caminho Mais Rápido: Tradução de Imagem com IA Online
Antes dos métodos manuais, saiba que o atalho existe — e é por ele que a maioria das pessoas deve começar.
Ferramentas de IA online criadas exatamente para essa tarefa, como o ReWords AI, combinam detecção de texto, tradução automática e inpainting de imagem por IA em um único fluxo. Em vez de sobrepor uma nova caixa de texto, elas detectam o texto que já está na imagem, traduzem-no, apagam o original, reconstroem o fundo e redesenham a tradução com uma fonte, cor e tamanho correspondentes — de modo que o layout permaneça no lugar.
Como funciona:
- Envie a imagem. Abra a ferramenta, escolha a função "Translate Text in Image" e envie a imagem (por exemplo, um anúncio com um banner "SUMMER SALE").
- Escolha um idioma e edite. A plataforma detecta automaticamente cada linha de texto. Selecione o idioma de destino e ela retorna uma sugestão de tradução linha a linha que você pode corrigir à mão. Bloqueie quaisquer palavras que não devem mudar, como nomes de marcas.
- Gere. Clique em Generate ou Apply, e a IA remove o texto original e redesenha a tradução usando a fonte, a cor e o fundo originais.
- Baixe. Revise o resultado e baixe a imagem localizada.
Figura: Exemplo de tradução por IA online (à esquerda: original; à direita: traduzido).
Por que é a escolha padrão: não precisa de arquivo de design de origem, nem de instalação de software, nem de habilidade de design. Uma imagem típica retorna em segundos a um minuto. As ferramentas dessa categoria costumam incluir uma cota gratuita (o ReWords oferece algumas gerações gratuitas por imagem), com créditos pagos além disso.
Onde ter cuidado: a própria tradução merece uma revisão — especialmente números e nomes próprios — e texto denso, iluminação complexa ou fontes muito decorativas podem, ocasionalmente, atrapalhar a reconstrução da IA. Também vale ficar atento a direitos autorais e conteúdo sensível.
Melhor encaixe no mundo real: imagens de produtos de e-commerce, peças publicitárias e de redes sociais localizadas, menus, panfletos e quadrinhos — as tarefas de localização do dia a dia, em que você não tem mais o arquivo original.
O Kit de Ferramentas Completo: 10 Formas de Traduzir o Texto de uma Imagem Sem Quebrar o Design
Se a imagem é complexa, os riscos são altos, ou você prefere construir seu próprio pipeline, aqui estão as dez abordagens que vale a pena conhecer. Cada uma lista como funciona, o que precisa, quão fiel é e para quem serve.
Método 1: Edição de Design Manual (Photoshop / Illustrator)
Como funciona: Um designer profissional faz isso à mão. Primeiro, extrai o texto original (via OCR ou transcrição manual) e o traduz. Depois, no Photoshop, Illustrator ou ferramenta semelhante, redigita a tradução com uma fonte e um estilo correspondentes sobre a área do texto original. O pipeline segue: extrair texto → traduzir e revisar → encontrar ou recriar a fonte correspondente → apagar o texto original, inserir a tradução e ajustar os efeitos.
Ferramentas: Adobe Photoshop, Illustrator, InDesign, GIMP, Figma; ferramentas de OCR como o Tesseract podem auxiliar na extração.
Entrada / Saída: Qualquer formato de imagem na entrada (PNG/JPEG); uma nova imagem na saída, no mesmo formato, ou um arquivo PSD/AI editável com camadas.
Automação: Baixa. Predominantemente manual, com automação apenas na etapa de extração por OCR.
Precisão e fidelidade: Máxima. O designer controla fonte, posição e estilo por completo e consegue reproduzir o design original pixel a pixel. A fidelidade depende da habilidade, é lento e é sensível à expansão do comprimento da tradução.
Tempo e custo: Altos. Uma edição profissional pode levar de minutos a horas, dependendo da complexidade, e o software tem uma curva de aprendizado — ineficiente quando você traduz em grande volume.
Prós e contras: Preserva integralmente layout e estilo (em teoria, uma troca perfeita), o que serve bem a peças de marketing e de marca exigentes. Mas é lento, caro e propenso a erros, e, a menos que você tenha a fonte idêntica, uma correspondência perfeita é difícil.
Melhor para: Pôsteres de anúncios, design de embalagens, protótipos de UI e peças impressas que exigem localização de alta fidelidade.
Nota de caso: A Atlas Cloud observa que, depois que o OCR extrai o texto, ele ainda precisa ser "colocado de volta no design" à mão, enquanto a edição puramente de imagem mescla as alterações em uma nova camada raster, com menos controle sobre letras individuais — a diagramação manual é mais lenta, mas a mais precisa.
Método 2: OCR + Diagramação em Software de Design
Como funciona: Um pipeline semiautomático, um pouco mais automatizado. Primeiro, execute OCR na imagem para extrair o conteúdo e a posição de cada caixa de texto. Depois, obtenha as traduções via tradução automática ou humana. Por fim, renderize a tradução de volta na imagem nas posições e estilos originais, usando software de diagramação ou um script. Pipeline: reconhecimento por OCR → tradução do texto → reconstrução do layout → imagem de saída.
Ferramentas: Bibliotecas e aplicativos de OCR (Tesseract, EasyOCR, Adobe Acrobat OCR); APIs de tradução (Google Translate, DeepL, Baidu Translate); ferramentas de diagramação (Adobe InDesign, Photoshop, ou Pillow/Matplotlib em ambiente de programação).
Entrada / Saída: Qualquer formato de imagem na entrada (PNG/JPEG); uma nova imagem na saída. Um documento vetorial (PDF/AI) pode ser usado no meio do processo para preservar o layout.
Automação: Média. O OCR e a tradução podem ser automatizados, mas a diagramação final geralmente precisa de mão humana — especialmente quando os idiomas de origem e destino diferem muito em comprimento e você precisa ajustar o tamanho da fonte e o espaçamento entre linhas.
Precisão e fidelidade: Alta. Se você combinar as fontes e as posições dos quadros, o layout é bem preservado. Mas a expansão da tradução pode quebrar a distribuição espacial original, exigindo escala ou requebra, e erros de posicionamento em gráficos complexos prejudicam a fidelidade.
Tempo e custo: Médios. A parte de OCR e tradução é rápida (segundos a minutos), mas a diagramação seguinte leva de minutos a dezenas de minutos.
Prós e contras: Mais rápido que o trabalho puramente manual, mas depende da precisão do OCR e da correspondência de fontes; pequenas diferenças de kerning e ligaduras podem surgir. Serve bem a imagens com muito texto e altas exigências de design. O porém: não lida com elementos não textuais (linhas-guia, numeração) — esses exigem trabalho manual.
Melhor para: Localizar anotações de gráficos, manuais técnicos e diagramas educacionais com muitos elementos textuais.
Contexto: As ferramentas de tradução de PDF geralmente seguem essa lógica — analisar a estrutura do documento, traduzir região por região e depois "substituir o texto no lugar e preservar o layout". Faça OCR e tradução bloco a bloco em uma imagem e você obtém o mesmo resultado no lugar.
Método 3: Serviços Dedicados de Tradução de Documentos (Preservação de Formato)
Como funciona: Use um serviço empresarial ou online de tradução com preservação de formato. Essas ferramentas analisam o layout e as fontes do arquivo ou imagem de entrada, traduzem cada bloco de texto automaticamente e rediagramam a saída. Etapas principais: análise do layout (identificar coordenadas das caixas de texto, fontes) → tradução do texto (serviço em nuvem ou MT local) → re-renderização do layout → arquivo de saída. As imagens normalmente são preservadas sem alteração.
Ferramentas: Plataformas online ou softwares comerciais como o PDFTranslator (motores Gemini + ChatGPT), a plataforma Pangeanic ECO, o Pairaphrase e o Smartcat. Muitos aceitam entrada em PDF ou imagem e geram um PDF ou gráfico traduzido que mantém o estilo original.
Entrada / Saída: Digitalizações, imagens ou PDFs na entrada (JPG/PNG/PDF); um arquivo traduzido no mesmo formato na saída, com layout, tabelas e posições dos gráficos essencialmente intactos.
Automação: Alta. O sistema roda de ponta a ponta, precisando apenas de leve revisão humana.
Precisão e fidelidade: Alta. Serviços avançados usam OCR de alta precisão combinado a LLMs/sistemas de tradução dedicados para atingir mapeamento em nível de coordenadas do texto e do formato. Layout e fontes são preservados (a fidelidade em nível de documento pode chegar a 90%+), com o erro vindo principalmente das diferenças de comprimento da tradução.
Tempo e custo: Baixos. A tradução é rápida — de segundos a minutos para a maioria dos trabalhos (um PDF de 60 páginas em minutos). Mas geralmente é um serviço pago ou exige cota de API comprada.
Prós e contras: O ponto positivo é a alta automação, a economia de tempo e a boa fidelidade. O ponto negativo é a sensibilidade a taxas de API (documentos volumosos ou longos custam dinheiro) e o suporte limitado a layouts incomuns ou escrita à mão. Serve bem à tradução em lote de documentos ou imagens.
Melhor para: Documentos técnicos multilíngues corporativos, manuais de produtos, materiais de treinamento e relatórios financeiros em que o layout precisa ser fielmente preservado. Nos bastidores, esses sistemas são essencialmente o pipeline de OCR + tradução + diagramação automática.
Método 4: Ferramentas Online de Tradução de Imagem por IA
Como funciona: Serviços de IA dedicados traduzem e modificam o texto diretamente em uma imagem, muitas vezes usando aprendizado profundo para "mascarar e repintar" automaticamente. Tipicamente: enviar o original → OCR automático das regiões de texto → tradução automática (com revisão manual) → o modelo apaga o original e repinta a tradução em estilo de fonte semelhante → baixar a nova imagem. Essas ferramentas agrupam OCR, MT e preenchimento de imagem em uma tradução com um clique.
Ferramentas: ReWords AI, ImageGPT, EditTextImage, Codia, VisualGPT e similares. As interfaces frequentemente permitem bloquear linhas de texto que não devem mudar e editar a tradução sugerida.
Entrada / Saída: Um bitmap comum na entrada (PNG/JPEG); um bitmap na mesma resolução na saída, com a tradução renderizada no estilo original.
Automação: Alta. Você envia e clica em "gerar"; a IA cuida das etapas intermediárias.
Precisão e fidelidade: Alta no geral. Modelos generativos modernos combinam bem o estilo da fonte e a textura do fundo, a ponto de produzir resultados "sem edição visível", embora texto muito denso, iluminação complexa ou fontes altamente decorativas possam introduzir falhas. A precisão do OCR depende da qualidade da origem, e a tradução automática é em grande parte neural — a qualidade varia e merece uma revisão humana.
Tempo e custo: De baixos a médios. A maioria das ferramentas online retorna em segundos a um minuto (frequentemente com limites de uso gratuito), não exige instalação local e é amigável a usuários não técnicos; o trabalho em volume exige pagamento ou créditos.
Prós e contras: Conveniente e eficiente, e substitui o texto diretamente na imagem sem precisar do arquivo de design original. Mas a qualidade depende da IA, às vezes exigindo novas tentativas ou ajuste fino do prompt, e você deve tratar direitos autorais e informações sensíveis com cuidado.
Melhor para: Localização cotidiana de imagens de produtos de e-commerce, anúncios e peças de redes sociais localizados, menus, panfletos e quadrinhos. Por exemplo, o ReWords mostra a substituição de "SUMMER SALE" na embalagem de um produto por "夏季特卖", mantendo o fundo idêntico, e o EditTextImage mostra "Summer sale — 30% off everything" traduzido para o alemão "Sommer-Sale — 30 % auf alles" com o layout inalterado. São cenários clássicos de localização.
Figura: Exemplo de tradução com ferramenta de IA online (à esquerda: original; à direita: traduzido).
Método 5: Aplicativos Móveis de Tradução Instantânea
Como funciona: Use um aplicativo de tradução de imagem do celular (Google Translate, modo câmera do Baidu Translate, Microsoft Translator) em uma foto ou imagem importada. A maioria reconhece o texto em tempo real e sobrepõe a tradução na tela, ou produz um instantâneo com o texto traduzido. Fluxo: tirar/importar uma foto → OCR automático → tradução automática → sobrepor ou marcar o original → ver o resultado.
Ferramentas: Aplicativo Google Translate, câmera do Baidu Translate, o scan-traduzir integrado do WeChat e similares.
Entrada / Saída: Uma foto ou captura de tela do celular na entrada; normalmente uma imagem sobreposta ou o texto traduzido na saída. Alguns oferecem uma imagem anotada salva.
Automação: Totalmente automática. Não exige entrada de texto — simples de operar.
Precisão e fidelidade: Baixa. O objetivo principal é a compreensão; a tradução usa uma fonte padrão e uma máscara de fundo grosseira, e o layout e o estilo originais não são preservados de forma alguma. A qualidade do OCR e da tradução é próxima à das ferramentas profissionais, mas a saída não é utilizável como arquivo de design publicável.
Tempo e custo: Extremamente baixos. Tradução em tempo real, geralmente alguns segundos.
Prós e contras: Rápido e conveniente, sem exigir conhecimento técnico — suficiente para o uso diário. Mas não consegue preservar o design original, pode adicionar um logotipo ou marca d'água, e a saída serve apenas para leitura de referência, não para publicação final.
Melhor para: Entender rapidamente menus, placas de rua e manuais estrangeiros durante viagens ou no dia a dia. Usuários que fotografam texto com o Baidu Translate e salvam a imagem frequentemente veem a marca da ferramenta ou um remendo cobrindo parte dela. Essas ferramentas servem mais como auxílio de leitura do que como localização formal.
Método 6: Edição com Grandes Modelos Multimodais (por exemplo, GPT-4 Vision)
Como funciona: Use os modelos de IA multimodais mais recentes (GPT-4V/4.5, edição de imagem do ChatGPT, edição do OpenAI DALL·E 3) para edição de imagem de alto nível por instrução. Você fornece a imagem original e usa um prompt em linguagem natural para "traduzir o texto mantendo o design inalterado". O modelo combina detecção de texto, compreensão semântica e geração de imagem para alterar as palavras preservando os elementos de layout e o estilo. Fluxo: imagem de entrada + instrução → o modelo reconhece e traduz o texto → o modelo gera uma nova imagem → revisão humana.
Ferramentas: OpenAI ChatGPT (com recursos de imagem como o GPT-4V), a API de edição de imagem do DALL·E 3, o Google Imagen Editor (principalmente em estágio de pesquisa) e acesso de desenvolvedor via API da OpenAI.
Entrada / Saída: Uma imagem mais um prompt de texto na entrada; uma nova imagem na saída (geralmente na resolução original ou conforme especificado).
Automação: Alta. Um prompt simples basta; o modelo faz o resto.
Precisão e fidelidade: Geralmente alta. Esses modelos preservam bem as relações de layout e o estilo. Exemplos oficiais da OpenAI mostram a tradução de um diagrama de instruções de uma máquina de café para o espanhol mantendo o layout, e a Atlas Cloud relata o GPT-4V traduzindo o texto de um infográfico para outros idiomas mantendo todo o resto intacto. Ainda assim, eles podem deixar passar algum texto ou introduzir pequenos deslocamentos — especialmente quando o comprimento do texto traduzido difere muito do original —, de modo que correções posteriores podem ser necessárias.
Tempo e custo: Médios. Gerar uma imagem geralmente leva de segundos a dezenas de segundos, mas modelos avançados exigem chamadas de servidor com custos de API ou assinatura, além do seu tempo escrevendo prompts e revisando a saída.
Prós e contras: Uma experiência amigável, com imagens traduzidas com um clique, e preserva as relações visuais (setas, legendas, hierarquia de layout) em fundos complexos. Mas o controle fino é limitado — espere erros de ortografia, algum texto não traduzido ou artefatos de composição que exigem um olhar humano. Ainda não substitui a diagramação fina, mas se sai bem na maioria dos cenários de marketing.
Melhor para: Localizar rapidamente infográficos, pôsteres e material promocional ilustrado. Por exemplo, você pode dar ao ChatGPT uma imagem de anúncio em inglês e o prompt "traduza todo o texto para o chinês, não mude nada mais", e o modelo gera a imagem no idioma correspondente.
Figura: Exemplo de tradução multimodal com GPT-4V (à esquerda: entrada em coreano; à direita: saída em vietnamita).
Método 7: Edição com Modelos de Difusão Profundos (DALL·E, Stable Diffusion)
Como funciona: A edição de imagem baseada em difusão mascara a região do texto na imagem original e depois gera conteúdo substituto a partir de um prompt. Fluxo geral: detectar o texto e gerar uma máscara → elaborar o prompt (por exemplo, "substitua X por Y, mantenha o fundo inalterado") → usar o DALL·E 3 ou o Stable Diffusion Inpainting para preencher → obter a nova imagem. Por exemplo, envie o original e uma máscara de texto à API da OpenAI e faça uma solicitação de edição para "substituir o texto".
Ferramentas: A API de edição do OpenAI DALL·E 3, o Adobe Firefly Generative Fill, o HuggingFace Diffusers (por exemplo, runwayml/stable-diffusion-inpainting). Controles como a detecção de texto do ControlNet e o inpainting do LaMa ajudam a marcar as regiões a substituir.
Entrada / Saída: O original + uma máscara de texto + um prompt na entrada; um arquivo de imagem na saída. O modelo geralmente combina automaticamente o idioma e o estilo da tradução.
Automação: De média a alta. A etapa de mascaramento precisa de uma ferramenta extra (desenhada à mão ou gerada por programação), mas a geração em si é com um clique.
Precisão e fidelidade: Alta, mas um pouco abaixo dos modelos dedicados à edição de texto. Modelos de difusão muitas vezes são imprecisos com textos longos (podem quebrar palavras), e a consistência de estilo depende da qualidade do prompt. O ponto forte é o reparo de fundo — ele consegue integrar as traduções a texturas complexas de forma natural. O ponto fraco é que às vezes as formas das letras ficam imperfeitas, com leve desfoque ou detalhes indesejados. Os melhores resultados exigem máscaras e prompts ajustados.
Tempo e custo: Médios. Gerar uma imagem costuma levar de dez a dezenas de segundos (ou depender da sua GPU localmente); serviços em nuvem adicionam tempo de fila.
Melhor para: Tradução criativa — arte conceitual, slogans em ilustrações — e qualquer caso em que uma leve mudança de estilo seja aceitável. No exemplo abaixo, o Stable Diffusion traduziu o banner em inglês "Summer sale — 30% off everything" para o alemão "Sommer-Sale — 30 % auf alles", re-renderizando-o e mantendo o fundo inalterado.
Figura: Exemplo de substituição de texto com Stable Diffusion (à esquerda: banner original em inglês; à direita: resultado em alemão).
Método 8: Pipeline Personalizado de Visão Computacional + Script
Como funciona: Um pipeline de automação totalmente construído por você. Use visão computacional para detectar regiões de texto (por exemplo, detecção de bordas/contornos com OpenCV ou um modelo de OCR profundo), combine com uma API de tradução automática e desenhe a tradução sobre a imagem original com uma biblioteca de imagem (Pillow/OpenCV). Etapas: detecção de texto → OCR e tradução por caixa → recortar e preencher o fundo da região do texto (com um algoritmo de inpainting) → desenhar o novo texto → saída.
Ferramentas: Python (Pillow, OpenCV, EasyOCR, pytesseract, APIs de tradução do Baidu ou Google), Adobe PixelSense, processamento de imagem em C#/.NET e similares.
Entrada / Saída: Um bitmap comum na entrada; um bitmap na mesma resolução na saída. Todo o fluxo é construído por você ou por script, sem GUI pronta para uso.
Automação: Alta (se o script for bem construído). Totalmente passível de processamento em lote.
Precisão e fidelidade: Depende dos detalhes do algoritmo. Consegue corresponder aproximadamente ao layout, mas geralmente não consegue combinar as fontes automaticamente — você escolhe a mais próxima à mão. Também não consegue reparar fundos de forma tão integrada quanto os modelos de difusão, normalmente preenchendo lacunas com uma cor plana ou a média da vizinhança, e é limitado em fundos complexos ou fontes não padronizadas.
Tempo e custo: Custo de desenvolvimento alto (exige programação), com tempo de execução dependendo da eficiência do OCR e do desenho (segundos por imagem). Em relação a serviços de terceiros, tem custo zero em dinheiro, mas exige muito esforço de codificação.
Prós e contras: Controle total sobre o pipeline e bom para automação em lote, mas a fidelidade aos detalhes de design fica atrás das ferramentas dedicadas de IA e exige ajuste de parâmetros e correção posterior. Encaixa-se em cenários de personalização profunda ou de privacidade de dados (sem rede pública).
Melhor para: Ambientes corporativos com requisitos de processo especiais, ou a substituição simples de rótulos em pequena escala — por exemplo, um comerciante criando um script para fazer OCR, traduzir e reescrever rótulos de imagens de produtos. Tecnicamente exigente, mas flexível.
Método 9: Serviço Profissional Humano + DTP
Como funciona: Terceirize para uma equipe de tradução e design. Um tradutor profissional traduz o texto primeiro, e então um designer de editoração eletrônica (DTP) substitui o texto passo a passo em relação ao original. Inclui: identificar e editar o arquivo de origem (PSD/InDesign) → traduzir o texto → ajustar o layout e re-renderizar no mesmo software.
Ferramentas: Geralmente a suíte Adobe, InDesign, Illustrator. Os fornecedores podem usar ferramentas de CAT (Trados, MemoQ) para manter a terminologia consistente, mas a saída final depende do software de design.
Entrada / Saída: Qualquer imagem ou arquivo de origem na entrada; tipicamente uma imagem localizada de alta qualidade ou um arquivo editável na saída.
Automação: Baixa. Um serviço totalmente manual, exigindo intervenção humana em cada etapa.
Precisão e fidelidade: Máxima. Tradutores e designers conseguem adaptar o texto para nuances culturais, ao mesmo tempo que preservam ou ajustam o design com precisão, e a qualidade da saída é garantida por profissionais.
Tempo e custo: Máximos. Os custos combinam taxas de tradução e tempo de design, geralmente muito mais altos que as opções automáticas. Serve bem a projetos de alto valor ou conteúdo muito sensível.
Prós e contras: Qualidade e confiabilidade de primeira linha, a um custo e um tempo muito maiores do que qualquer método automatizado.
Melhor para: Campanhas de imagem de marca, materiais importantes de feiras, conteúdo de imagem em documentos governamentais ou jurídicos e publicações localizadas que exigem revisão humana.
Método 10: Tradução Automática via Vetor / Arquivos de Origem
Como funciona: Se a imagem de origem veio de vetor ou de software de design, você pode substituir o texto dentro do ambiente de design. Por exemplo, o InDesign ou o Illustrator, com plugins ou scripts, podem extrair o texto via OCR ou conversão automática, traduzi-lo e reinseri-lo nos quadros de texto. Alternativamente, converta a imagem em PDF, faça OCR e tradução e importe-a de volta.
Ferramentas: Adobe Acrobat (OCR + exportação para Word), o recurso de localizar e substituir texto do Illustrator, scripts do InDesign ou plugins de terceiros (Lokalise, o plugin do InDesign do Transifex etc.).
Entrada / Saída: Geralmente um documento editável ou PDF na entrada; o texto substituído diretamente no arquivo original na saída.
Automação: Média. Depende da automação e do suporte a scripts do software.
Precisão e fidelidade: Alta. Como você edita a origem diretamente, todas as camadas e efeitos são preservados — desde que o arquivo original esteja disponível. Se for uma imagem já achatada, você precisa do auxílio do OCR e ele se comporta como o Método 2.
Tempo e custo: Médios. A substituição automatizada ainda precisa de ajuste fino humano.
Prós e contras: Diagramação precisa a partir do arquivo de origem, mas depende de ter o arquivo editável original e o software certo.
Melhor para: Projetos de tradução em que você detém a origem do design — por exemplo, traduzir um manual diagramado no InDesign — ou situações de emergência em que você faz uma tradução aproximada por OCR primeiro e depois refina no arquivo de origem.
A Comparação Lado a Lado
| Método | Fidelidade ao design | OCR / reconhecimento | Multilíngue | Dificuldade técnica | Custo | Velocidade | Melhor aplicação |
|---|---|---|---|---|---|---|---|
| 1. Software de design profissional (manual) | Muito alta | N/A (humano) | Qualquer | Alta (exige designer) | Máximo (mão de obra) | Lento (manual) | Peças de marca / marketing de alta exigência |
| 2. OCR + diagramação | Alta | Alta (texto estruturado) | Muitos | Média-alta (software/scripts) | Baixo (código aberto) | Médio | Documentos técnicos, diagramas rotulados, gráficos estruturados |
| 3. Serviço de tradução de documentos | Alta | Alta (OCR profissional) | Muitíssimos | Baixa (pronto para usar) | Média-alta (taxa de serviço) | Rápido | PDFs/digitalizações em lote, documentos profissionais |
| 4. Ferramentas de IA online (ReWords etc.) | Alta | Alta (IA) | Muitos | Baixa (pronto para usar) | Baixo/médio (grátis + pago) | Rápido | Pôsteres de e-commerce, quadrinhos, localização multiformato do dia a dia |
| 5. Aplicativos de câmera do celular | Baixa | Média-alta (feito à mão) | Muitos | Muito baixa (pronto para usar) | Baixo (grátis) | Tempo real | Leitura rápida para viagem / dia a dia |
| 6. Edição com grande modelo multimodal | Alta | Alta (modelo) | Muitíssimos | Baixa (pronto para usar) | Média-alta (taxa de API) | Médio | Infográficos, pôsteres de anúncios, capturas de UI que precisam de raciocínio rápido |
| 7. Modelos de difusão (DALL·E etc.) | Média-alta | Média (precisa de máscara) | Muitos | Média (técnica de prompt) | Médio (API/computação) | Médio | Design criativo, requisitos de estilo flexíveis |
| 8. Pipeline Python personalizado | Média | Média (depende da ferramenta) | Muitos | Alta (programação) | Baixo (código aberto) | Flexível (lote automático) | Ambientes de automação (personalização corporativa, lote) |
| 9. Profissional humano + DTP | Muito alta | N/A (humano) | Qualquer | Muito alta (equipe especializada) | Máximo (taxa de serviço) | Muito lento (manual) | Publicações de alto padrão, exigências rígidas de texto/formato |
| 10. Tradução direta do arquivo de origem | Muito alta | Alta (a partir da origem) | Muitos | Média (software de design) | Baixo (software existente) | Médio | Projetos com origem editável (livros em InDesign, tradução de relatórios) |
Nota: "fidelidade" aqui significa o quão próximo a imagem traduzida fica do design original. Os aplicativos de celular servem para compreensão e adicionam uma grande máscara, então a fidelidade é baixa; já o design profissional e os serviços de tradução de documentos preservam integralmente layout e fontes, então pontuam alto.
Três Tutoriais de Ponta a Ponta
Se você quer ir além de clicar em um botão, aqui estão as três abordagens que vale a pena aprender. Cada uma inclui o fluxo completo e código funcional.
Tutorial 1: Edição Multimodal com GPT-4 Vision
Visão geral: Este exemplo mostra como usar o GPT-4 da OpenAI com recursos de imagem (ou o DALL·E) para editar o texto dentro de uma imagem. Preparação: Registre-se na OpenAI e obtenha uma chave de API. Prepare uma imagem de exemplo com texto e uma máscara correspondente. Suponha que queremos traduzir o inglês "Summer sale" para o chinês "夏季特卖".
Fluxo: fornecer a imagem original → chamar o endpoint de edição do GPT-4V ou DALL·E → o modelo reconhece e traduz o texto → o modelo gera uma nova imagem → baixar e revisar.
- Prepare a imagem e a máscara. Certifique-se de que o original (
orig.png) e a máscara (mask.png) estejam alinhados, com a máscara cobrindo apenas a região do texto "Summer sale". - Chame a API (usando o SDK Python da OpenAI como exemplo):
```python import openai openai.api_key = "YOUR_API_KEY"
Peça ao modelo para traduzir o texto da área mascarada para o chinês
mantendo todo o resto inalterado.
response = openai.Image.create_edit( image=open("orig.png", "rb"), mask=open("mask.png", "rb"), prompt="用中文翻译上面的文字,不改变其他内容。", n=1, size="1024x768" )
Salve a imagem retornada em disco
with open("output.png", "wb") as f: f.write(response['data'][0]['image']) ```
Isso instrui o modelo a traduzir o texto da região mascarada para o chinês e a deixar o resto intacto, e então a gerar o resultado.
- Revise a saída. Confira o
output.png. O modelo deve ter substituído "Summer sale" por "夏季特卖", com um estilo de fonte semelhante e um fundo idêntico.
Figura: Exemplo de tradução com GPT-4V (à esquerda: coreano original; à direita: saída do modelo em vietnamita).
- Salve o resultado. Use o
output.pnge, opcionalmente, faça ajustes finos na posição ou no estilo do texto em um editor de imagens.
Ressalvas: Sempre revise o texto gerado pelo GPT-4V. Se algo estiver faltando, tente um prompt mais detalhado ou traduza em blocos menores. A API da OpenAI cobra pelo tamanho da imagem e pelo número de gerações.
Tutorial 2: Ferramentas de IA Online (ReWords / EditTextImage)
Visão geral: Use o aplicativo ReWords ou um site semelhante para traduzir uma imagem — o ReWords neste exemplo. Preparação: Abra uma ferramenta online como o ReWords ou o EditTextImage; não é necessária instalação.
Fluxo: enviar o original → o sistema faz OCR e detecta o texto → ele traduz automaticamente e mostra o texto sugerido → você ajusta o texto e bloqueia o que deve permanecer → a IA renderiza a nova imagem → baixar a imagem traduzida.
- Envie a imagem. Abra o site do ReWords, escolha a função "Translate Text in Image" e envie a imagem a traduzir (aqui, um anúncio contendo "SUMMER SALE").
- Escolha um idioma e edite. A plataforma detecta todas as linhas de texto, você escolhe o idioma de destino (por exemplo, chinês) e ela retorna sugestões linha a linha. Corrija eventuais erros de tradução e bloqueie palavras que não devem mudar (como nomes de marcas).
- Gere a imagem. Clique em Generate ou Apply, e a IA remove o texto original e redesenha a tradução com a fonte, a cor e o fundo originais.
- Baixe o resultado. Baixe a nova imagem. No exemplo abaixo, a esquerda é a imagem original "SUMMER SALE" e a direita é a versão "夏季特卖" gerada pelo ReWords.
Figura: Exemplo de tradução de imagem com ReWords (à esquerda: original; à direita: traduzida por IA).
Dicas: Essas ferramentas geralmente têm uma cota gratuita (o ReWords inclui várias gerações gratuitas por imagem), com pagamento ou créditos além disso. A qualidade da tradução é alta, mas verifique o texto — especialmente números e nomes próprios. É ideal quando você não consegue obter o arquivo de design original e precisa localizar a imagem diretamente.
Tutorial 3: Tradução Automatizada com Python OCR + OpenCV
Visão geral: Um script que extrai o texto de uma imagem, traduz e o re-renderiza na imagem. Usaremos Tesseract OCR com OpenCV/Pillow para traduzir uma imagem em espanhol para o inglês.
Fluxo: carregar o original → detecção de texto e OCR (Tesseract) → chamar um motor de tradução (API do Google Translate) → usar o OpenCV para limpar a região do texto original → desenhar a tradução com o Pillow → gerar a imagem localizada.
- Instale as dependências (primeiro o Tesseract-OCR e as bibliotecas Python):
```bash
Instale o Tesseract (exemplo para Ubuntu)
sudo apt-get install tesseract-ocr
Instale as bibliotecas Python
pip install pytesseract pillow googletrans==4.0.0-rc1 ```
- O script:
```python from PIL import Image, ImageDraw, ImageFont import pytesseract from googletrans import Translator
Carregue a imagem original
image = Image.open("image_with_text.png")
Execute o OCR (reconhece texto em espanhol)
text = pytesseract.image_to_string(image, lang='spa') print("Recognized text:", text)
Traduza o texto
translator = Translator() result = translator.translate(text, src='es', dest='en') print("Translation:", result.text)
Neste exemplo a posição do texto é conhecida; em produção você
usaria pytesseract.image_to_boxes para obter uma caixa por caractere.
x, y, w, h = 50, 50, 300, 50 # exemplo de coordenadas
Apague o texto original na imagem
draw = ImageDraw.Draw(image) draw.rectangle(((x, y), (x + w, y + h)), fill="white") # cubra com branco
Desenhe o texto traduzido
font = ImageFont.truetype("arial.ttf", size=36) draw.text((x, y), result.text, font=font, fill="black")
Salve a saída
image.save("translated_image.png") ```
- Como funciona: o script primeiro faz OCR do original com o Tesseract, busca a tradução com o Google Translate (
googletrans) e depois usa o Pillow para apagar a região original e desenhar a tradução. O exemplo lida com uma região fixa; uma aplicação real determinaria as regiões dinamicamente a partir dos resultados do OCR e combinaria as fontes (aqui simplificado para fins de ilustração). - Saída: a execução produz
translated_image.png, com a região do texto original substituída pela tradução em inglês.
Ressalvas: Este fluxo depende da precisão do posicionamento do OCR e da capacidade de correspondência de fontes. Na prática, combine a detecção de contornos do OpenCV para um recorte preciso e use o Pillow para medir a largura do texto e fazer a quebra de linha automática. Para texto com várias linhas, faça um loop sobre cada segmento. O conjunto todo pode ser processado em lote, mas a fidelidade ao layout fica atrás dos métodos de inpainting por IA, então faça testes e conte com o ajuste de parâmetros.
Como Escolher: Um Guia de Decisão
Combine o método com três coisas — fidelidade, custo e ter ou não o arquivo de origem:
- Você não tem arquivo de origem e quer rapidez (o caso comum): use uma ferramenta de IA online como o ReWords AI (Método 4). Envie, escolha um idioma, gere, baixe.
- A imagem tem muito texto e é estruturada (gráficos, manuais, diagramas): OCR + diagramação (Método 2) ou, para trabalho em lote, um serviço de tradução de documentos com preservação de formato (Método 3).
- O resultado precisa ser perfeito para impressão e crítico para a marca: design manual (Método 1) ou profissional humano + DTP (Método 9).
- Você quer automatizar dentro do seu próprio fluxo de trabalho: uma API de modelo multimodal (Método 6) ou um pipeline Python personalizado (Método 8).
- Você precisa traduzir uma captura rápida só para ler: um aplicativo de câmera do celular (Método 5) — mas nunca para publicação.
- Você ainda tem o arquivo de origem editável: edite-o diretamente (Método 10). Este é o caminho mais limpo possível quando está disponível.
Cinco Regras para Preservar o Design
Qualquer que seja o caminho escolhido, estes hábitos separam o "traduzido" do "profissionalmente localizado":
- Planeje as mudanças no comprimento do texto. O alemão e o francês costumam expandir; o chinês e o japonês, contrair. Conte com redimensionar, requebrar ou ajustar o espaçamento, e nunca assuma que a tradução cabe na caixa original como está.
- Combine a fonte, não apenas as palavras. Reproduza o peso, a cor, o espaçamento entre letras e qualquer traço ou sombra originais. Uma tradução perfeita com a tipografia errada ainda soa errada.
- Reconstrua o fundo de forma limpa. A área reparada atrás do texto deve ser indistinguível do entorno — suavize as bordas e confira a emenda com zoom 1:1.
- Cuide dos elementos não textuais. Setas, chamadas, numeração e legendas frequentemente carregam ou apontam para texto; leve-os em conta para que a versão localizada permaneça coerente.
- Revise a própria tradução. A tradução automática é rápida, mas imperfeita. Números, unidades, nomes de marcas e nomes próprios merecem uma verificação humana antes de você publicar.
A Conclusão
Você não precisa do arquivo de design original para traduzir o texto dentro de uma imagem. Você precisa escolher o método certo para a fidelidade que busca — e, para a maioria das imagens do dia a dia, esse método é uma ferramenta de IA com um clique que lê o texto, o traduz e o redesenha no lugar, sem perturbar o layout.
Quando os riscos são altos e a imagem é complexa, as ferramentas mais pesadas — design manual, serviços de documentos ou DTP profissional — ainda fazem jus ao seu lugar. Mas, para a grande maioria de menus, pôsteres, imagens de produtos e peças de redes sociais, você consegue localizar em minutos.
Pegue uma imagem que você vem querendo traduzir, envie-a ao ReWords AI e veja com que fidelidade uma tradução por IA de um minuto preserva o design, antes de considerar a rota manual.
References
- Documentação de edição de imagem e edição do DALL·E da OpenAI.
- Pesquisa sobre tradução de PDF e imagens com preservação de formato.
- Reportagem da Atlas Cloud sobre extração por OCR e recolocação em fluxos de design.
- Documentação de produtos de ferramentas online de tradução de imagem (ReWords AI, EditTextImage e similares).
- Documentação do Tesseract OCR, OpenCV e Pillow para pipelines personalizados.