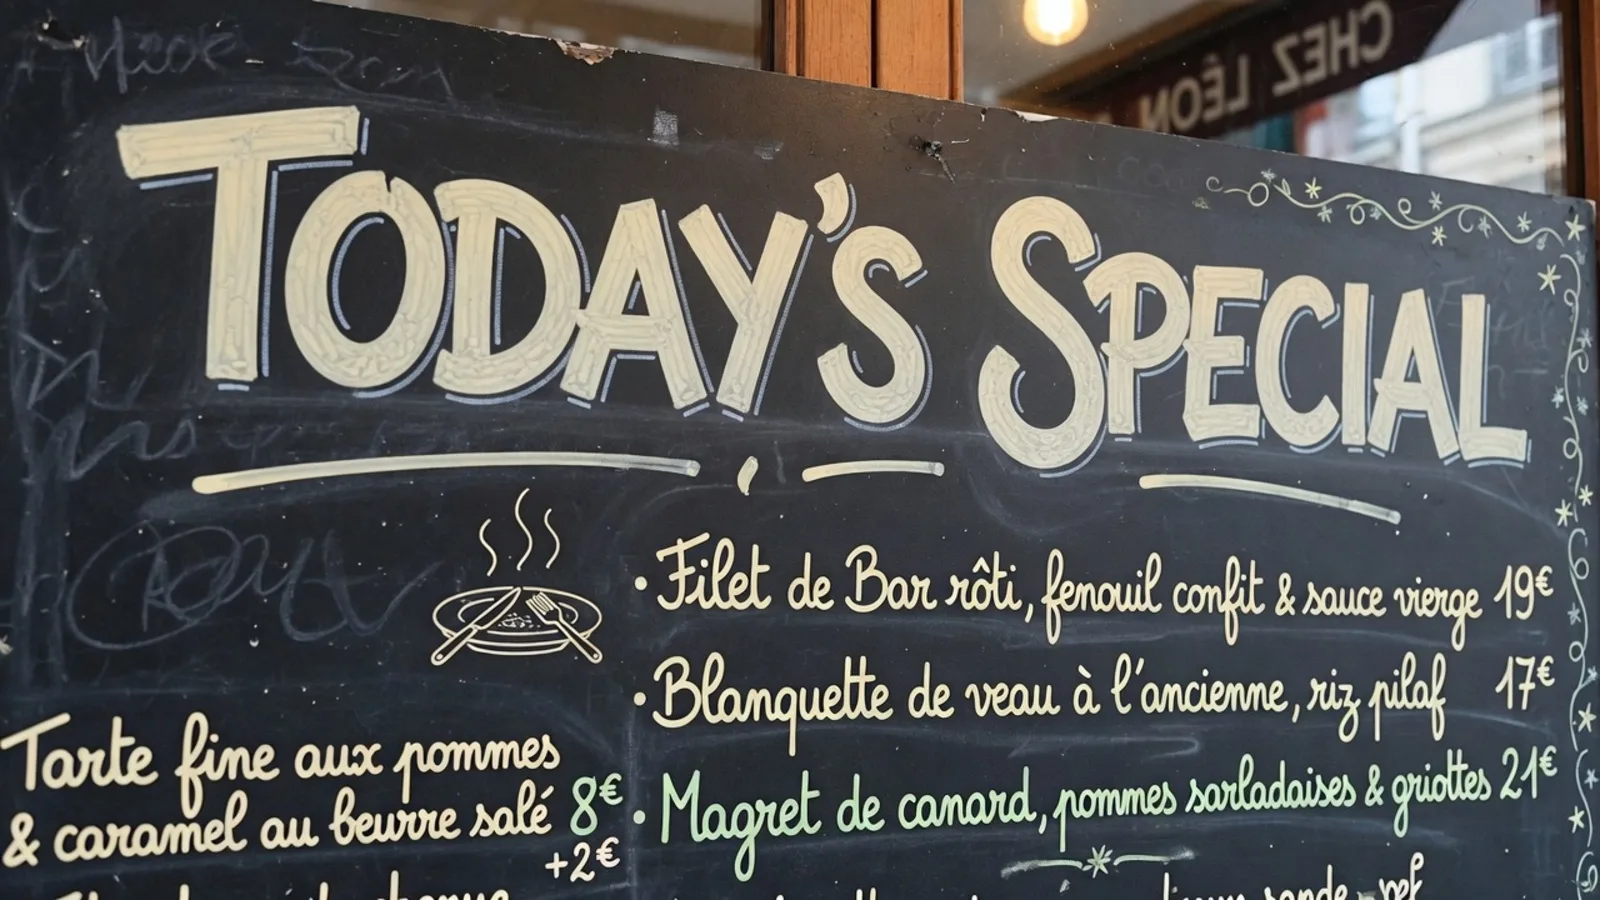
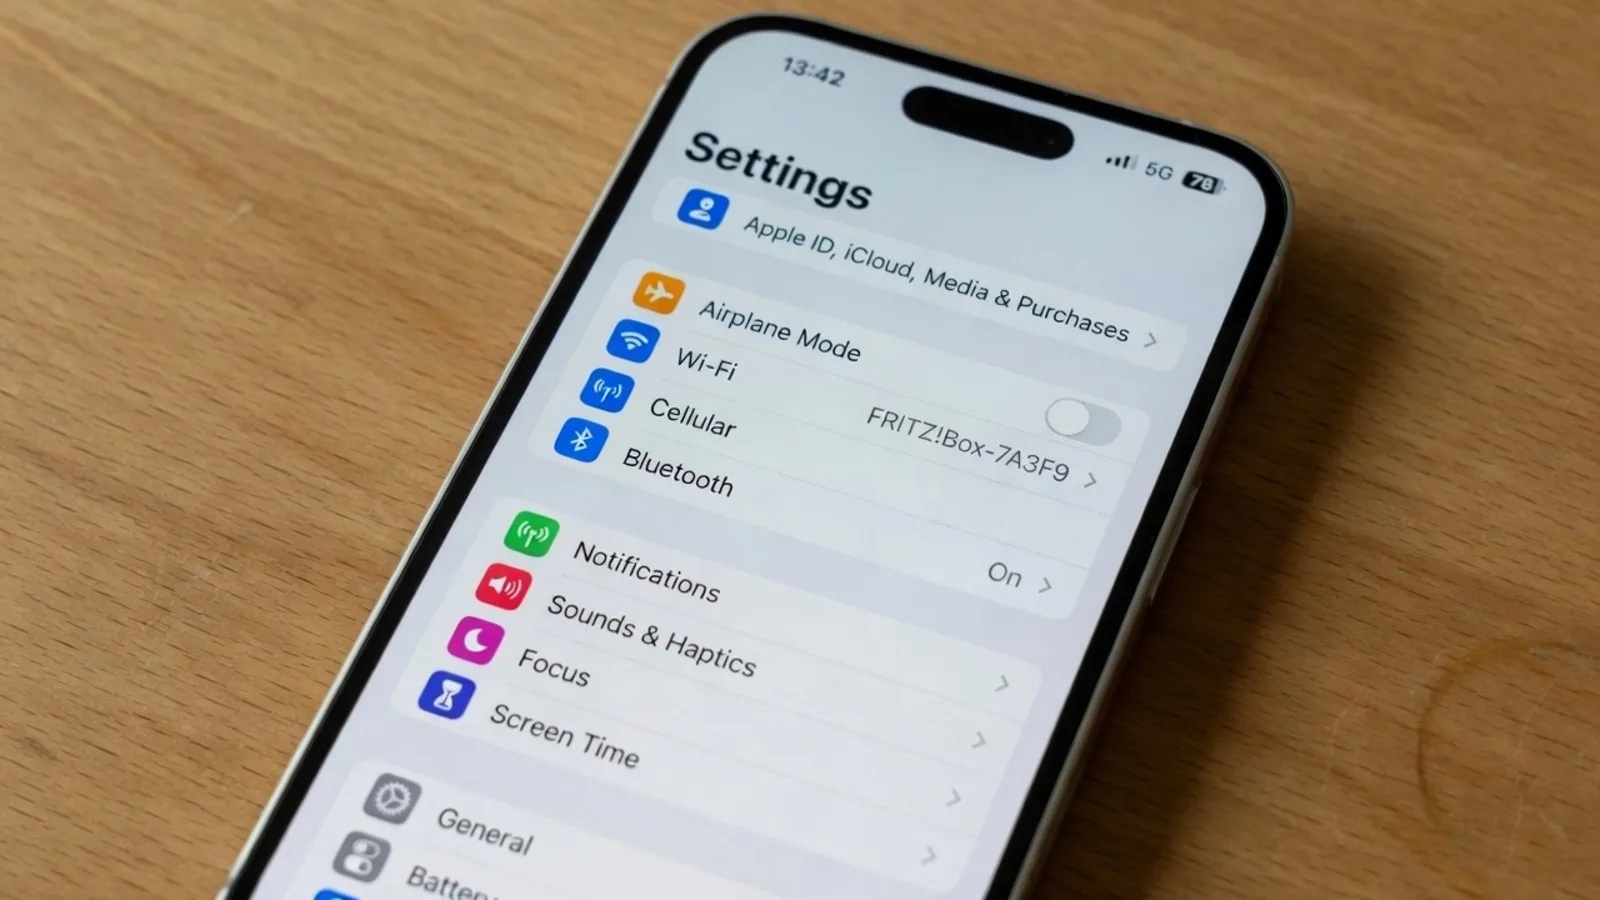
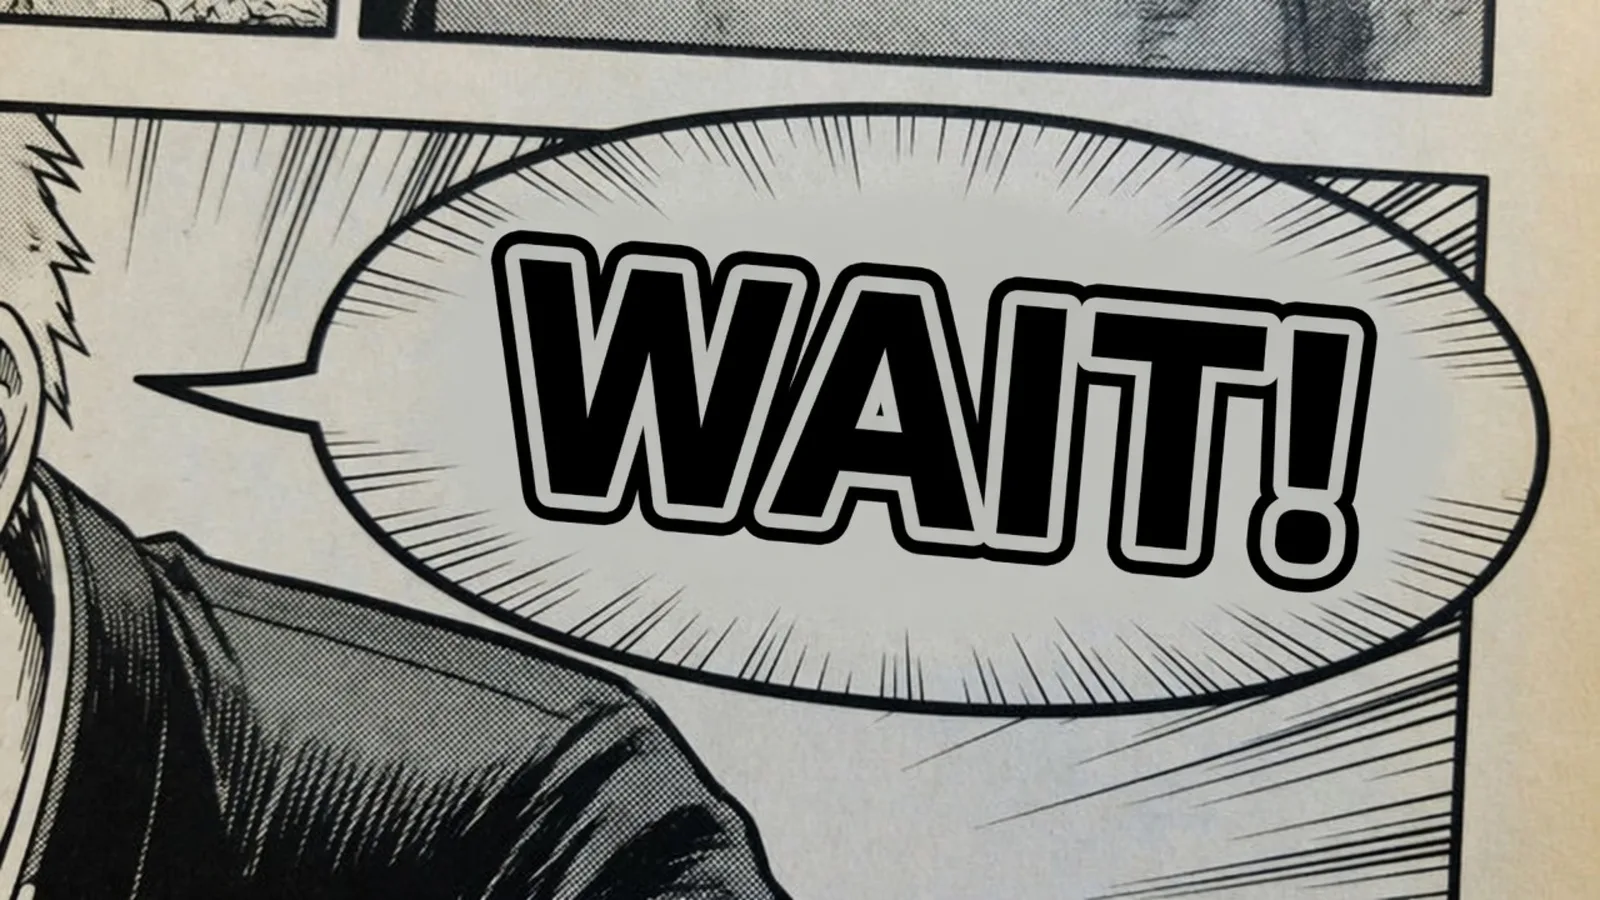
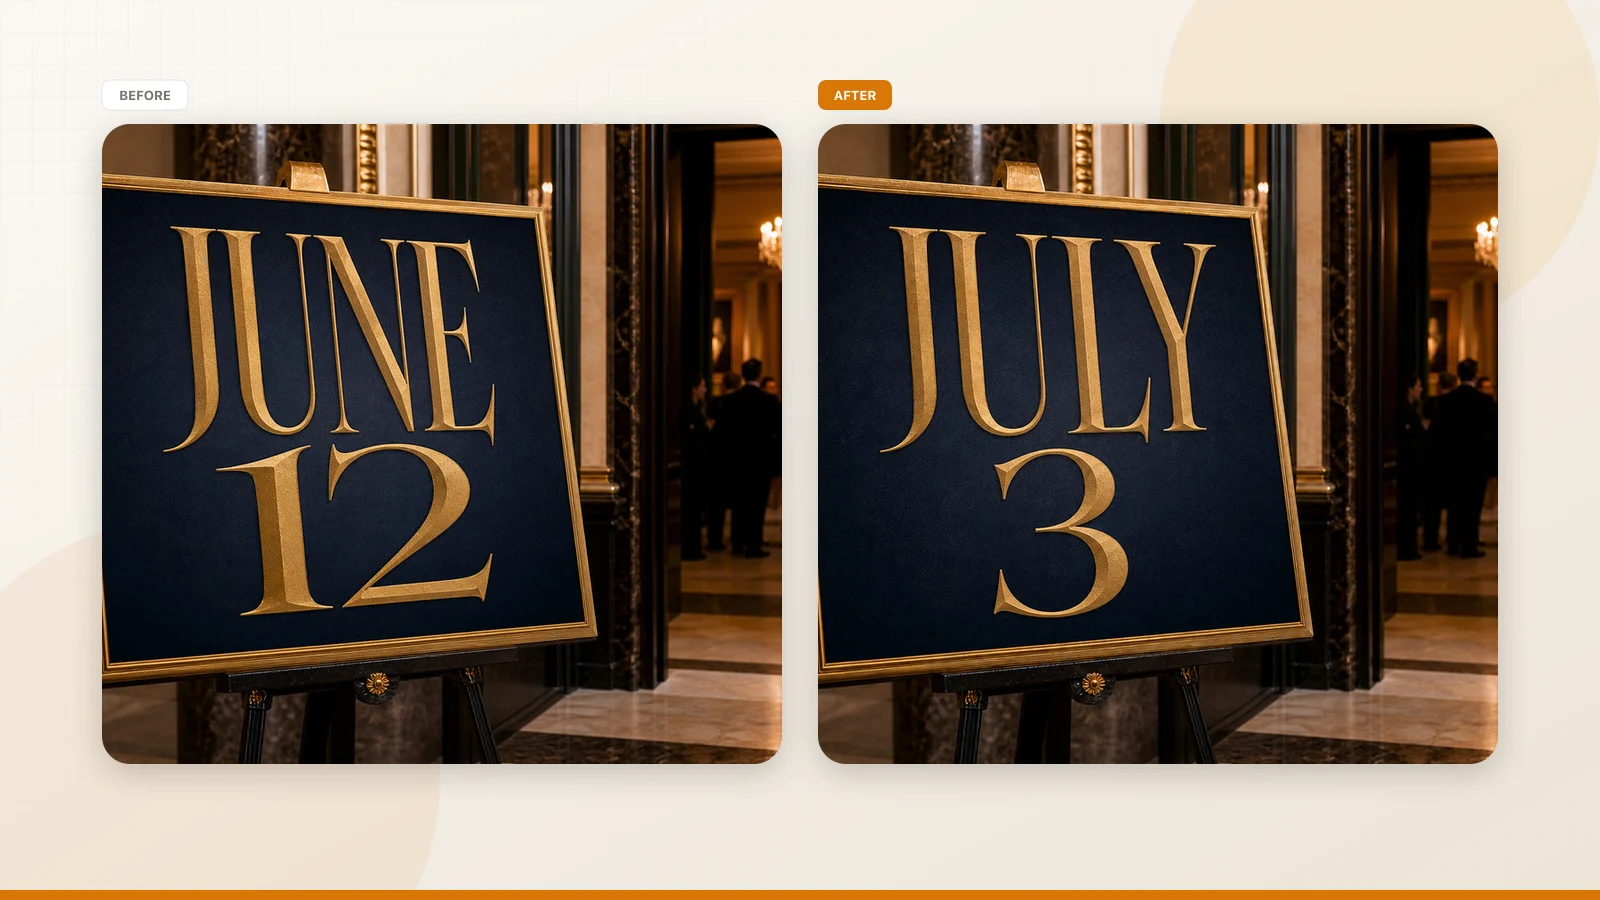
Dieci modi per localizzare le parole dentro un'immagine già pronta — mantenendo il layout, i font e lo sfondo esattamente come li ha lasciati il designer.
Un poster pubblicitario in inglese. Un menu in giapponese. Un'etichetta di prodotto in tedesco. Un diagramma tecnico etichettato in spagnolo. Ti serve ciascuno in un'altra lingua — e tutto ciò che hai è l'immagine esportata.
Tradurre un documento è facile: consegni il testo a un traduttore, ricevi indietro le parole. Tradurre il testo dentro un'immagine è tutta un'altra cosa. Non stai solo cambiando parole. Stai modificando i pixel con precisione chirurgica mentre il layout di un designer ti osserva dalla tua spalla, e qualsiasi errore — un font leggermente sbagliato, uno sfondo che non si allinea del tutto, una parola tradotta più lunga del 30% rispetto all'originale — è immediatamente visibile.
È proprio questo il problema che rende la localizzazione delle immagini così scomoda: devi cambiare il significato senza cambiare il design. Il resoconto che segue mappa dieci approcci reali per farlo esattamente, dal lavoro del designer completamente manuale all'AI con un solo clic, completo di fedeltà, costo e modalità di fallimento di ciascuno.
Traduci testo in immagini
Traduci in automatico testi incorporati e ridisegna la grafica con il nostro traduttore gratis online.
Perché tradurre il testo dentro un'immagine è così difficile
Quando traduci un documento, il layout si adatta. Quando traduci del testo incorporato in un'immagine, il layout è congelato nei pixel. Questo singolo vincolo genera una serie di problemi:
La lunghezza del testo cambia. Una breve frase in inglese può gonfiarsi del 30% o più in tedesco o francese, mentre la stessa frase si riduce drasticamente in cinese o giapponese. Lo spazio nel design originale è fisso, quindi la traduzione deve essere riadattata — ridimensionata, riscritta a capo o ricalibrata nella spaziatura — senza rompere la composizione.
I font e lo stile devono corrispondere. Il carattere originale, il peso, il colore, la spaziatura tra le lettere e gli effetti come ombre o contorni devono essere tutti riprodotti. Sbagliali e la versione localizzata apparirà sottilmente estranea accanto all'originale.
Lo sfondo deve essere ricostruito. Cancellare il testo di partenza distrugge i pixel che gli stanno sotto. Su un colore pieno è banale; su una foto, un gradiente o una texture, stai ricostruendo un'immagine mancante.
Anche gli elementi non testuali richiedono attenzione. Frecce, richiami, numerazioni e legende spesso contengono testo o puntano a esso, quindi una localizzazione pulita deve tenerne conto.
Ogni metodo descritto sotto è un modo diverso di bilanciare questi quattro problemi. La scelta giusta dipende da quanto fedele deve essere il risultato, da quanto testo contiene l'immagine e se possiedi il file sorgente originale.
La strada più rapida: la traduzione di immagini con AI online
Prima dei metodi manuali, sappi che esiste una scorciatoia — ed è quella con cui la maggior parte delle persone dovrebbe iniziare.
Gli strumenti AI online creati proprio per questo compito, come ReWords AI, combinano rilevamento del testo, traduzione automatica e inpainting delle immagini con AI in un unico flusso. Invece di sovrapporre un nuovo riquadro di testo, rilevano il testo già presente nell'immagine, lo traducono, cancellano l'originale, ricostruiscono lo sfondo e ridisegnano la traduzione con font, colore e dimensione corrispondenti — così il layout resta al suo posto.
Come funziona:
- Carica l'immagine. Apri lo strumento, scegli la funzione «Traduci testo nell'immagine» e carica la foto (ad es. un annuncio con un banner "SUMMER SALE").
- Scegli una lingua e modifica. La piattaforma rileva automaticamente ogni riga di testo. Seleziona la lingua di destinazione e riceverai un suggerimento di traduzione riga per riga che puoi correggere a mano. Blocca le parole che non devono cambiare, come i nomi dei marchi.
- Genera. Clicca su Generate o Apply, e l'AI rimuove il testo originale e ridisegna la traduzione usando il font, il colore e lo sfondo originali.
- Scarica. Controlla il risultato e scarica l'immagine localizzata.
Figura: esempio di traduzione con AI online (a sinistra: originale, a destra: tradotta).
Perché è la scelta predefinita: non richiede alcun file di progetto sorgente, nessuna installazione di software e nessuna competenza di design. Un'immagine tipica ritorna in pochi secondi o in un minuto. Gli strumenti di questa categoria di solito includono una quota gratuita (ReWords offre alcune generazioni gratuite per immagine), con crediti a pagamento oltre tale soglia.
Dove prestare attenzione: la traduzione stessa merita un controllo — soprattutto numeri e nomi propri — e testo denso, illuminazione complessa o font estremamente decorativi possono occasionalmente mettere in difficoltà la ricostruzione dell'AI. Vale anche la pena prestare attenzione al copyright e ai contenuti sensibili.
Ideale nel mondo reale per: immagini di prodotti e-commerce, grafiche pubblicitarie e social localizzate, menu, volantini e fumetti — i lavori di localizzazione quotidiani in cui non possiedi più il file originale.
Il kit completo: 10 modi per tradurre il testo nelle immagini senza rompere il design
Se l'immagine è complessa, la posta in gioco è alta, o preferisci costruire la tua pipeline, ecco tutti e dieci gli approcci che vale la pena conoscere. Ciascuno elenca come funziona, di cosa ha bisogno, quanto è fedele e a chi è destinato.
Metodo 1: modifica manuale del design (Photoshop / Illustrator)
Come funziona: un designer professionista lo fa a mano. Prima estrae il testo originale (tramite OCR o trascrizione manuale) e lo traduce. Poi, in Photoshop, Illustrator o uno strumento simile, ridigita la traduzione con un font e uno stile corrispondenti sopra l'area del testo originale. La pipeline procede così: estrai il testo → traduci e rileggi → trova o ricrea il font corrispondente → cancella il testo originale, inserisci la traduzione e regola gli effetti.
Strumenti: Adobe Photoshop, Illustrator, InDesign, GIMP, Figma; strumenti OCR come Tesseract possono aiutare nell'estrazione.
Input / Output: in ingresso qualsiasi formato immagine (PNG/JPEG); in uscita una nuova immagine nello stesso formato, oppure un file PSD/AI modificabile con livelli.
Automazione: bassa. Prevalentemente manuale, con automazione solo nella fase di estrazione OCR.
Precisione e fedeltà: massime. Il designer controlla completamente font, posizione e stile e può riprodurre il design originale al pixel. La fedeltà dipende dall'abilità, è lento e risente dell'espansione della lunghezza della traduzione.
Tempo e costo: elevati. Una modifica professionale può richiedere da minuti a ore a seconda della complessità, e il software ha una curva di apprendimento — inefficiente quando traduci in grandi quantità.
Pro e contro: preserva completamente layout e stile (in teoria una sostituzione senza giunture), il che si adatta a testi di marketing e di brand esigenti. Ma è lento, costoso e soggetto a errori, e a meno che tu non disponga del font identico, è difficile ottenere una corrispondenza perfetta.
Ideale per: poster pubblicitari, design di packaging, prototipi di UI e materiale stampato che richiedono una localizzazione ad alta fedeltà.
Nota di caso: Atlas Cloud fa notare che, dopo che l'OCR ha estratto il testo, questo deve comunque essere «rimesso nel design» a mano, mentre la pura modifica dell'immagine fonde le modifiche su un nuovo livello raster con minor controllo sulle singole lettere — la composizione manuale è più lenta ma la più precisa.
Metodo 2: OCR + composizione con software di design
Come funziona: una pipeline leggermente più automatizzata, semi-manuale. Prima esegui l'OCR sull'immagine per estrarre il contenuto e la posizione di ogni riquadro di testo. Poi ottieni le traduzioni tramite traduzione automatica o umana. Infine, ri-renderizza la traduzione nell'immagine nelle posizioni e negli stili originali usando un software di impaginazione o uno script. Pipeline: riconoscimento OCR → traduzione del testo → ricostruzione del layout → immagine di output.
Strumenti: librerie e app OCR (Tesseract, EasyOCR, OCR di Adobe Acrobat); API di traduzione (Google Translate, DeepL, Baidu Translate); strumenti di impaginazione (Adobe InDesign, Photoshop, oppure Pillow/Matplotlib in un ambiente di programmazione).
Input / Output: in ingresso qualsiasi formato immagine (PNG/JPEG); in uscita una nuova immagine. Nel mezzo si può usare un documento vettoriale (PDF/AI) per preservare il layout.
Automazione: media. OCR e traduzione possono essere automatizzati, ma la composizione finale di solito richiede una mano umana — soprattutto quando la lingua di partenza e quella di arrivo differiscono molto in lunghezza e devi regolare dimensione del font e interlinea.
Precisione e fedeltà: elevate. Se fai corrispondere i font e le posizioni dei riquadri, il layout è ben preservato. Ma l'espansione della traduzione può rompere la distribuzione spaziale originale, richiedendo ridimensionamento o ritorno a capo, e gli errori di posizionamento su grafiche complesse danneggiano la fedeltà.
Tempo e costo: medi. La parte di OCR e traduzione è veloce (da secondi a minuti), ma la successiva composizione richiede da minuti a decine di minuti.
Pro e contro: più veloce del lavoro puramente manuale, ma dipende dalla precisione dell'OCR e dalla corrispondenza dei font; possono insinuarsi piccole differenze di crenatura e legature. Si adatta a immagini ricche di testo con elevate esigenze di design. Il problema: non gestisce gli elementi non testuali (linee di richiamo, numerazione) — quelli richiedono lavoro manuale.
Ideale per: localizzare annotazioni di grafici, manuali tecnici e diagrammi didattici con molti elementi testuali.
Contesto: gli strumenti di traduzione PDF seguono in genere questa logica — analizzano la struttura del documento, traducono regione per regione, poi «sostituiscono il testo sul posto e preservano il layout». Esegui OCR e traduzione blocco per blocco su un'immagine e ottieni lo stesso risultato sul posto.
Metodo 3: servizi dedicati di traduzione di documenti (con conservazione del formato)
Come funziona: usa un servizio di traduzione aziendale o online che preserva il formato. Questi strumenti analizzano il layout e i font nel file o nell'immagine di input, traducono automaticamente ogni blocco di testo e ricompongono l'output. Passaggi chiave: analisi del layout (individuare coordinate dei riquadri di testo, font) → traduzione del testo (servizio cloud o MT locale) → ri-renderizzazione del layout → file di output. Le immagini in genere vengono preservate intatte.
Strumenti: piattaforme online o software commerciali come PDFTranslator (motori Gemini + ChatGPT), la piattaforma Pangeanic ECO, Pairaphrase e Smartcat. Molti accettano input PDF o immagine e restituiscono un PDF o una grafica tradotti che mantengono lo stile originale.
Input / Output: in ingresso scansioni, immagini o PDF (JPG/PNG/PDF); in uscita un file tradotto nello stesso formato, con layout, tabelle e posizioni delle grafiche sostanzialmente intatti.
Automazione: alta. Il sistema funziona end to end, richiedendo solo una leggera rilettura umana.
Precisione e fedeltà: elevate. I servizi avanzati usano OCR ad alta precisione più LLM/sistemi di traduzione dedicati per ottenere una mappatura a livello di coordinate di testo e formato. Layout e font vengono preservati (la fedeltà a livello di documento può raggiungere il 90%+), con errori dovuti principalmente alle differenze di lunghezza della traduzione.
Tempo e costo: bassi. La traduzione è veloce — da secondi a minuti per la maggior parte dei lavori (un PDF di 60 pagine in pochi minuti). Ma di solito è un servizio a pagamento o richiede l'acquisto di quota API.
Pro e contro: il vantaggio è l'elevata automazione, il risparmio di tempo e una buona fedeltà. Lo svantaggio è la sensibilità ai costi delle API (documenti in grandi quantità o lunghi costano) e il supporto limitato per layout insoliti o scrittura a mano. Si adatta alla traduzione in batch di documenti o immagini.
Ideale per: documenti tecnici multilingue aziendali, manuali di prodotto, materiali di formazione e report finanziari in cui il layout deve essere preservato fedelmente. Sotto il cofano, questi sistemi sono essenzialmente la pipeline OCR + traduzione + composizione automatica.
Metodo 4: strumenti online di traduzione immagini con AI
Come funziona: servizi AI dedicati traducono e modificano il testo direttamente in un'immagine, spesso usando il deep learning per «mascherare e ridipingere» automaticamente. In genere: carica l'originale → OCR automatico delle regioni di testo → traduzione automatica (con rilettura manuale) → il modello cancella l'originale e ridipinge la traduzione con uno stile di font simile → scarica la nuova immagine. Questi strumenti raggruppano OCR, MT e completamento dell'immagine in una traduzione con un solo clic.
Strumenti: ReWords AI, ImageGPT, EditTextImage, Codia, VisualGPT e simili. Le interfacce spesso ti permettono di bloccare le righe di testo che non devono cambiare e di modificare la traduzione suggerita.
Input / Output: in ingresso una normale bitmap (PNG/JPEG); in uscita una bitmap della stessa risoluzione, con la traduzione resa nello stile originale.
Automazione: alta. Carichi e clicchi «generate»; l'AI gestisce i passaggi intermedi.
Precisione e fedeltà: nel complesso elevate. I moderni modelli generativi fanno corrispondere abbastanza bene lo stile del font e la texture dello sfondo da produrre risultati «senza modifiche visibili», anche se testo molto denso, illuminazione complessa o font altamente decorativi possono introdurre difetti. La precisione dell'OCR dipende dalla qualità della sorgente, e la traduzione automatica è in gran parte neurale — la qualità varia e richiede una revisione umana.
Tempo e costo: da bassi a medi. La maggior parte degli strumenti online restituisce il risultato in pochi secondi o in un minuto (spesso con limiti d'uso gratuiti), non richiede installazione locale ed è adatta a utenti non tecnici; il lavoro in grandi quantità richiede pagamento o crediti.
Pro e contro: comodo ed efficiente, e sostituisce il testo direttamente sull'immagine senza il file di progetto originale. Ma la qualità dipende dall'AI, a volte richiedendo nuovi tentativi o una messa a punto del prompt, e dovresti gestire copyright e informazioni sensibili con cura.
Ideale per: la localizzazione quotidiana di immagini di prodotti e-commerce, annunci e grafiche social localizzate, menu, volantini e fumetti. Per esempio, ReWords mostra la sostituzione di "SUMMER SALE" su una confezione di prodotto con "夏季特卖" mantenendo lo sfondo identico, e EditTextImage mostra "Summer sale — 30% off everything" tradotto in tedesco "Sommer-Sale — 30 % auf alles" con il layout invariato. Questi sono scenari classici di localizzazione.
Figura: esempio di traduzione con strumento AI online (a sinistra: originale, a destra: tradotta).
Metodo 5: app mobili di traduzione istantanea
Come funziona: usa l'app di traduzione di immagini di un telefono (Google Translate, modalità fotocamera di Baidu Translate, Microsoft Translator) su una foto o un'immagine importata. La maggior parte riconosce il testo in tempo reale e sovrappone la traduzione sullo schermo, oppure produce un'istantanea con il testo tradotto. Flusso: scatta/importa una foto → OCR automatico → traduzione automatica → sovrapponi o evidenzia l'originale → visualizza il risultato.
Strumenti: app Google Translate, fotocamera di Baidu Translate, scansione-traduzione integrata di WeChat e simili.
Input / Output: in ingresso una foto o uno screenshot del telefono; in uscita di solito un'immagine sovrapposta o il testo tradotto. Alcuni offrono un'immagine annotata salvata.
Automazione: completamente automatica. Non richiede input di testo — semplice da usare.
Precisione e fedeltà: basse. L'obiettivo principale è la comprensione; la traduzione usa un font predefinito e una mascheratura grossolana dello sfondo, e il layout e lo stile originali non vengono affatto preservati. La qualità di OCR e traduzione è vicina a quella degli strumenti professionali, ma l'output non è utilizzabile come file di design pubblicabile.
Tempo e costo: estremamente bassi. Traduzione in tempo reale, di solito pochi secondi.
Pro e contro: veloce e comodo, senza alcuna competenza richiesta — sufficiente per l'uso quotidiano. Ma non può preservare il design originale, può aggiungere un logo o una filigrana, e l'output è solo per lettura di riferimento, non per la pubblicazione finale.
Ideale per: comprendere rapidamente menu, cartelli stradali e manuali in lingua straniera durante i viaggi o nella vita quotidiana. Gli utenti che fotografano il testo con Baidu Translate e salvano l'immagine spesso vedono il marchio dello strumento o una toppa che ne copre una parte. Questi strumenti sono più adatti all'assistenza alla lettura che alla localizzazione formale.
Metodo 6: modifica con modelli multimodali di grandi dimensioni (es. GPT-4 Vision)
Come funziona: usa i più recenti modelli AI multimodali (GPT-4V/4.5, modifica immagini di ChatGPT, modifica DALL·E 3 di OpenAI) per una modifica delle immagini di alto livello basata su istruzioni. Inserisci l'immagine originale e usi un prompt in linguaggio naturale per «tradurre il testo mantenendo il design invariato». Il modello combina rilevamento del testo, comprensione semantica e generazione di immagini per cambiare le parole preservando gli elementi del layout e lo stile. Flusso: immagine di input + istruzione → il modello riconosce e traduce il testo → il modello genera una nuova immagine → rilettura umana.
Strumenti: OpenAI ChatGPT (con funzionalità immagini come GPT-4V), l'API di modifica immagini DALL·E 3, Google Imagen Editor (per lo più in fase di ricerca) e accesso per sviluppatori tramite l'API OpenAI.
Input / Output: in ingresso un'immagine più un prompt testuale; in uscita una nuova immagine (di solito alla risoluzione originale o come specificato).
Automazione: alta. Basta un semplice prompt; il modello fa il resto.
Precisione e fedeltà: generalmente elevate. Questi modelli preservano bene le relazioni del layout e lo stile. Gli esempi ufficiali di OpenAI mostrano la traduzione in spagnolo di un diagramma di istruzioni di una macchina per il caffè mantenendo il layout, e Atlas Cloud riferisce che GPT-4V traduce il testo di infografiche in altre lingue lasciando intatto tutto il resto. Tuttavia, possono saltare parte del testo o introdurre piccoli spostamenti — soprattutto quando la lunghezza del testo tradotto differisce molto dall'originale — perciò potrebbero servire correzioni successive.
Tempo e costo: medi. Generare un'immagine richiede di solito da secondi a decine di secondi, ma i modelli avanzati richiedono chiamate al server con costi di API o abbonamento, più il tuo tempo per scrivere i prompt e rivedere l'output.
Pro e contro: un'esperienza amichevole con immagini tradotte con un solo clic, e preserva le relazioni visive (frecce, legende, gerarchia del layout) su sfondi complessi. Ma il controllo fine è limitato — aspettati errori di ortografia, del testo non tradotto o artefatti di compositing che richiedono l'occhio umano. Non può ancora sostituire la composizione tipografica fine, ma si comporta bene nella maggior parte degli scenari di marketing.
Ideale per: localizzare rapidamente infografiche, poster e materiale promozionale illustrato. Per esempio, puoi dare a ChatGPT un'immagine pubblicitaria in inglese e il prompt "traduci tutto il testo in cinese, non cambiare nient'altro", e il modello genera l'immagine nella lingua corrispondente.
Figura: esempio di traduzione multimodale con GPT-4V (a sinistra: input in coreano, a destra: output in vietnamita).
Metodo 7: modifica con modelli di diffusione avanzati (DALL·E, Stable Diffusion)
Come funziona: la modifica di immagini basata sulla diffusione maschera la regione del testo sull'immagine originale, poi genera contenuto sostitutivo da un prompt. Flusso generale: rileva il testo e genera una maschera → progetta il prompt (es. "sostituisci X con Y, mantieni lo sfondo invariato") → usa DALL·E 3 o Stable Diffusion Inpainting per riempire → ottieni la nuova immagine. Per esempio, carica l'originale e una maschera del testo nell'API di OpenAI, poi invia una richiesta di modifica per "sostituire il testo".
Strumenti: l'API di modifica DALL·E 3 di OpenAI, Generative Fill di Adobe Firefly, HuggingFace Diffusers (es. runwayml/stable-diffusion-inpainting). Controlli come il rilevamento del testo di ControlNet e l'inpainting di LaMa aiutano a contrassegnare le regioni da sostituire.
Input / Output: in ingresso l'originale + una maschera del testo + un prompt; in uscita un file immagine. Il modello di solito abbina automaticamente la lingua e lo stile della traduzione.
Automazione: medio-alta. La fase di mascheratura richiede uno strumento aggiuntivo (disegnata a mano o generata programmaticamente), ma la generazione in sé è con un solo clic.
Precisione e fedeltà: elevate, ma leggermente inferiori ai modelli dedicati alla modifica del testo. I modelli di diffusione sono spesso imprecisi con testi lunghi (possono spezzare le parole), e la coerenza dello stile dipende dalla qualità del prompt. Il punto di forza è la riparazione dello sfondo — può fondere le traduzioni in texture complesse in modo naturale. Il punto debole è a volte una forma delle lettere imperfetta, una leggera sfocatura o dettagli indesiderati. I migliori risultati richiedono maschere e prompt messi a punto.
Tempo e costo: medi. Generare un'immagine richiede tipicamente da dieci a decine di secondi (o dipende dalla tua GPU in locale); i servizi cloud aggiungono tempo di coda.
Ideale per: traduzione creativa — concept art, slogan nelle illustrazioni — e ogni caso in cui un leggero cambiamento di stile è accettabile. Nell'esempio seguente, Stable Diffusion ha tradotto il banner inglese "Summer sale — 30% off everything" nel tedesco "Sommer-Sale — 30 % auf alles", ri-renderizzandolo mantenendo lo sfondo invariato.
Figura: esempio di sostituzione del testo con Stable Diffusion (a sinistra: banner originale in inglese, a destra: risultato in tedesco).
Metodo 8: pipeline personalizzata di computer vision + script
Come funziona: una pipeline di automazione completamente autocostruita. Usa la computer vision per rilevare le regioni di testo (es. rilevamento di bordi/contorni con OpenCV o un modello OCR profondo), combinala con un'API di traduzione automatica e disegna la traduzione sull'immagine originale con una libreria di immagini (Pillow/OpenCV). Passaggi: rilevamento del testo → OCR e traduzione per riquadro → ritaglia e riempi lo sfondo della regione di testo (con un algoritmo di inpainting) → disegna il nuovo testo → output.
Strumenti: Python (Pillow, OpenCV, EasyOCR, pytesseract, API di Baidu o Google Translate), Adobe PixelSense, elaborazione di immagini C#/.NET e simili.
Input / Output: in ingresso una normale bitmap; in uscita una bitmap della stessa risoluzione. L'intero flusso è autocostruito o scriptato, senza GUI pronta all'uso.
Automazione: alta (se lo script è ben costruito). Completamente batchabile.
Precisione e fedeltà: dipendono dai dettagli dell'algoritmo. Può approssimativamente far corrispondere il layout, ma di solito non può far corrispondere i font automaticamente — scegli quello più vicino a mano. Inoltre non può riparare gli sfondi in modo fluido come i modelli di diffusione, riempiendo comunemente i vuoti con un colore piatto o una media di vicinato, ed è limitato su sfondi complessi o font non standard.
Tempo e costo: costo di sviluppo elevato (richiede programmazione), con tempi di esecuzione che dipendono dall'efficienza di OCR e disegno (secondi per immagine). Rispetto ai servizi di terze parti, è a costo zero in denaro ma pesante in termini di sforzo di programmazione.
Pro e contro: pieno controllo sulla pipeline e buono per l'automazione in batch, ma la fedeltà ai dettagli di design è inferiore a quella degli strumenti AI dedicati e richiede messa a punto dei parametri e post-correzione. Si adatta a scenari di personalizzazione profonda o di privacy dei dati (nessuna rete pubblica).
Ideale per: ambienti aziendali con requisiti di processo speciali, o la semplice sostituzione di etichette su piccola scala — ad es. un commerciante che scrive uno script per fare OCR, tradurre e riscrivere le etichette delle immagini dei prodotti. Tecnicamente impegnativo ma flessibile.
Metodo 9: servizio professionale di traduzione umana + DTP
Come funziona: esternalizza a un team di traduzione e design. Un traduttore professionista traduce prima il testo, poi un designer di desktop publishing (DTP) lo sostituisce passo per passo confrontandolo con l'originale. Comprende: individua e modifica il file sorgente (PSD/InDesign) → traduci il testo → regola il layout e ri-renderizza nello stesso software.
Strumenti: di solito la suite Adobe, InDesign, Illustrator. I fornitori possono usare strumenti CAT (Trados, MemoQ) per mantenere coerente la terminologia, ma l'output finale dipende dal software di design.
Input / Output: in ingresso qualsiasi immagine o file sorgente; in uscita tipicamente un'immagine localizzata di alta qualità o un file modificabile.
Automazione: bassa. Un servizio completamente manuale che richiede intervento umano a ogni passaggio.
Precisione e fedeltà: massime. Traduttori e designer possono adattare il testo alle sfumature culturali preservando o regolando con precisione il design, e la qualità dell'output è garantita da professionisti.
Tempo e costo: massimi. I costi combinano le tariffe di traduzione e il tempo di design, di solito molto più che con le opzioni automatiche. Si adatta a progetti di alto valore o contenuti molto sensibili.
Pro e contro: qualità e affidabilità di primo livello, a un costo e a un impiego di tempo molto superiori a qualsiasi metodo automatizzato.
Ideale per: campagne di immagine del marchio, materiali per fiere importanti, contenuti visivi in documenti governativi o legali e pubblicazioni localizzate che richiedono una rilettura umana.
Metodo 10: traduzione automatica tramite file vettoriali / sorgente
Come funziona: se l'immagine di origine proviene da software vettoriale o di design, puoi sostituire il testo all'interno dell'ambiente di design. Per esempio, InDesign o Illustrator con plugin o script possono estrarre il testo tramite OCR o conversione automatica, tradurlo e reinserirlo nei riquadri di testo. In alternativa, converti l'immagine in PDF, traducila con OCR e reimportala.
Strumenti: Adobe Acrobat (OCR + esportazione in Word), la funzione di trova e sostituisci testo di Illustrator, gli script di InDesign o plugin di terze parti (Lokalise, il plugin InDesign di Transifex, ecc.).
Input / Output: in ingresso di solito un documento o PDF modificabile; in uscita il testo sostituito direttamente nel file originale.
Automazione: media. Dipende dall'automazione del software e dal supporto agli script.
Precisione e fedeltà: elevate. Poiché modifichi direttamente la sorgente, tutti i livelli e gli effetti vengono preservati — a condizione che il file originale sia disponibile. Se si tratta di un'immagine già appiattita, hai bisogno dell'aiuto dell'OCR e si comporta come il Metodo 2.
Tempo e costo: medi. La sostituzione automatizzata richiede comunque una messa a punto umana.
Pro e contro: composizione tipografica precisa dal file sorgente, ma dipende dal possesso del file originale modificabile e del software giusto.
Ideale per: progetti di traduzione in cui possiedi la sorgente di design — ad es. tradurre un manuale impaginato in InDesign — o situazioni d'emergenza in cui fai prima una traduzione OCR approssimativa e poi perfezioni nel file sorgente.
Il confronto affiancato
| Metodo | Fedeltà al design | OCR / riconoscimento | Multilingue | Difficoltà tecnica | Costo | Velocità | Ideale per |
|---|---|---|---|---|---|---|---|
| 1. Software di design professionale (manuale) | Molto alta | N/D (umano) | Qualsiasi | Alta (serve un designer) | Massimo (manodopera) | Lenta (manuale) | Asset di brand / marketing di alto livello |
| 2. OCR + composizione | Alta | Alta (testo strutturato) | Molte | Medio-alta (software/script) | Basso (open source) | Media | Documenti tecnici, diagrammi etichettati, grafici strutturati |
| 3. Servizio di traduzione documenti | Alta | Alta (OCR professionale) | Molto numerose | Bassa (chiavi in mano) | Medio-alto (tariffa di servizio) | Veloce | PDF/scansioni in grandi quantità, documenti professionali |
| 4. Strumenti AI online (ReWords, ecc.) | Alta | Alta (AI) | Molte | Bassa (chiavi in mano) | Basso/medio (gratuito + a pagamento) | Veloce | Poster e-commerce, fumetti, localizzazione quotidiana di più immagini |
| 5. App con fotocamera del telefono | Bassa | Medio-alta (a mano libera) | Molte | Molto bassa (chiavi in mano) | Basso (gratuito) | Tempo reale | Lettura rapida per viaggi / vita quotidiana |
| 6. Modifica con modelli multimodali di grandi dimensioni | Alta | Alta (modello) | Molto numerose | Bassa (chiavi in mano) | Medio-alto (tariffa API) | Media | Infografiche, poster pubblicitari, screenshot di UI che richiedono ragionamento rapido |
| 7. Modelli di diffusione (DALL·E, ecc.) | Medio-alta | Media (serve una maschera) | Molte | Media (abilità nel prompt) | Medio (API/compute) | Media | Design creativo, requisiti di stile flessibili |
| 8. Pipeline Python personalizzata | Media | Media (dipende dagli strumenti) | Molte | Alta (programmazione) | Basso (open source) | Flessibile (batch automatico) | Ambienti di automazione (personalizzati aziendali, batch) |
| 9. Umano professionale + DTP | Molto alta | N/D (umano) | Qualsiasi | Molto alta (team di esperti) | Massimo (tariffa di servizio) | Molto lenta (manuale) | Pubblicazioni di alto livello, esigenze rigorose di testo/formato |
| 10. Traduzione diretta dal file sorgente | Molto alta | Alta (dalla sorgente) | Molte | Media (software di design) | Basso (software già disponibile) | Media | Progetti con sorgente modificabile (libri InDesign, traduzione di report) |
Nota: «fedeltà» qui indica quanto fedelmente l'immagine tradotta corrisponde al design originale. Le app per telefono servono alla comprensione e aggiungono una grande mascheratura, quindi la fedeltà è bassa; i servizi professionali di design e di traduzione di documenti preservano completamente layout e font, quindi ottengono un punteggio alto.
Tre tutorial end-to-end
Se vuoi andare più a fondo di un semplice clic su un pulsante, ecco i tre approcci che vale la pena imparare. Ciascuno include il flusso completo e il codice funzionante.
Tutorial 1: modifica multimodale con GPT-4 Vision
Panoramica: questo esempio mostra come usare GPT-4 di OpenAI con funzionalità immagini (o DALL·E) per modificare il testo dentro un'immagine. Preparazione: registrati su OpenAI e ottieni una chiave API. Prepara un'immagine di esempio con del testo e una maschera corrispondente. Supponiamo di voler tradurre l'inglese "Summer sale" nel cinese "夏季特卖".
Flusso: inserisci l'immagine originale → chiama l'endpoint di modifica GPT-4V o DALL·E → il modello riconosce e traduce il testo → il modello genera una nuova immagine → scarica e rileggi.
- Prepara l'immagine e la maschera. Assicurati che l'originale (
orig.png) e la maschera (mask.png) siano allineati, con la maschera che copre solo la regione del testo "Summer sale". - Chiama l'API (usando l'SDK Python di OpenAI come esempio):
```python import openai openai.api_key = "YOUR_API_KEY"
Chiedi al modello di tradurre in cinese il testo nell'area mascherata
lasciando tutto il resto invariato.
response = openai.Image.create_edit( image=open("orig.png", "rb"), mask=open("mask.png", "rb"), prompt="用中文翻译上面的文字,不改变其他内容。", n=1, size="1024x768" )
Salva l'immagine restituita su disco
with open("output.png", "wb") as f: f.write(response['data'][0]['image']) ```
Questo istruisce il modello a tradurre in cinese il testo della regione mascherata e a lasciare intatto il resto, poi a generare il risultato.
- Esamina l'output. Controlla
output.png. Il modello dovrebbe aver sostituito "Summer sale" con "夏季特卖", con uno stile di font simile e uno sfondo identico.
Figura: esempio di traduzione con GPT-4V (a sinistra: originale in coreano, a destra: output del modello in vietnamita).
- Salva il risultato. Usa
output.pnge, facoltativamente, metti a punto la posizione o lo stile del testo in un editor di immagini.
Avvertenze: rileggi sempre il testo generato da GPT-4V. Se manca qualcosa, prova un prompt più dettagliato o traduci in blocchi più piccoli. L'API di OpenAI fattura in base alla dimensione dell'immagine e al numero di generazioni.
Tutorial 2: strumenti AI online (ReWords / EditTextImage)
Panoramica: usa l'app ReWords o un sito simile per tradurre un'immagine — ReWords in questo esempio. Preparazione: apri uno strumento online come ReWords o EditTextImage; non è richiesta alcuna installazione.
Flusso: carica l'originale → il sistema esegue l'OCR e rileva il testo → traduce automaticamente e mostra il testo suggerito → regoli il testo e blocchi tutto ciò che deve restare → l'AI renderizza la nuova immagine → scarica l'immagine tradotta.
- Carica l'immagine. Apri il sito ReWords, scegli la funzione «Traduci testo nell'immagine» e carica la foto da tradurre (qui, un annuncio contenente "SUMMER SALE").
- Scegli una lingua e modifica. La piattaforma rileva ogni riga di testo, scegli la lingua di destinazione (es. cinese) e ricevi suggerimenti riga per riga. Correggi eventuali errori di traduzione e blocca le parole che non devono cambiare (come i nomi dei marchi).
- Genera l'immagine. Clicca su Generate o Apply, e l'AI rimuove il testo originale e ridisegna la traduzione con il font, il colore e lo sfondo originali.
- Scarica il risultato. Scarica la nuova immagine. Nell'esempio seguente, a sinistra c'è l'immagine originale "SUMMER SALE" e a destra la versione "夏季特卖" generata da ReWords.
Figura: esempio di traduzione di immagini con ReWords (a sinistra: originale, a destra: tradotta con AI).
Consigli: questi strumenti hanno di solito una quota gratuita (ReWords include diverse generazioni gratuite per immagine), con pagamento o crediti oltre tale soglia. La qualità della traduzione è alta, ma verifica il testo — soprattutto numeri e nomi propri. È ideale quando non puoi ottenere il file di progetto originale e devi localizzare l'immagine direttamente.
Tutorial 3: traduzione automatica con Python OCR + OpenCV
Panoramica: uno script che estrae il testo da un'immagine, lo traduce e lo ri-renderizza nell'immagine. Useremo Tesseract OCR con OpenCV/Pillow per tradurre un'immagine in spagnolo in inglese.
Flusso: carica l'originale → rilevamento del testo e OCR (Tesseract) → chiama un motore di traduzione (API Google Translate) → usa OpenCV per pulire la regione del testo originale → disegna la traduzione con Pillow → output dell'immagine localizzata.
- Installa le dipendenze (prima Tesseract-OCR e le librerie Python):
```bash
Installa Tesseract (esempio per Ubuntu)
sudo apt-get install tesseract-ocr
Installa le librerie Python
pip install pytesseract pillow googletrans==4.0.0-rc1 ```
- Lo script:
```python from PIL import Image, ImageDraw, ImageFont import pytesseract from googletrans import Translator
Carica l'immagine originale
image = Image.open("image_with_text.png")
Esegui l'OCR (riconosci il testo in spagnolo)
text = pytesseract.image_to_string(image, lang='spa') print("Recognized text:", text)
Traduci il testo
translator = Translator() result = translator.translate(text, src='es', dest='en') print("Translation:", result.text)
In questo esempio la posizione del testo è nota; in produzione
useresti pytesseract.image_to_boxes per ottenere un riquadro per carattere.
x, y, w, h = 50, 50, 300, 50 # coordinate di esempio
Cancella il testo originale sull'immagine
draw = ImageDraw.Draw(image) draw.rectangle(((x, y), (x + w, y + h)), fill="white") # copri con il bianco
Disegna il testo tradotto
font = ImageFont.truetype("arial.ttf", size=36) draw.text((x, y), result.text, font=font, fill="black")
Salva l'output
image.save("translated_image.png") ```
- Come funziona: lo script esegue prima l'OCR dell'originale con Tesseract, recupera la traduzione con Google Translate (
googletrans), poi usa Pillow per cancellare la regione originale e disegnare la traduzione. L'esempio gestisce una singola regione fissa; un'applicazione reale determinerebbe le regioni dinamicamente dai risultati dell'OCR e farebbe corrispondere i font (qui semplificato a scopo illustrativo). - Output: eseguendolo si produce
translated_image.png, con la regione del testo originale sostituita dalla traduzione in inglese.
Avvertenze: questo flusso dipende dalla precisione di posizionamento dell'OCR e dalla capacità di far corrispondere i font. In pratica, combina il rilevamento dei contorni di OpenCV per un ritaglio preciso e usa Pillow per misurare la larghezza del testo ai fini del ritorno a capo automatico. Per il testo su più righe, esegui un ciclo su ogni segmento. Il tutto può essere messo in batch, ma la fedeltà del layout è inferiore a quella dei metodi di inpainting con AI, quindi fai test e aspettati di mettere a punto i parametri.
Come scegliere: una guida decisionale
Abbina il metodo a tre cose — fedeltà, costo e se possiedi il file sorgente:
- Non hai il file sorgente e lo vuoi veloce (il caso comune): usa uno strumento AI online come ReWords AI (Metodo 4). Carica, scegli una lingua, genera, scarica.
- L'immagine è ricca di testo e strutturata (grafici, manuali, diagrammi): OCR + composizione (Metodo 2), o un servizio di traduzione documenti che preserva il formato per il lavoro in grandi quantità (Metodo 3).
- Il risultato deve essere perfetto per la stampa e critico per il brand: design manuale (Metodo 1) o umano professionale + DTP (Metodo 9).
- Vuoi automatizzarlo all'interno del tuo flusso di lavoro: un'API di modello multimodale (Metodo 6) o una pipeline Python personalizzata (Metodo 8).
- Devi tradurre un'istantanea veloce solo per leggerla: un'app con fotocamera del telefono (Metodo 5) — ma mai per la pubblicazione.
- Possiedi ancora il file sorgente modificabile: modificalo direttamente (Metodo 10). Questo è il percorso più pulito possibile quando è disponibile.
Cinque regole per preservare il design
Qualunque strada scegli, queste abitudini separano «tradotto» da «localizzato professionalmente»:
- Prevedi i cambiamenti di lunghezza del testo. Il tedesco e il francese di solito si espandono; il cinese e il giapponese si contraggono. Aspettati di ridimensionare, riscrivere a capo o ricalibrare la spaziatura, e non dare mai per scontato che la traduzione entri così com'è nel riquadro originale.
- Fai corrispondere il font, non solo le parole. Riproduci il peso, il colore, la spaziatura tra le lettere originali e qualsiasi tratto o ombra. Una traduzione perfetta nel carattere sbagliato appare comunque sbagliata.
- Ricostruisci lo sfondo in modo pulito. L'area riparata dietro il testo deve essere indistinguibile da ciò che la circonda — sfuma i bordi e controlla la giunzione a zoom 1:1.
- Gestisci gli elementi non testuali. Frecce, richiami, numerazioni e legende spesso contengono o puntano a del testo; tienine conto affinché la versione localizzata resti coerente.
- Rileggi la traduzione stessa. La traduzione automatica è veloce ma imperfetta. Numeri, unità, nomi di marchi e nomi propri meritano un controllo umano prima di pubblicare.
In conclusione
Non hai bisogno del file di progetto originale per tradurre il testo dentro un'immagine. Devi scegliere il metodo giusto per la fedeltà che cerchi — e per la maggior parte delle immagini quotidiane quel metodo è uno strumento AI con un solo clic che legge il testo, lo traduce e lo ridisegna sul posto senza disturbare il layout.
Quando la posta in gioco è alta e l'immagine è complessa, gli strumenti più pesanti — design manuale, servizi di traduzione documenti o DTP professionale — hanno comunque il loro posto. Ma per la stragrande maggioranza di menu, poster, immagini di prodotto e grafiche social, puoi localizzare in pochi minuti.
Prendi un'immagine che intendevi tradurre da tempo, caricala su ReWords AI e osserva con quanta fedeltà una traduzione AI di un minuto preserva il design, prima di considerare la strada manuale.
Riferimenti
- Documentazione di OpenAI sulla modifica delle immagini e sulla modifica con DALL·E.
- Ricerca sulla traduzione di PDF e immagini con conservazione del formato.
- Report di Atlas Cloud sull'estrazione OCR e il reinserimento nei flussi di lavoro di design.
- Documentazione di prodotto per gli strumenti online di traduzione di immagini (ReWords AI, EditTextImage e simili).
- Documentazione di Tesseract OCR, OpenCV e Pillow per pipeline personalizzate.