想在已經完成的圖片裡做文字本地化——十種方法,既能換掉文字,又能讓版面、字型與背景保持設計師留下的原樣。
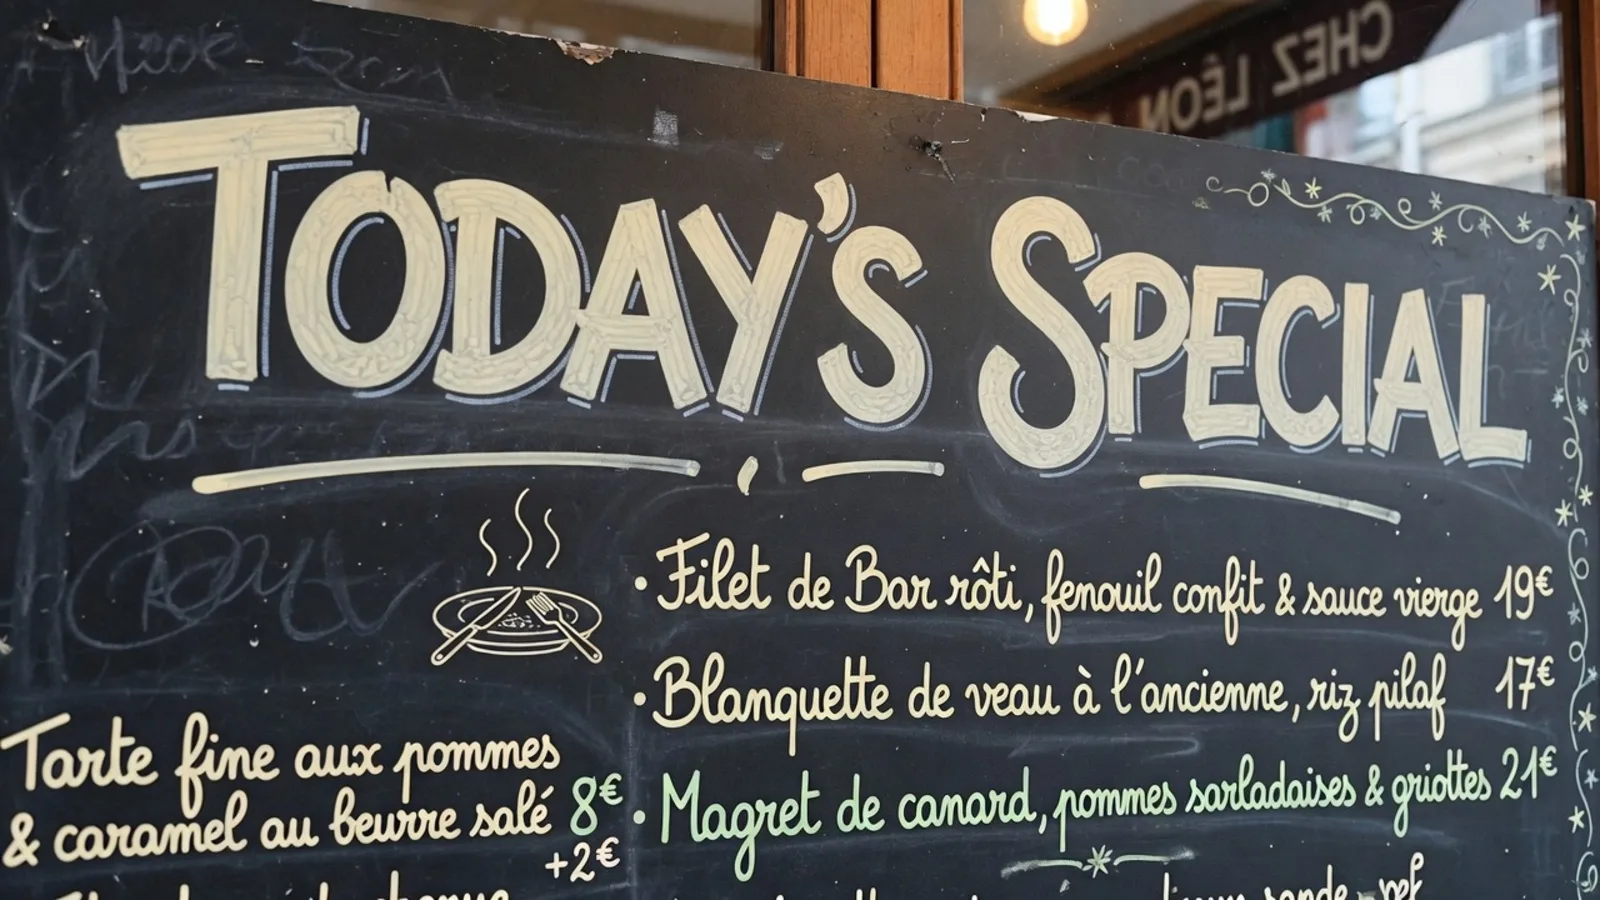
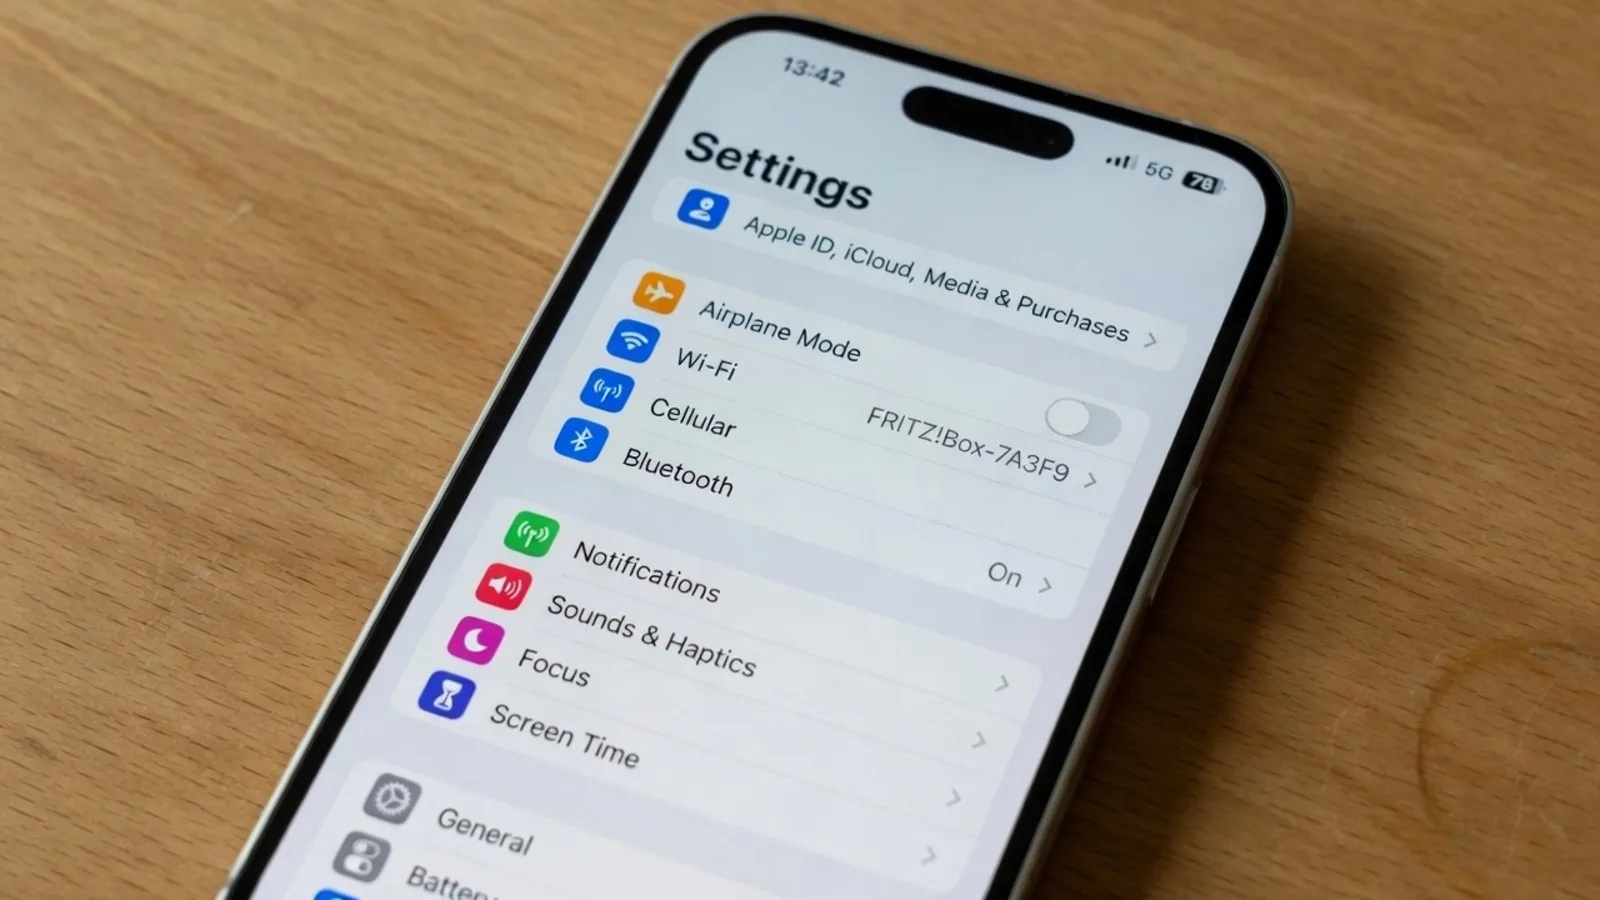
一張英文活動海報,一份日文菜單,一張德文產品標籤,一張西班牙語標註的技術圖。你需要把它們換成另一種語言,而你手上只有匯出的成品圖片。
翻譯一份文件很簡單:把文字交給譯者,拿回譯文就好。但翻譯圖片裡的文字完全是另一回事。你改的不只是詞,而是在設計師的版面注視下,做一場像素級的手術——字型差一點、背景沒對齊、譯文比原文長了 30%,都會一眼被看出來。
這正是圖片本地化最彆扭的地方:你必須改變含義,卻不能改變設計。 下面這份報告梳理了十種真正可行的做法,從純人工設計到一鍵 AI,每一類都標明了保真度、成本和失敗模式。
圖片文字翻譯
使用我們的免費線上圖片翻譯器自動翻譯嵌入圖片的原有文字並重繪視覺區域。使用者可以在最終渲染前編輯譯文行。完成登入後可獲得有限試用積分,以便體驗和測試圖像翻譯與重繪功能。
為什麼翻譯圖片裡的文字這麼難
翻譯文件時,版面是會伸縮的;但翻譯被烙進圖片裡的文字時,版面被凍結在像素中。光是這一個限制,就衍生出一連串問題:
文字長度會變。 一句簡短的英文,翻成德文或法文可能膨脹 30% 以上,翻成中文或日文又會大幅縮短。原設計的空間是固定的,譯文必須被重新適配——縮放、換行、調字距——同時不能破壞構圖。
字型與樣式必須相符。 原字型、字重、顏色、字距,以及陰影、描邊之類的效果都得重現。一旦不對,本地化版本擺在原作旁邊就會顯得「有點外來」。
背景必須重建。 擦掉原文字會毀掉它底下的像素。純色背景很簡單;換成照片、漸層或材質紋理,你就是在重建缺失的畫面。
非文字元素也要顧到。 箭頭、標註、編號、圖例往往本身帶文字或指向文字,乾淨俐落的本地化必須把它們一併考慮。
下面每一種方法,都是在上述四個問題之間做不同的權衡。選哪一種,取決於結果需要多保真、圖裡文字有多少,以及你是否握有原始來源檔案。
最快的路徑:線上的 AI 圖片翻譯
在進入手動方法之前,先知道這條捷徑存在——而且它是大多數人應該最先嘗試的。
專門為這件事打造的線上 AI 工具,例如 ReWords AI,把文字偵測、機器翻譯與 AI 圖片補全揉進同一條流程。它不會在圖上再疊一個文字框,而是偵測圖片裡既有的文字、翻譯它、擦掉原文、重建背景,再用相符的字型、顏色、字級把譯文重繪進去——版面原封不動。
運作方式:
- 上傳圖片。 開啟工具,選擇「Translate Text in Image」功能,上傳要翻譯的圖片(例如一張帶「SUMMER SALE」橫幅的廣告圖)。
- 選擇語言並編輯。 平台會自動辨識每一行文字。選定目標語言後,它會給出逐行翻譯建議,你可以手動修正,並把不能改的詞(如品牌名)鎖定。
- 生成圖片。 點選 Generate 或 Apply,AI 會移除原文,並依原字型、顏色、背景重繪譯文。
- 下載結果。 檢查並下載本地化後的圖片。
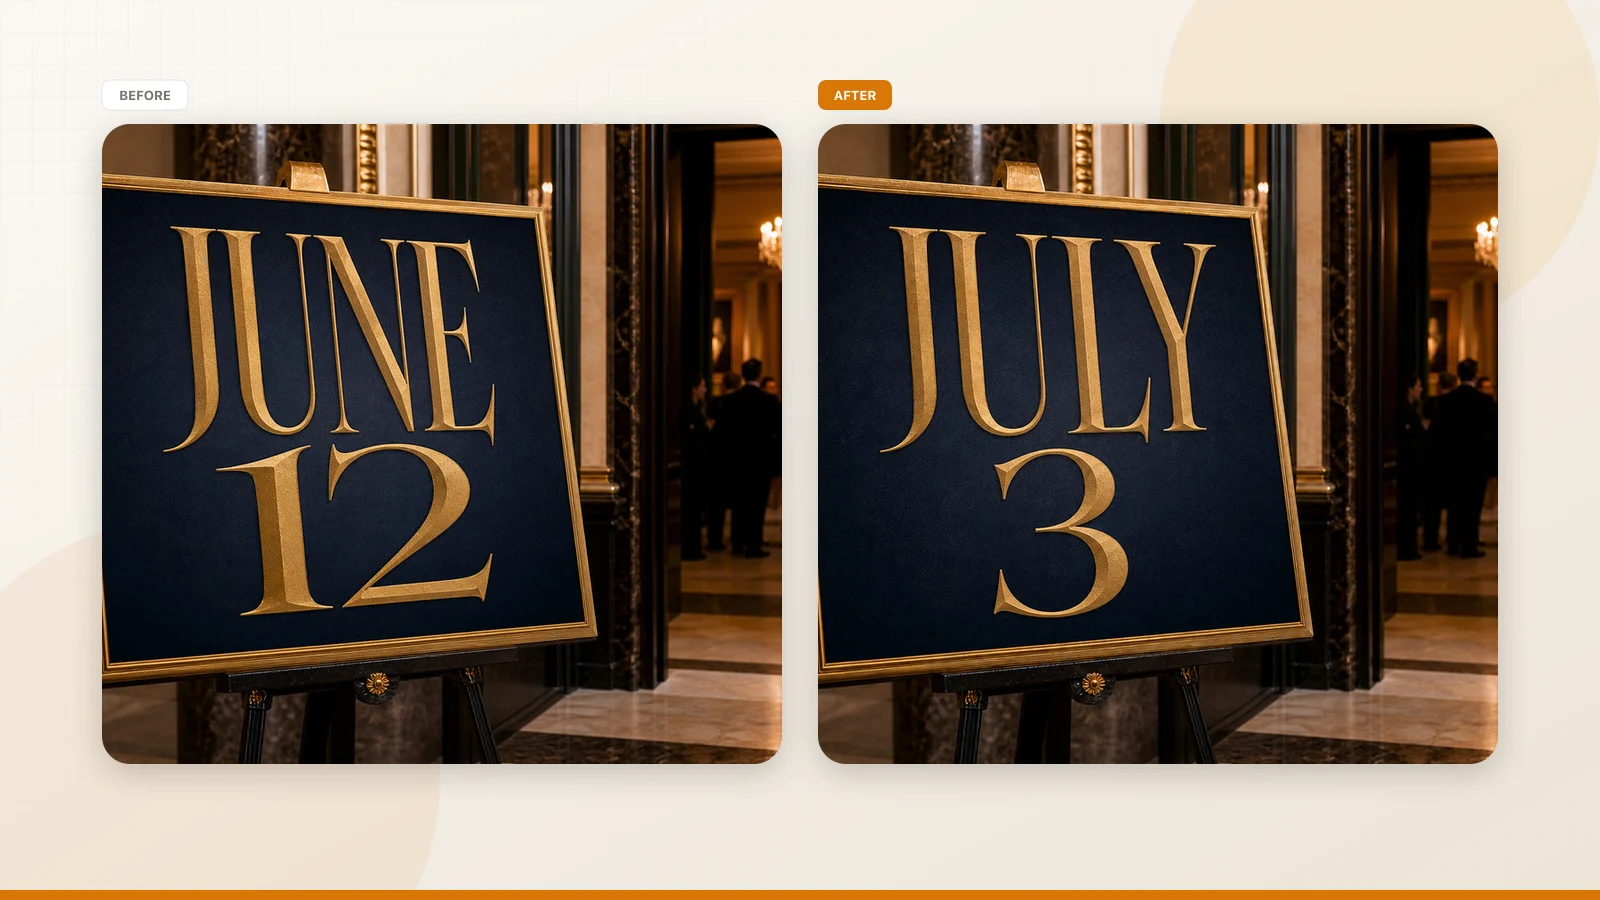
圖:線上 AI 翻譯範例(左:原圖,右:翻譯後)。
為什麼它是預設首選: 不需要原始設計檔案、不需要安裝軟體、不需要設計技能。一張普通圖片幾秒到一分鐘就能返回。這類工具通常都帶免費額度(ReWords 每張圖提供數次免費生成),超出後按付費或點數計。
需要留神的地方: 譯文本身值得複核——尤其是數字和專有名詞;而文字過密、光影複雜或字型極度裝飾化時,AI 的重繪偶爾會出瑕疵。同時要留意著作權與敏感內容的處理。
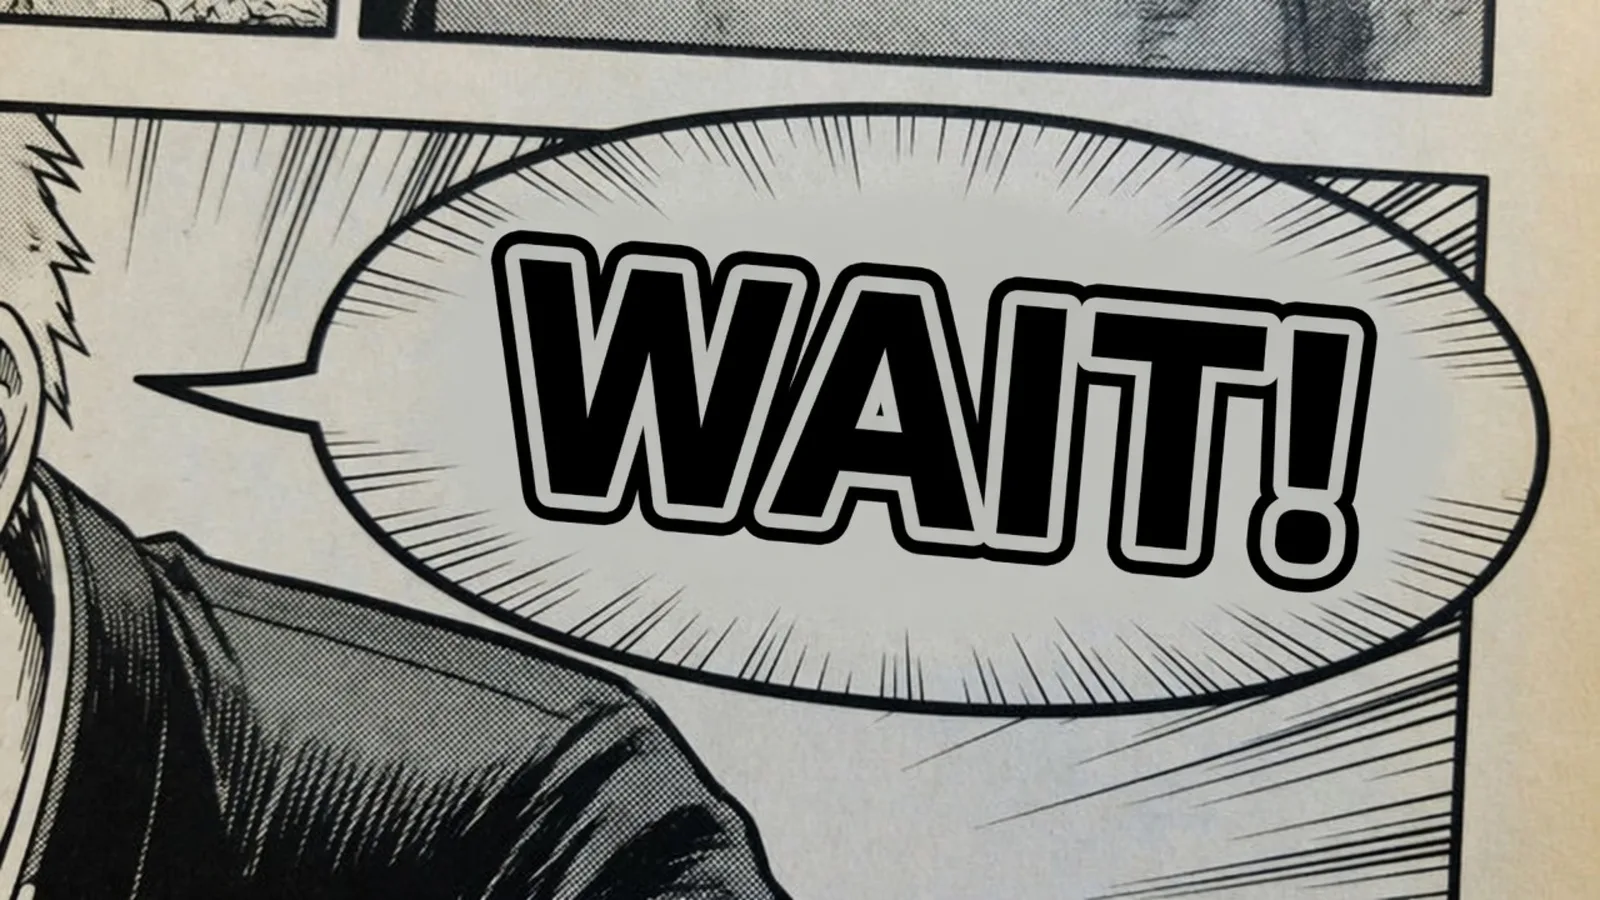
最貼合的真實場景: 電商商品圖、本地化的廣告與社群圖、菜單、傳單、漫畫——這些日常的本地化任務裡,你早就沒有原始檔案了。
完整工具箱:不破壞設計翻譯圖片文字的十種方法
如果圖片複雜、要求很高,或者你想自建流程,下面這十種做法值得了解。每一種都列出了原理、所需工具、保真度,以及它適合誰。
方法一:人工設計編輯(Photoshop / Illustrator)
原理/流程: 由專業設計師手工完成。先用 OCR 或人工抄錄取得圖中文字並翻譯,然後在 Photoshop、Illustrator 等軟體裡,用相符的字型與樣式把譯文重新排版、覆蓋在原文字區域上。流程為:文字擷取 → 翻譯校對 → 尋找或製作相同字型 → 圖形軟體中刪除原文、插入譯文並調整效果。
工具: Adobe Photoshop、Illustrator、InDesign、GIMP、Figma;OCR 工具(如 Tesseract)可協助擷取文字。
輸入/輸出: 輸入為任意圖片格式(PNG/JPEG);輸出為帶譯文的新圖片(同格式),或可圖層編輯的 PSD/AI 檔案。
自動化程度: 低。主要靠人工,自動化僅存在於 OCR 擷取環節。
準確率/保真度: 最高。設計師可完全控制字型、位置與樣式,能像素級複刻原始設計。保真度取決於人工水準,耗時長,且對譯文長度膨脹很敏感。
時間成本: 高。一次專業修改可能需數分鐘到數小時,依圖片複雜度而定,軟體本身也有學習曲線,翻譯量大時效率很低。
優缺點: 優點是完整保留版面與風格(理論上可做到無差別替換),適合高要求的行銷素材與品牌文案;缺點是耗時、昂貴、容易出錯,且必須有相同字型,否則難以完全一致。
最適合: 廣告海報、包裝設計、UI 原型、印刷宣傳品等需要高保真本地化的場合。
引用案例:Atlas Cloud 指出,OCR 擷取文字後仍需人工「將該文字放回設計中」,而純圖片編輯則是在新的點陣圖層上合併修改,對單個字母的控制更少——可見手動排版雖費時,卻最為精準。
方法二:OCR + 設計軟體排版
原理/流程: 自動化程度略高的半自動流程。先對圖片做文字辨識(OCR),擷取各文字框的內容與位置;再透過機器翻譯或人工翻譯取得譯文;最後用排版軟體(如 InDesign、Illustrator)或腳本,把譯文按原文字的位置與樣式重新渲染到圖上。流程為:OCR 文字辨識 → 文字翻譯 → 版面重建 → 輸出圖片。
工具: OCR 函式庫/軟體(Tesseract、EasyOCR、Adobe Acrobat OCR);翻譯 API(Google Translate、DeepL、百度翻譯等);排版軟體(Adobe InDesign、Photoshop,或程式環境中的 Pillow/Matplotlib)。
輸入/輸出: 輸入圖片格式不拘(PNG/JPEG),輸出為新圖片。中間可借助向量文件(PDF/AI)來保持版面。
自動化程度: 中等。OCR 與翻譯可以自動完成,但最後的排版常需人工輔助——尤其中外文長度差異大時,要手動調整字級、行距。
準確率/保真度: 較高。若能匹配字型與框架位置,版面可得到較好保留。但譯文的膨脹可能打破原始空間分布,需要縮放或換行;複雜圖形下的定位誤差也會影響保真度。
時間成本: 中等。OCR 與翻譯的自動化部分較快(秒到分鐘),後續排版調整需數分鐘到十幾分鐘。
優缺點: 比純手工快,但依賴 OCR 準確度與字型匹配效果,字距、連字等細節可能有細微差別。適合文字多、設計又有要求的場景。缺點是處理不了圖中的非文字元素(指向線、編號等需人工處理)。
最適合: 圖表說明、技術手冊、教育圖示等多文字元素圖片的本地化。
背景:PDF 翻譯工具通常遵循這類思路——先解析文件結構,再逐區翻譯後「原位替換文字、保留版面輸出」。同理,對圖片做 OCR 與逐塊翻譯,就能得到原位替換的譯文。
方法三:專用文件翻譯服務(格式保留型)
原理/流程: 利用企業級或線上的「格式保留翻譯」服務。這類工具先解析輸入檔案或圖片中的版面與字型,再對每個文字塊做機器翻譯,最後重新排版輸出。關鍵步驟:版面解析(辨識文字框座標、字型)→ 文字翻譯(雲端翻譯服務或本地 MT)→ 版面重建與渲染 → 輸出檔案。圖片部分通常原樣保留。
工具: 線上平台或商用軟體,如 PDFTranslator(Gemini + ChatGPT 引擎)、Pangeanic ECO 平台、Pairaphrase、Smartcat 等。它們多支援 PDF/圖片輸入,輸出保留原樣式的 PDF 或圖文。
輸入/輸出: 可輸入掃描件、圖片或 PDF(JPG/PNG/PDF);輸出為翻譯後的同格式檔案,版面、表格、圖形位置基本無損。
自動化程度: 高。全流程由系統自動完成,只需少量人工校對。
準確率/保真度: 較高。先進服務採用高精度 OCR 加專用 LLM/翻譯系統,實現文字與格式的「座標級精準對映」。版面與字型可完整保留(文件級保真度可達 90%+),誤差主要來自譯文長度差異。
時間成本: 低。翻譯速度快,多數任務秒級或分鐘級完成(例如 60 頁 PDF 幾分鐘內搞定)。但通常為收費服務,或需購買 API 配額。
優缺點: 優勢是自動化程度高、省時、保真度好;缺點是對 API 費用敏感(大批量或長文件需付費),對特殊版面或手寫文字支援有限。適合批量文件或圖片翻譯。
最適合: 企業多語言技術文件、產品手冊、訓練教材、財務報表等需要忠實保留版面的場合。本質上,這類系統也是「OCR + 翻譯 + 自動排版」的流程。
方法四:線上 AI 圖片翻譯工具
原理/流程: 使用專門的 AI 服務或軟體,直接對圖片內文字自動翻譯並就地修改,常結合深度學習自動「遮罩重繪」。流程通常是:上傳原圖 → 自動 OCR 辨識文字區域 → 自動翻譯並可人工校對 → AI 模型去除原文字,並用譯文及相似字型風格重新「繪製」進去 → 生成新圖並下載。 這類工具把 OCR、MT 與圖片補全結合在一起,一鍵完成翻譯。
工具: ReWords AI、ImageGPT、EditTextImage、Codia、VisualGPT 等。介面通常允許鎖定不動的文字行,並編輯建議譯文。
輸入/輸出: 輸入為普通點陣圖(PNG/JPEG);輸出為同解析度的點陣圖,譯文以原始風格呈現。
自動化程度: 高。整個過程只需上傳並點選「生成」,中間步驟由 AI 完成。
準確率/保真度: 整體較高。現代生成模型能相當準確地匹配字型樣式與背景紋理,做出「看不出修改」的效果;但文字太密、光影複雜或字型極度裝飾化時偶有瑕疵。OCR 準確度取決於源圖品質;機器翻譯多為神經網路,品質良莠不齊,需要人工複核。
時間成本: 低至中等。多數線上工具數秒至一分鐘內返回(可能限制免費次數),無需本地安裝,對非技術使用者友善;大批量則需付費或消耗點數。
優缺點: 優點是使用方便、效率高,不需要原始設計檔案即可在圖片上直接替換文字;缺點是生成品質依賴 AI,有時需要反覆嘗試或精調提示。此外,著作權或敏感資訊須謹慎處理。
最適合: 電商商品圖、本地化廣告與社群圖、菜單、傳單、漫畫等日常圖片翻譯需求。例如 ReWords 展示了把產品包裝上的「SUMMER SALE」替換為「夏季特賣」而背景一致的效果;EditTextImage 也給出把「Summer sale — 30% off everything」翻成德文「Sommer-Sale — 30 % auf alles」且版面不變的範例。這些都是典型的本地化場景。
圖:線上 AI 工具翻譯範例(左:原圖,右:翻譯後)。
方法五:手機即時翻譯應用程式
原理/流程: 用手機端的圖片翻譯 App(如 Google 翻譯、百度翻譯相機模式、Microsoft 翻譯)翻譯拍攝或匯入的圖片。這些 App 大多即時辨識並在螢幕上覆蓋譯文,或生成帶譯文的圖片快照。流程:拍照/匯入圖片 → 自動 OCR 辨識 → 自動翻譯 → 覆蓋或標記原文 → 檢視結果。
工具: Google 翻譯 App、百度翻譯相機、微信內建翻譯(掃描)等。
輸入/輸出: 輸入為手機拍攝的照片或截圖;輸出通常為覆蓋顯示的圖片或譯文文字。有些提供帶標註圖片的儲存功能。
自動化程度: 全自動。無需使用者輸入文字,操作簡單。
準確率/保真度: 低。主要目的是幫助理解,譯文往往採用系統預設字型與背景遮罩,覆蓋區域較粗糙,版面與樣式完全不保留。OCR 與翻譯品質接近專業工具,但輸出不能直接當作正式發布的設計檔案。
時間成本: 極低。即時翻譯,一般幾秒完成。
優缺點: 優點是方便快捷、無需專業知識,日常使用足夠;缺點是不能保留原圖設計,還會加上 logo 或浮水印,輸出僅供閱讀參考,不適合當作最終出版物。
最適合: 個人旅行或日常生活中快速理解外文菜單、路牌、說明書等。有些使用者用百度翻譯拍照後儲存圖片,但會出現工具商標或貼片遮擋。這類工具更適合「閱讀輔助」而非正式本地化。
方法六:多模態大型模型編輯(如 GPT-4 Vision)
原理/流程: 利用最新的多模態 AI 模型(GPT-4V/4.5、ChatGPT 圖片編輯、OpenAI DALL·E 3 編輯等)做高階指令式圖片編輯。你把原圖輸入模型,用自然語言提示讓它「翻譯文字、保持設計不變」。模型內部結合文字偵測、語意理解與圖片生成,在改字的同時儘量保留版面元素與風格。流程:輸入原圖 + 指令 → 模型辨識文字並翻譯 → 模型生成新圖 → 人工校對。
工具: OpenAI ChatGPT(含 GPT-4V 等圖片能力)、DALL·E 3 圖片編輯 API、Google Imagen Editor(目前主要仍在研究階段)等;開發者可透過 OpenAI API 呼叫。
輸入/輸出: 輸入為圖片加文字提示;輸出為新圖片(通常與原解析度相同,或可指定)。
自動化程度: 高。只需簡單提示詞,模型自動完成修改。
準確率/保真度: 一般較高。這類模型對版面關係與風格有較強的保持能力。例如 OpenAI 官方範例展示了把咖啡機說明圖翻譯成西班牙語而保留版面;Atlas Cloud 報導 GPT-4V 能把資訊圖中的文字翻譯為他語、同時保持其他內容不變。但仍可能漏譯部分文字或出現微小偏移,尤其當譯文長度與原文差異較大時,需要後續修正。
時間成本: 中等。生成一張圖片通常數秒到十幾秒;但高階模型需透過伺服器呼叫,對應 API 費用或訂閱成本。使用者還需投入提示詞撰寫與結果審查的時間。
優缺點: 優點是體驗友善,可一鍵輸出完整的翻譯圖;能在複雜背景中保留視覺關係(箭頭、圖例、版面層級)。缺點是對細節控制有限,可能出現拼寫錯誤、部分文字未翻譯或合成偽影,需要人工把關。目前尚不能取代精細排版,但在多數行銷場景中表現出色。
最適合: 跨語言資訊圖、海報、宣傳插圖等圖文並茂素材的快速本地化。例如可以向 ChatGPT 提供一張英文廣告圖和提示「翻譯所有文字為中文,不改動其他任何部分」,模型會直接生成對應語言的圖片。
圖:GPT-4V 多模態模型翻譯範例(左:輸入韓文圖,右:輸出越南文圖)。
方法七:深度擴散模型編輯(DALL·E、Stable Diffusion)
原理/流程: 基於擴散模型的圖片編輯技術:在原圖上遮罩待替換的文字區域,再用提示詞生成替代內容。通用流程為:文字偵測並生成遮罩 → 設計生成提示詞(如「將 X 替換為 Y,保持背景不變」)→ 用 DALL·E 3 或 Stable Diffusion Inpainting 進行修補 → 得到新圖片。 例如,先用 OpenAI API 上傳原圖和文字遮罩,再發起「replace text」編輯請求。
工具: OpenAI DALL·E 3 編輯 API、Adobe Firefly Generative Fill、HuggingFace Diffusers(如 runwayml/stable-diffusion-inpainting)等。ControlNet 文字偵測、LaMa inpainting 等控件可協助標定待替換區域。
輸入/輸出: 輸入為原圖 + 文字遮罩 + 提示詞;輸出為圖片檔案。模型通常自動匹配譯文語言與風格。
自動化程度: 中高。遮罩步驟需要額外工具輔助(人工畫出或程式生成),但整體也是一鍵式生成。
準確率/保真度: 較高,但略低於專門的文字編輯模型。擴散模型對長文字往往不夠精確(可能斷字),風格一致性也依賴提示品質。優點是對背景修補能力強,能把譯文自然融入複雜紋理;缺點是字體形狀有時不完美,可能出現輕微模糊或不必要的細節。最佳效果需調校遮罩與提示。
時間成本: 中等。生成一張圖片通常需十秒到幾十秒(本地 GPU 環境則取決於顯卡效能),用雲端服務還需等待佇列。
最適合: 創意類翻譯,如設計概念圖、插畫中的標語,以及可以容忍少許風格變化的場景。下圖範例中,Stable Diffusion 把英文橫幅「Summer sale — 30% off everything」翻成德文「Sommer-Sale — 30 % auf alles」,重新渲染但背景保持不變。
圖:Stable Diffusion 文字替換範例(左:原英文橫幅,右:德文翻譯結果)。
方法八:自訂電腦視覺 + 腳本流程
原理/流程: 完全自建的自動化流程。用電腦視覺偵測文字區域(如 OpenCV 邊緣/輪廓偵測或深度 OCR 模型),結合機器翻譯 API,最後用影像處理函式庫(如 Pillow/OpenCV)把譯文繪製到原圖上。步驟:文字偵測 → 按框 OCR 辨識並翻譯 → 摳除文字區域並填補背景(可用修補演算法)→ 把新文字繪製入圖 → 輸出結果。
工具: Python(Pillow、OpenCV、EasyOCR、pytesseract、百度或 Google 翻譯 API)、Adobe PixelSense、C#/.NET 影像處理等。
輸入/輸出: 輸入普通點陣圖;輸出同解析度點陣圖。整個流程需自建或編寫腳本,不依賴現成 GUI。
自動化程度: 高(腳本開發完善的前提下),可完全批量處理。
準確率/保真度: 取決於演算法細節。基本能匹配版面,但通常無法自動匹配字型,需要人為選擇最接近的字型。也難以像擴散模型那樣無縫修復背景,常用純色或鄰域平均等方法補洞。對複雜背景或非標準字型支援有限。
時間成本: 開發成本高(需程式設計能力),執行效率取決於 OCR 與繪製效率,單張圖片處理為秒級。相對第三方服務,此方法零金錢成本,但編碼工作量大。
優缺點: 可完全控制流程,適合批量自動化;但對設計細節的還原不如專用 AI 工具,需要調參與後期校正。適合需要深度客製或保護資料隱私的場景(不走公網)。
最適合: 對流程有特殊要求的企業環境,或只需對少量標籤做簡單替換——比如商家自行編寫腳本,把商品圖標籤 OCR 後翻譯再寫回。這種方法技術難度較大,但很靈活。
方法九:專業人工 + DTP 服務
原理/流程: 委外給翻譯與設計的專業團隊完成。專業譯者先翻譯文字,再由桌面排版設計師(DTP)依原圖逐步替換。包括:識別並編輯來源檔案(如 PSD/InDesign)→ 翻譯文字 → 在相同軟體中調整版面並重新渲染圖片。
工具: 通常使用 Adobe 全家桶、InDesign、Illustrator 等專業軟體。服務商可能用 CAT 工具(Trados、MemoQ)輔助術語一致性,但最終輸出依賴設計軟體。
輸入/輸出: 輸入可為任意圖片或來源檔案;輸出通常是高品質的本地化圖片或可編輯檔案。
自動化程度: 低。完全人工服務,每一步都需人工介入。
準確率/保真度: 最高。譯者與設計師可針對文化差異優化文字,同時精準保留或調整設計,輸出品質由專業人員保證。
時間成本: 最高。成本包含翻譯費 + 設計時間,通常比機器方案貴得多。適合高價值專案或非常敏感的內容。
優缺點: 極高品質與可靠性;缺點是成本和時間都遠高於任何自動化方法。
最適合: 品牌形象宣傳、重要會展資料、政府或法律文件的圖片內容、本土化出版物等需要人工校對的場合。
方法十:向量/來源檔案自動翻譯
原理/流程: 如果來源圖來自向量或設計軟體,可在設計環境裡直接替換文字。例如 InDesign、Illustrator 帶外掛或腳本,先用 OCR 或自動轉換擷取文字,翻譯後再插回文字框。也可把圖片轉 PDF,再 OCR 翻譯後匯回。
工具: Adobe Acrobat(OCR + 匯出到 Word)、Illustrator 的文字尋找取代、InDesign 的腳本,或第三方外掛(如 Lokalise、Transifex 的 InDesign 外掛)等。
輸入/輸出: 輸入通常為可編輯文件或 PDF;輸出可直接在原檔案上替換文字。
自動化程度: 中等。依賴軟體的自動化能力與腳本支援。
準確率/保真度: 高。因為直接編輯來源檔案,所有圖層與效果都能保留(前提是原檔案可用)。若原始檔案已是平面化圖片,則需 OCR 輔助,與方法二類似。
時間成本: 中等。自動替換後仍需人工微調。
優缺點: 優點是利用來源檔案精確排版;缺點是依賴原始可編輯檔案與相應軟體。
最適合: 擁有設計來源檔案時的翻譯需求,如 InDesign 排版的手冊翻譯;或緊急情況下先用 OCR 粗翻,再在來源檔案中細修。
橫向對照比較
| 方法類別 | 設計保真度 | OCR/辨識準確率 | 多語言支援 | 技術難度 | 成本 | 處理速度 | 適用場景 |
|---|---|---|---|---|---|---|---|
| 1. 專業設計軟體(手工) | 很高 | N/A(人工) | 任意 | 高(需設計師) | 最高(人力成本) | 較慢(手動) | 高要求品牌/行銷素材 |
| 2. OCR + 排版 | 高 | 高(結構化文字) | 多 | 中高(需軟體/腳本) | 低(開源工具) | 中等 | 技術文件、說明圖、結構化圖表 |
| 3. 文件翻譯服務 | 高 | 高(專業 OCR) | 很多 | 低(即用) | 中高(服務費) | 快速 | 大批量 PDF/掃描件、專業文件 |
| 4. 線上 AI 工具(ReWords 等) | 高 | 高(AI 辨識) | 多 | 低(即用) | 低/中(免費 + 付費) | 快速 | 電商海報、漫畫、日常多圖本地化 |
| 5. 手機相機應用程式 | 低 | 中高(手持拍攝) | 多 | 很低(即用) | 低(免費) | 即時 | 個人旅行/生活場景快速閱讀 |
| 6. 多模態大型模型編輯 | 高 | 高(模型辨識) | 很多 | 低(即用) | 中高(API 費) | 中等 | 資訊圖、廣告海報、UI 截圖等需快速推理的素材 |
| 7. 擴散模型(DALL·E 等) | 中高 | 中(需要遮罩) | 多 | 中(需提示技巧) | 中(消耗 API 或算力) | 中等 | 創意設計類、寬鬆樣式要求的場合 |
| 8. 自訂 Python 流程 | 中 | 中(依賴工具) | 多 | 高(程式設計) | 低(開源) | 靈活(批量自動) | 自動化需求環境(企業客製、多圖批量) |
| 9. 專業人工 + DTP | 很高 | N/A(人工) | 任意 | 很高(專業團隊) | 最高(服務費) | 很慢(人工) | 高端出版物、對譯文/格式要求極嚴的場合 |
| 10. 來源檔案直接翻譯 | 很高 | 高(源中擷取) | 多 | 中(設計軟體) | 低(利用現有軟體) | 中等 | 可編輯來源檔案的專案(如 InDesign 書籍、報表翻譯) |
註:表中「保真度」指翻譯後圖片與原始設計的一致程度。比如手機 App 只用於理解,圖片會加大塊遮罩,故保真度低;而專業設計與文件翻譯服務可完整保留版面與字型,故評分高。
三個端到端教學
如果你想比「點一下按鈕」走得更深,這三種做法值得學。每個都附完整流程與可執行原始碼。
教學 1:GPT-4 Vision 多模態編輯
概述: 本範例展示如何用 OpenAI 的 GPT-4 圖片能力(或 DALL·E)編輯圖片中的文字。 準備: 註冊 OpenAI 並取得 API 金鑰。準備一張帶文字的範例圖和對應遮罩。假設我們要把英文「Summer sale」翻譯為中文「夏季特賣」。
流程: 輸入原圖 → 呼叫 GPT-4V 或 DALL·E 編輯端點 → 模型辨識文字並翻譯 → 模型生成新圖 → 下載並校對譯文。
- 準備圖片與遮罩。 確保原圖(
orig.png)與遮罩圖(mask.png)對齊,遮罩只覆蓋「Summer sale」文字區域。 - 呼叫 API(以 OpenAI Python SDK 為例):
```python import openai openai.api_key = "YOUR_API_KEY"
讓模型把遮罩區域的文字翻譯成中文,其餘內容保持不變
response = openai.Image.create_edit( image=open("orig.png", "rb"), mask=open("mask.png", "rb"), prompt="用中文翻译上面的文字,不改变其他内容。", n=1, size="1024x768" )
把返回的圖片寫入磁碟
with open("output.png", "wb") as f: f.write(response['data'][0]['image']) ```
這段程式碼告訴模型「把遮罩區域文字翻譯為中文,其餘不變」,並生成結果。
- 檢視結果。 檢查
output.png。模型應已把「Summer sale」替換為「夏季特賣」,字型風格相似,背景一致。
圖:GPT-4V 編輯翻譯範例(左:原始韓文,右:模型輸出越南文)。
- 儲存輸出。 儲存並使用
output.png,必要時可用圖片編輯軟體微調文字位置或樣式。
注意: GPT-4V 生成的文字需要校對;若有遺漏,建議提供更詳細的提示或分塊翻譯。OpenAI API 依圖片大小與生成次數計費。
教學 2:線上 AI 工具(ReWords / EditTextImage)
概述: 使用 ReWords App 或類似網站做圖片翻譯,以 ReWords 為例。 準備: 造訪 ReWords 或 EditTextImage 等線上工具,無需安裝。
流程: 上傳原圖 → 系統 OCR 偵測文字 → 自動翻譯並顯示建議文字 → 使用者調整文字、鎖定保持原樣的部分 → AI 渲染新圖 → 下載翻譯後的圖片。
- 上傳圖片。 開啟 ReWords 官網,選擇「Translate Text in Image」功能,上傳需要翻譯的圖片(範例為含「SUMMER SALE」的廣告圖)。
- 選擇語言並編輯。 平台自動辨識所有文字行,你選定目標語言(如中文),系統給出逐行翻譯建議。可手動修改錯誤翻譯,必要時鎖定不需變更的詞(如品牌名)。
- 生成圖片。 點選「Generate」或「Apply」,AI 會自動去除原文字,並依原字型、顏色、背景重繪譯文。
- 下載結果。 完成後下載新圖。範例中左圖為原始「SUMMER SALE」圖,右圖為 ReWords 生成的「夏季特賣」版本。
圖:ReWords 生成的圖片翻譯範例(左:原圖,右:AI 翻譯後)。
提示: 這類工具通常有免費額度(ReWords 每張圖提供數次免費生成),超額需付費或點數。翻譯品質高,但最好檢查文字是否正確,尤其數字與專有名詞。適合無法取得原設計檔案時直接本地化圖片。
教學 3:Python OCR + OpenCV 自動化翻譯
概述: 用 Python 腳本實現從圖片中擷取文字、翻譯、再渲染入圖。我們以 Tesseract OCR 和 OpenCV/Pillow 為基礎,範例流程為把西班牙文圖片翻譯成英文。
流程: 載入原圖 → 文字偵測與 OCR(Tesseract)→ 呼叫翻譯引擎(Google Translate API)→ 用 OpenCV 摳除原文區域 → 用 Pillow 在圖上繪製譯文 → 輸出本地化圖片。
- 安裝相依套件(需先安裝 Tesseract-OCR 和 Python 函式庫):
```bash
安裝 Tesseract(範例為 Ubuntu)
sudo apt-get install tesseract-ocr
安裝 Python 函式庫
pip install pytesseract pillow googletrans==4.0.0-rc1 ```
- 程式碼範例:
```python from PIL import Image, ImageDraw, ImageFont import pytesseract from googletrans import Translator
讀取原圖
image = Image.open("image_with_text.png")
執行 OCR 辨識(辨識西班牙文)
text = pytesseract.image_to_string(image, lang='spa') print("Recognized text:", text)
翻譯文字
translator = Translator() result = translator.translate(text, src='es', dest='en') print("Translation:", result.text)
本範例已知文字位置,此處手動定義
實際可用 pytesseract.image_to_boxes 取得每個字元的框
x, y, w, h = 50, 50, 300, 50 # 範例座標
在原圖上抹去原文
draw = ImageDraw.Draw(image) draw.rectangle(((x, y), (x + w, y + h)), fill="white") # 用白底覆蓋
繪製譯文
font = ImageFont.truetype("arial.ttf", size=36) draw.text((x, y), result.text, font=font, fill="black")
儲存輸出
image.save("translated_image.png") ```
- 說明: 腳本先用 Tesseract 辨識原圖文字,再用 Google 翻譯(
googletrans)取得譯文,接著用 Pillow 在原圖上擦除原文區域並繪製譯文。上例示範了單一固定區域的處理;實際應用需根據 OCR 結果動態決定區域並匹配字型(此處為範例簡化)。 - 輸出效果: 執行後生成
translated_image.png,原文字區域已被替換為英文譯文。
注意: 本流程依賴 OCR 定位精度與字型匹配能力。實際專案可結合 OpenCV 做輪廓偵測以精確摳圖,也可用 Pillow 測量文字寬度自適應換行。如需處理多行文字,請逐段迴圈處理。整個過程可批量化,但版面保留效果不及 AI 補全方法,需要測試並可能微調參數。
如何選擇:一份決策指南
把方法與三件事對齊——保真度、成本,以及你是否握有來源檔案:
- 沒有來源檔案、又要快(最常見的情況): 用線上的 ReWords AI(方法四)。上傳、選語言、生成、下載。
- 圖片文字多且結構規整(圖表、手冊、示意圖): OCR + 排版(方法二),批量檔案則用格式保留的文件翻譯服務(方法三)。
- 結果必須印刷級完美、且關乎品牌: 人工設計(方法一)或專業人工 + DTP(方法九)。
- 想把它自動化進自己的工作流程: 多模態模型 API(方法六)或自訂 Python 流程(方法八)。
- 只想快速拍張照讀懂內容: 手機相機應用程式(方法五)——但絕不要用於發布。
- 你仍持有可編輯來源檔案: 直接改來源檔案(方法十)。能用時,這是最乾淨的路徑。
保持原設計的五條法則
不管走哪條路,下面這些習慣,就是「翻譯過了」和「專業本地化」的分界線:
- 為文字長度變化留餘地。 德文、法文通常會變長,中文、日文會變短。要預期到縮放、換行或調字距,別假設譯文能原樣塞進原來的框。
- 匹配字型,而不只是匹配文字。 重現原字重、顏色、字距,以及描邊或陰影。字型不對,譯文再準也顯得彆扭。
- 乾淨地重建背景。 文字背後被修復的區域應與四周渾然一體——羽化邊緣,並在 1:1 縮放下檢查接縫。
- 照顧好非文字元素。 箭頭、標註、編號、圖例往往帶文字或指向文字,處理到位,本地化版本才連貫。
- 校對譯文本身。 機器翻譯快但不完美。數字、單位、品牌名和專有名詞,發布前值得人工檢查一遍。
總結
你不需要原始設計檔案,也能翻譯圖片裡的文字。 你需要的是,按你所求的保真度選對方法——而對大多數日常圖片來說,那個方法就是一鍵 AI 工具:讀出文字、翻譯它、再就地重繪,全程不擾動版面。
當要求高、圖片複雜時,更重的工具——人工設計、文件翻譯服務或專業 DTP——依然物有所值。但對絕大多數菜單、海報、商品圖與社群圖來說,你可以在幾分鐘內完成本地化。
挑一張你一直想翻譯的圖片,上傳到 ReWords AI,先看看一分鐘的 AI 翻譯能把設計保留到什麼程度,再考慮要不要走人工路線。
References
- OpenAI 圖片編輯與 DALL·E 編輯官方文件。
- 關於 PDF 與圖片翻譯的格式保留研究。
- Atlas Cloud 關於 OCR 擷取與設計工作流程中重新放置文字的報導。
- 線上圖片翻譯工具的產品文件(ReWords AI、EditTextImage 等)。
- 用於自訂流程的 Tesseract OCR、OpenCV 與 Pillow 文件。