Dix méthodes pour localiser les mots à l'intérieur d'une image finalisée — tout en conservant la mise en page, les polices et l'arrière-plan exactement tels que le designer les a laissés.
Une affiche de campagne en anglais. Un menu en japonais. Une étiquette de produit en allemand. Un schéma technique annoté en espagnol. Vous avez besoin de chacun d'eux dans une autre langue — et tout ce que vous possédez, c'est l'image exportée.
Traduire un document est facile : confiez le texte à un traducteur, récupérez les mots. Traduire le texte à l'intérieur d'une image est une tout autre affaire. Vous ne changez pas seulement des mots. Vous effectuez une véritable chirurgie des pixels pendant que la mise en page d'un designer vous surveille par-dessus votre épaule, et la moindre erreur — une police légèrement décalée, un arrière-plan qui ne s'aligne pas tout à fait, un mot traduit 30 % plus long que l'original — se voit immédiatement.
C'est précisément ce problème qui rend la localisation d'images si délicate : vous devez changer le sens sans changer le design. Le rapport ci-dessous recense dix approches concrètes pour y parvenir, du travail entièrement manuel d'un designer à l'IA en un clic, avec pour chacune la fidélité, le coût et les modes d'échec.
Traduire le texte d'une image
Traduisez automatiquement le texte incrusté et recréez le visuel avec notre traducteur gratuit en ligne.
Pourquoi traduire le texte à l'intérieur d'une image est si difficile
Quand vous traduisez un document, la mise en page s'adapte. Quand vous traduisez du texte incrusté dans une image, la mise en page est figée dans les pixels. Cette seule contrainte engendre une cascade de problèmes :
La longueur du texte change. Une courte expression anglaise peut gonfler de 30 % ou plus en allemand ou en français, tandis que la même expression se contracte fortement en chinois ou en japonais. L'espace prévu dans le design d'origine est fixe, la traduction doit donc être réajustée — redimensionnée, réorganisée sur plusieurs lignes ou recomposée avec un autre interlettrage — sans briser la composition.
Les polices et le style doivent correspondre. La police d'origine, la graisse, la couleur, l'interlettrage et les effets comme les ombres ou les contours doivent tous être reproduits. Si vous vous trompez, la version localisée paraît subtilement étrangère à côté de l'originale.
L'arrière-plan doit être reconstruit. Effacer le texte source détruit les pixels situés en dessous. Sur une couleur unie, c'est trivial ; sur une photo, un dégradé ou une texture, vous reconstruisez une partie manquante de l'image.
Les éléments non textuels demandent aussi de l'attention. Les flèches, les annotations, la numérotation et les légendes contiennent souvent du texte ou pointent vers du texte ; une localisation propre doit donc en tenir compte.
Chaque méthode ci-dessous est une manière différente d'équilibrer ces quatre problèmes. Le bon choix dépend du degré de fidélité exigé du résultat, de la quantité de texte contenue dans l'image et du fait que vous disposiez ou non du fichier source d'origine.
La voie la plus rapide : la traduction d'images par IA en ligne
Avant les méthodes manuelles, sachez que le raccourci existe — et c'est celui par lequel la plupart des gens devraient commencer.
Les outils d'IA en ligne conçus pour ce travail précis, comme ReWords AI, réunissent la détection de texte, la traduction automatique et l'inpainting d'image par IA en un seul flux. Au lieu de superposer une nouvelle zone de texte, ils détectent le texte déjà présent dans l'image, le traduisent, effacent l'original, reconstruisent l'arrière-plan et redessinent la traduction avec une police, une couleur et une taille correspondantes — afin que la mise en page reste en place.
Comment cela fonctionne :
- Importez l'image. Ouvrez l'outil, choisissez la fonction « Translate Text in Image » et importez l'image (par exemple, une publicité avec une bannière « SUMMER SALE »).
- Choisissez une langue et éditez. La plateforme détecte automatiquement chaque ligne de texte. Sélectionnez votre langue cible, et elle vous renvoie une suggestion de traduction ligne par ligne que vous pouvez corriger manuellement. Verrouillez les mots qui ne doivent pas changer, comme les noms de marque.
- Générez. Cliquez sur Generate ou Apply, et l'IA supprime le texte d'origine et redessine la traduction en utilisant la police, la couleur et l'arrière-plan d'origine.
- Téléchargez. Examinez le résultat et téléchargez l'image localisée.
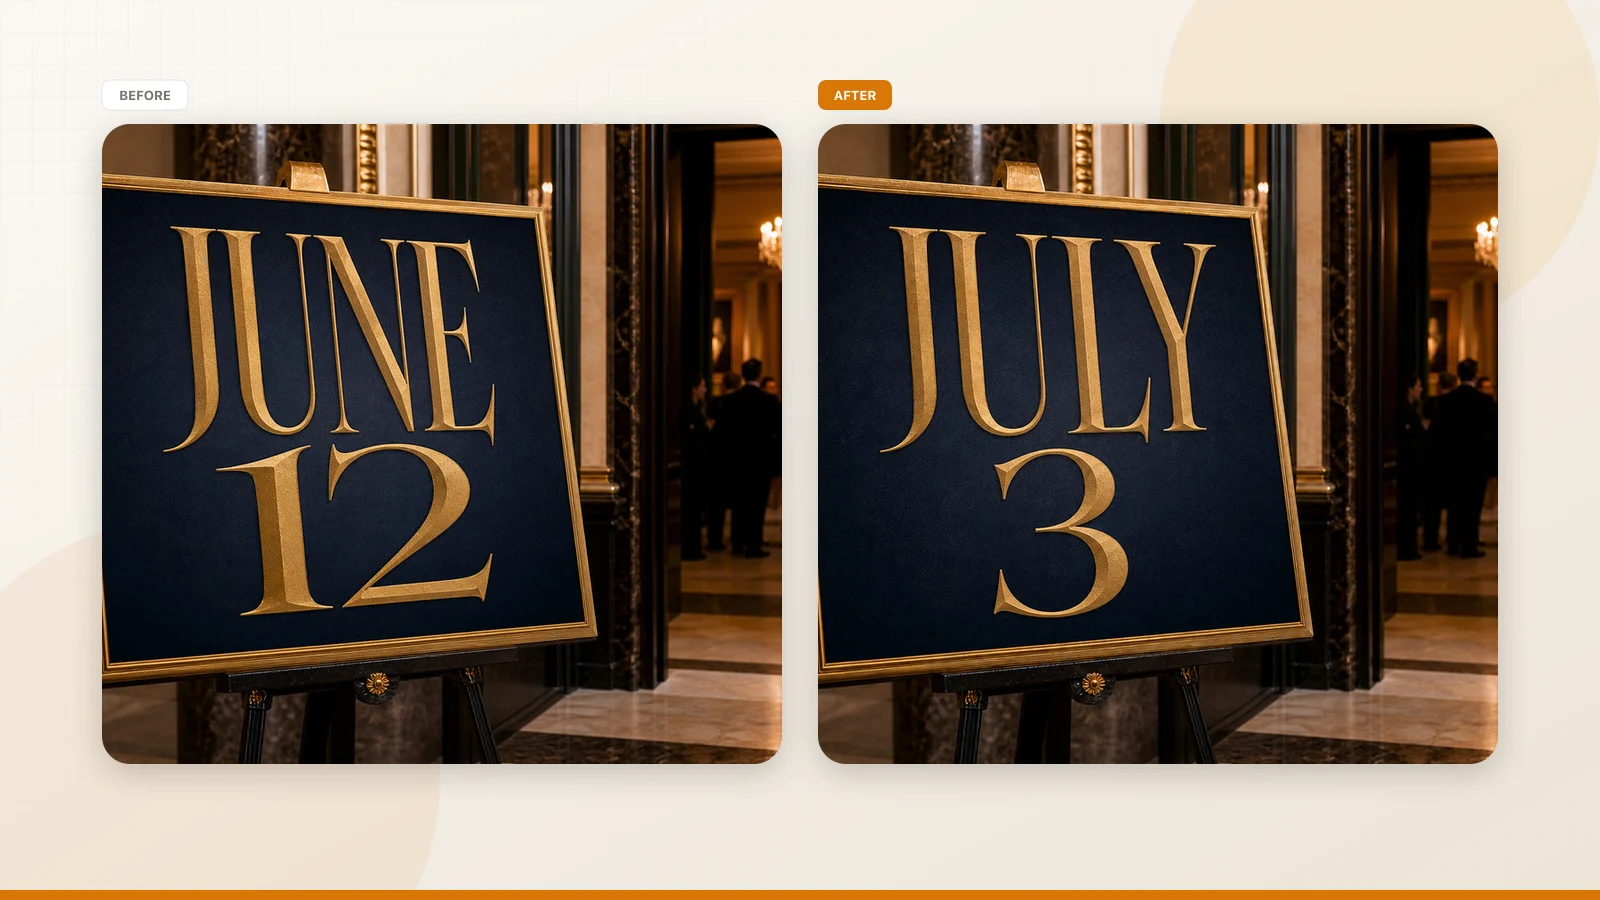
Figure : exemple de traduction par IA en ligne (à gauche : original, à droite : traduit).
Pourquoi c'est le choix par défaut : aucune source de design, aucune installation logicielle et aucune compétence en design ne sont nécessaires. Une image typique revient en quelques secondes à une minute. Les outils de cette catégorie incluent généralement un quota gratuit (ReWords propose quelques générations gratuites par image), au-delà duquel il faut payer ou utiliser des crédits.
Où rester vigilant : la traduction elle-même mérite une vérification — en particulier les nombres et les noms propres — et un texte dense, un éclairage complexe ou des polices extrêmement décoratives peuvent parfois mettre en échec la reconstruction de l'IA. Il vaut aussi la peine d'être attentif aux questions de droits d'auteur et de contenu sensible.
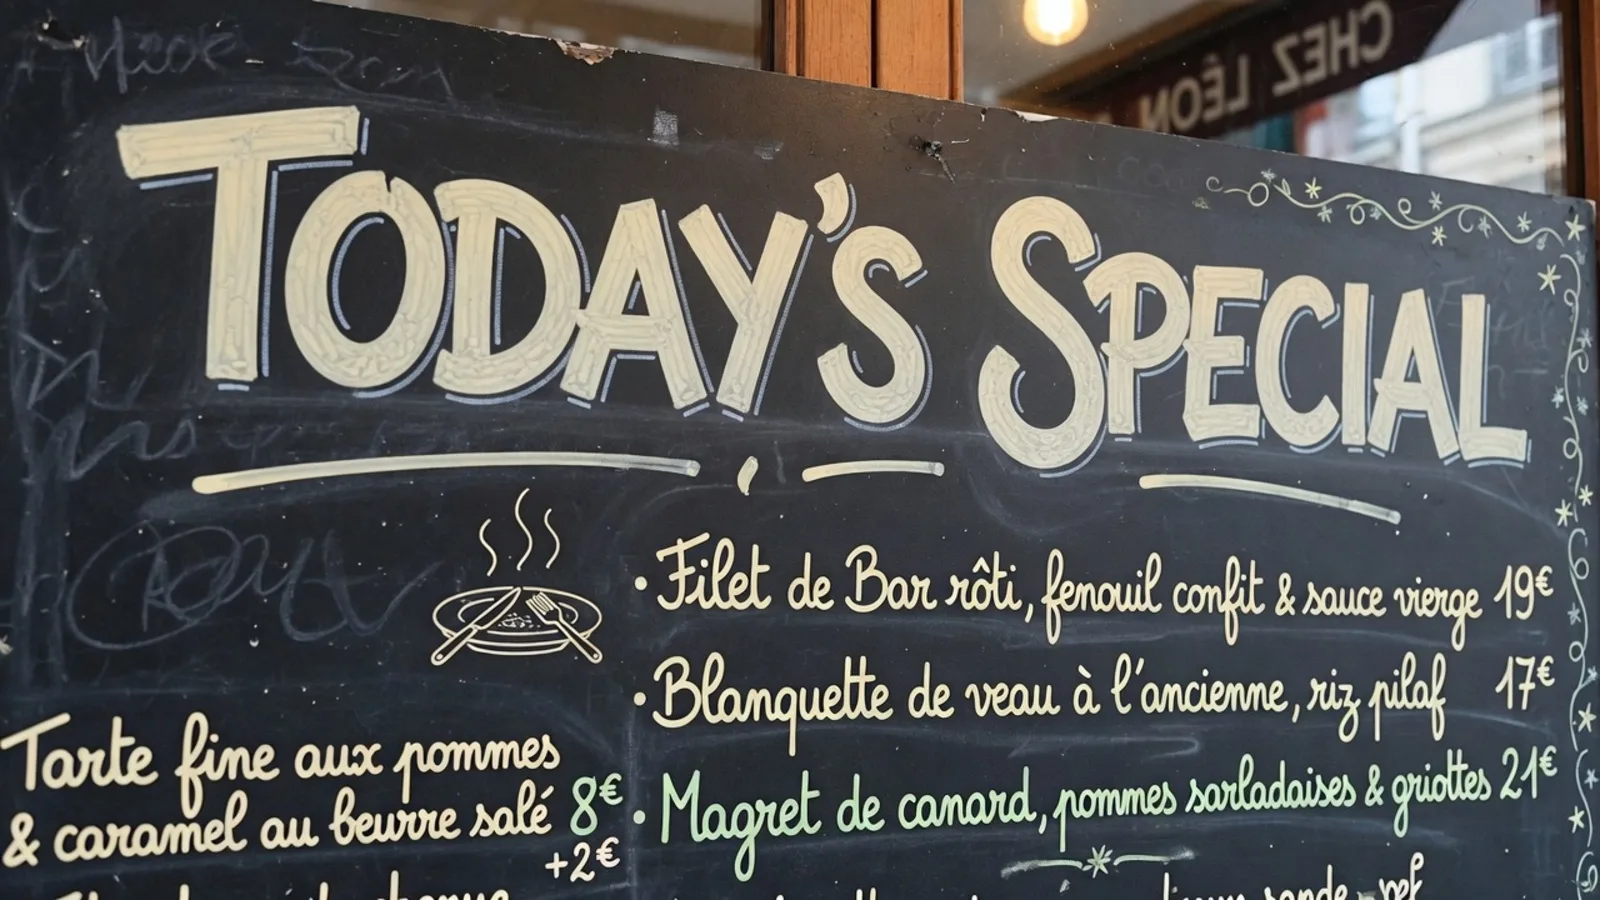
Meilleure adéquation réelle : les images produits du e-commerce, les visuels publicitaires et de réseaux sociaux localisés, les menus, les flyers et les bandes dessinées — les tâches de localisation du quotidien pour lesquelles vous ne disposez plus du fichier d'origine.
La boîte à outils complète : 10 façons de traduire le texte d'une image sans casser le design
Si l'image est complexe, si les enjeux sont élevés, ou si vous préférez construire votre propre pipeline, voici les dix approches qui méritent d'être connues. Chacune détaille son fonctionnement, ce dont elle a besoin, son degré de fidélité et à qui elle s'adresse.
Méthode 1 : édition manuelle dans un logiciel de design (Photoshop / Illustrator)
Comment cela fonctionne : un designer professionnel le fait à la main. D'abord, il extrait le texte d'origine (via OCR ou transcription manuelle) et le traduit. Ensuite, dans Photoshop, Illustrator ou un outil similaire, il ressaisit la traduction avec une police et un style correspondants, par-dessus la zone de texte d'origine. Le pipeline se déroule ainsi : extraire le texte → traduire et relire → trouver ou recréer la police correspondante → effacer le texte d'origine, insérer la traduction et ajuster les effets.
Outils : Adobe Photoshop, Illustrator, InDesign, GIMP, Figma ; des outils OCR comme Tesseract peuvent faciliter l'extraction.
Entrée / sortie : toute image en entrée (PNG/JPEG) ; une nouvelle image en sortie dans le même format, ou un fichier PSD/AI modifiable avec des calques.
Automatisation : faible. Essentiellement manuel, l'automatisation ne concerne que l'étape d'extraction OCR.
Précision et fidélité : maximales. Le designer contrôle entièrement la police, la position et le style et peut reproduire le design d'origine au pixel près. La fidélité dépend de la compétence, c'est lent, et c'est sensible à l'allongement du texte traduit.
Temps et coût : élevés. Une édition professionnelle peut prendre de quelques minutes à plusieurs heures selon la complexité, et le logiciel présente une courbe d'apprentissage — peu efficace lorsqu'on traduit en volume.
Avantages et inconvénients : préserve entièrement la mise en page et le style (en théorie, un remplacement transparent), ce qui convient aux contenus marketing et de marque exigeants. Mais c'est lent, coûteux et sujet aux erreurs, et sans la police identique, une correspondance parfaite est difficile.
Idéal pour : les affiches publicitaires, le design d'emballage, les prototypes d'interface et les supports imprimés qui exigent une localisation de haute fidélité.
Note de cas : Atlas Cloud souligne qu'après l'extraction OCR du texte, celui-ci doit encore être « replacé dans le design » à la main, tandis que la pure édition d'image fusionne les modifications sur un nouveau calque raster avec moins de contrôle sur les lettres individuelles — la composition manuelle est plus lente mais la plus précise.
Méthode 2 : OCR + composition dans un logiciel de design
Comment cela fonctionne : un pipeline semi-manuel un peu plus automatisé. D'abord, exécuter un OCR sur l'image pour extraire le contenu et la position de chaque zone de texte. Ensuite, obtenir les traductions via une traduction automatique ou humaine. Enfin, restituer la traduction dans l'image aux positions et styles d'origine à l'aide d'un logiciel de mise en page ou d'un script. Pipeline : reconnaissance OCR → traduction du texte → reconstruction de la mise en page → image de sortie.
Outils : des bibliothèques et applications OCR (Tesseract, EasyOCR, Adobe Acrobat OCR) ; des API de traduction (Google Translate, DeepL, Baidu Translate) ; des outils de mise en page (Adobe InDesign, Photoshop, ou Pillow/Matplotlib dans un environnement de programmation).
Entrée / sortie : toute image en entrée (PNG/JPEG) ; une nouvelle image en sortie. Un document vectoriel (PDF/AI) peut servir d'intermédiaire pour préserver la mise en page.
Automatisation : moyenne. L'OCR et la traduction peuvent être automatisés, mais la composition finale nécessite généralement une intervention humaine — surtout lorsque la langue source et la langue cible diffèrent fortement en longueur et qu'il faut ajuster la taille de police et l'interligne.
Précision et fidélité : élevées. Si vous faites correspondre les polices et les positions de cadre, la mise en page est bien préservée. Mais l'allongement de la traduction peut casser la répartition spatiale d'origine, exigeant une mise à l'échelle ou un retour à la ligne, et les erreurs de positionnement sur des graphiques complexes nuisent à la fidélité.
Temps et coût : moyens. La partie OCR et traduction est rapide (de quelques secondes à quelques minutes), mais la composition qui suit prend de quelques minutes à plusieurs dizaines de minutes.
Avantages et inconvénients : plus rapide que le travail purement manuel, mais dépend de la précision de l'OCR et de la correspondance des polices ; de minuscules différences d'interlettrage et de ligatures peuvent s'immiscer. Convient aux images riches en texte avec des exigences de design élevées. Le hic : ne gère pas les éléments non textuels (lignes de rappel, numérotation) — ceux-ci demandent un travail manuel.
Idéal pour : localiser les annotations de graphiques, les manuels techniques et les schémas pédagogiques comportant de nombreux éléments textuels.
Contexte : les outils de traduction de PDF suivent généralement cette logique — analyser la structure du document, traduire région par région, puis « remplacer le texte sur place et préserver la mise en page ». Appliquez l'OCR et une traduction bloc par bloc à une image, et vous obtenez le même résultat sur place.
Méthode 3 : services de traduction de documents dédiés (préservant le format)
Comment cela fonctionne : utiliser un service de traduction préservant le format, d'entreprise ou en ligne. Ces outils analysent la mise en page et les polices du fichier ou de l'image en entrée, traduisent automatiquement chaque bloc de texte et recomposent la sortie. Étapes clés : analyse de la mise en page (identifier les coordonnées des zones de texte, les polices) → traduction du texte (service cloud ou MT local) → re-rendu de la mise en page → fichier de sortie. Les images sont généralement préservées intactes.
Outils : des plateformes en ligne ou des logiciels commerciaux comme PDFTranslator (moteurs Gemini + ChatGPT), la plateforme Pangeanic ECO, Pairaphrase et Smartcat. Beaucoup acceptent une entrée PDF ou image et produisent un PDF ou un graphique traduit qui conserve le style d'origine.
Entrée / sortie : des scans, des images ou des PDF en entrée (JPG/PNG/PDF) ; un fichier traduit dans le même format en sortie, avec la mise en page, les tableaux et les positions des graphiques pratiquement intacts.
Automatisation : élevée. Le système fonctionne de bout en bout, ne nécessitant qu'une légère relecture humaine.
Précision et fidélité : élevées. Les services avancés utilisent un OCR de haute précision ainsi que des LLM/systèmes de traduction dédiés pour obtenir une correspondance au niveau des coordonnées entre texte et format. La mise en page et les polices sont préservées (la fidélité au niveau du document peut atteindre plus de 90 %), l'erreur provenant principalement des différences de longueur de traduction.
Temps et coût : faibles. La traduction est rapide — de quelques secondes à quelques minutes pour la plupart des tâches (un PDF de 60 pages en quelques minutes). Mais il s'agit généralement d'un service payant ou qui exige l'achat de quota d'API.
Avantages et inconvénients : l'avantage est une automatisation élevée, un gain de temps et une bonne fidélité. L'inconvénient est la sensibilité aux frais d'API (les documents volumineux ou en lot coûtent de l'argent) et une prise en charge limitée des mises en page inhabituelles ou de l'écriture manuscrite. Convient à la traduction de documents ou d'images en lot.
Idéal pour : les documents techniques multilingues d'entreprise, les manuels produits, les supports de formation et les rapports financiers dont la mise en page doit être fidèlement préservée. En coulisses, ces systèmes sont essentiellement le pipeline OCR + traduction + composition automatique.
Méthode 4 : outils de traduction d'images par IA en ligne
Comment cela fonctionne : des services d'IA dédiés traduisent et modifient le texte directement dans une image, souvent en utilisant l'apprentissage profond pour « masquer et repeindre » automatiquement. Généralement : importer l'original → OCR automatique des zones de texte → traduction automatique (avec relecture manuelle) → le modèle efface l'original et repeint la traduction dans un style de police similaire → télécharger la nouvelle image. Ces outils regroupent OCR, MT et complétion d'image en une traduction en un clic.
Outils : ReWords AI, ImageGPT, EditTextImage, Codia, VisualGPT et similaires. Les interfaces permettent souvent de verrouiller les lignes de texte qui ne doivent pas changer et de modifier la traduction suggérée.
Entrée / sortie : une image bitmap ordinaire en entrée (PNG/JPEG) ; une image bitmap de même résolution en sortie, avec la traduction rendue dans le style d'origine.
Automatisation : élevée. Vous importez et cliquez sur « generate » ; l'IA gère les étapes intermédiaires.
Précision et fidélité : globalement élevées. Les modèles génératifs modernes font suffisamment bien correspondre le style de police et la texture de l'arrière-plan pour produire des résultats « sans modification visible », même si un texte très dense, un éclairage complexe ou des polices très décoratives peuvent introduire des défauts. La précision de l'OCR dépend de la qualité de la source, et la traduction automatique est largement neuronale — la qualité varie et justifie une relecture humaine.
Temps et coût : faibles à moyens. La plupart des outils en ligne répondent en quelques secondes à une minute (souvent avec des limites d'utilisation gratuite), ne nécessitent aucune installation locale et sont conviviaux pour les utilisateurs non techniques ; le travail en volume exige un paiement ou des crédits.
Avantages et inconvénients : pratique et efficace, il remplace le texte directement sur l'image sans le fichier de design d'origine. Mais la qualité dépend de l'IA, nécessitant parfois des réessais ou un affinage du prompt, et vous devez traiter les droits d'auteur et les informations sensibles avec précaution.
Idéal pour : la localisation quotidienne des images produits du e-commerce, des publicités et visuels de réseaux sociaux localisés, des menus, des flyers et des bandes dessinées. Par exemple, ReWords montre le remplacement de « SUMMER SALE » sur un emballage produit par « 夏季特卖 » tout en gardant l'arrière-plan identique, et EditTextImage montre « Summer sale — 30% off everything » traduit en allemand « Sommer-Sale — 30 % auf alles » avec la mise en page inchangée. Ce sont des scénarios de localisation classiques.
Figure : exemple de traduction par un outil d'IA en ligne (à gauche : original, à droite : traduit).
Méthode 5 : applications mobiles de traduction instantanée
Comment cela fonctionne : utiliser l'application de traduction d'images d'un téléphone (Google Translate, mode caméra de Baidu Translate, Microsoft Translator) sur une photo ou une image importée. La plupart reconnaissent le texte en temps réel et superposent la traduction à l'écran, ou produisent un instantané avec le texte traduit. Flux : prendre/importer une photo → OCR automatique → traduction automatique → superposer ou marquer l'original → consulter le résultat.
Outils : l'application Google Translate, la caméra Baidu Translate, la fonction scan-traduction intégrée à WeChat et similaires.
Entrée / sortie : une photo ou capture d'écran de téléphone en entrée ; en sortie, généralement une image superposée ou le texte traduit. Certains proposent d'enregistrer une image annotée.
Automatisation : entièrement automatique. Aucune saisie de texte requise — simple à utiliser.
Précision et fidélité : faibles. L'objectif principal est la compréhension ; la traduction utilise une police par défaut et un masque d'arrière-plan grossier, et la mise en page et le style d'origine ne sont pas du tout préservés. La qualité de l'OCR et de la traduction est proche de celle des outils professionnels, mais la sortie n'est pas utilisable comme fichier de design publiable.
Temps et coût : extrêmement faibles. Traduction en temps réel, généralement en quelques secondes.
Avantages et inconvénients : rapide et pratique, sans expertise requise — suffisant pour un usage quotidien. Mais il ne peut pas préserver le design d'origine, peut ajouter un logo ou un filigrane, et la sortie est uniquement destinée à la lecture de référence, pas à la publication finale.
Idéal pour : comprendre rapidement des menus, des panneaux de rue et des manuels en langue étrangère en voyage ou dans la vie quotidienne. Les utilisateurs qui photographient du texte avec Baidu Translate et enregistrent l'image voient souvent la marque de l'outil ou un patch en recouvrir une partie. Ces outils conviennent mieux à l'aide à la lecture qu'à une localisation formelle.
Méthode 6 : édition par grand modèle multimodal (par ex. GPT-4 Vision)
Comment cela fonctionne : utiliser les derniers modèles d'IA multimodaux (GPT-4V/4.5, édition d'images de ChatGPT, édition de DALL·E 3 d'OpenAI) pour une édition d'image de haut niveau pilotée par instructions. Vous fournissez l'image d'origine et utilisez un prompt en langage naturel pour « traduire le texte tout en gardant le design inchangé ». Le modèle combine détection de texte, compréhension sémantique et génération d'image pour changer les mots tout en préservant les éléments de mise en page et le style. Flux : image d'entrée + instruction → le modèle reconnaît et traduit le texte → le modèle génère une nouvelle image → relecture humaine.
Outils : OpenAI ChatGPT (avec des fonctions d'image comme GPT-4V), l'API d'édition d'images DALL·E 3, Google Imagen Editor (surtout au stade de la recherche) et un accès développeur via l'API OpenAI.
Entrée / sortie : une image plus un prompt textuel en entrée ; une nouvelle image en sortie (généralement à la résolution d'origine ou telle que spécifiée).
Automatisation : élevée. Un simple prompt suffit ; le modèle fait le reste.
Précision et fidélité : généralement élevées. Ces modèles préservent bien les relations de mise en page et le style. Les exemples officiels d'OpenAI montrent la traduction d'un schéma d'instructions de machine à café en espagnol tout en conservant la mise en page, et Atlas Cloud rapporte que GPT-4V traduit le texte d'une infographie dans d'autres langues tout en laissant le reste intact. Néanmoins, ils peuvent manquer certains textes ou introduire de légers décalages — surtout lorsque la longueur du texte traduit diffère fortement de l'original — des corrections ultérieures peuvent alors être nécessaires.
Temps et coût : moyens. Générer une image prend généralement de quelques secondes à plusieurs dizaines de secondes, mais les modèles avancés nécessitent des appels serveur avec des coûts d'API ou d'abonnement, en plus de votre temps pour rédiger les prompts et examiner la sortie.
Avantages et inconvénients : une expérience conviviale avec des images traduites en un clic, et il préserve les relations visuelles (flèches, légendes, hiérarchie de mise en page) dans des arrière-plans complexes. Mais le contrôle fin est limité — attendez-vous à des fautes d'orthographe, du texte non traduit ou des artefacts de composition qui demandent un œil humain. Il ne peut pas encore remplacer une composition fine, mais il performe bien dans la plupart des scénarios marketing.
Idéal pour : localiser rapidement des infographies, des affiches et des supports promotionnels illustrés. Par exemple, vous pouvez donner à ChatGPT une image publicitaire anglaise et le prompt « traduis tout le texte en chinois, ne change rien d'autre », et le modèle génère l'image dans la langue correspondante.
Figure : exemple de traduction multimodale avec GPT-4V (à gauche : entrée en coréen, à droite : sortie en vietnamien).
Méthode 7 : édition par modèle de diffusion profond (DALL·E, Stable Diffusion)
Comment cela fonctionne : l'édition d'image basée sur la diffusion masque la zone de texte sur l'image d'origine, puis génère un contenu de remplacement à partir d'un prompt. Flux général : détecter le texte et générer un masque → concevoir le prompt (par ex. « remplacer X par Y, garder l'arrière-plan inchangé ») → utiliser DALL·E 3 ou Stable Diffusion Inpainting pour combler → obtenir la nouvelle image. Par exemple, importez l'original et un masque de texte dans l'API d'OpenAI, puis envoyez une requête d'édition « replace text ».
Outils : l'API d'édition DALL·E 3 d'OpenAI, Adobe Firefly Generative Fill, HuggingFace Diffusers (par ex. runwayml/stable-diffusion-inpainting). Des contrôles comme la détection de texte ControlNet et l'inpainting LaMa aident à marquer les zones à remplacer.
Entrée / sortie : l'original + un masque de texte + un prompt en entrée ; un fichier image en sortie. Le modèle fait généralement correspondre automatiquement la langue et le style de la traduction.
Automatisation : moyenne à élevée. L'étape de masquage nécessite un outil supplémentaire (dessiné à la main ou généré par programme), mais la génération elle-même se fait en un clic.
Précision et fidélité : élevées, mais légèrement inférieures aux modèles d'édition de texte dédiés. Les modèles de diffusion sont souvent imprécis avec les textes longs (ils peuvent casser les mots), et la cohérence du style dépend de la qualité du prompt. La force, c'est la réparation de l'arrière-plan — il peut intégrer naturellement les traductions dans des textures complexes. La faiblesse, ce sont parfois des formes de lettres imparfaites, un léger flou ou des détails indésirables. Les meilleurs résultats exigent des masques et des prompts ajustés.
Temps et coût : moyens. Générer une image prend généralement de dix à plusieurs dizaines de secondes (ou dépend de votre GPU en local) ; les services cloud ajoutent un temps de file d'attente.
Idéal pour : la traduction créative — concept art, slogans dans des illustrations — et tout cas où un léger changement de style est acceptable. Dans l'exemple ci-dessous, Stable Diffusion a traduit la bannière anglaise « Summer sale — 30% off everything » en allemand « Sommer-Sale — 30 % auf alles », en la restituant tout en gardant l'arrière-plan inchangé.
Figure : exemple de remplacement de texte par Stable Diffusion (à gauche : bannière anglaise d'origine, à droite : résultat en allemand).
Méthode 8 : pipeline personnalisé vision par ordinateur + script
Comment cela fonctionne : un pipeline d'automatisation entièrement construit par vous. Utiliser la vision par ordinateur pour détecter les zones de texte (par ex. la détection de bords/contours d'OpenCV ou un modèle OCR profond), la combiner avec une API de traduction automatique, et dessiner la traduction sur l'image d'origine avec une bibliothèque d'images (Pillow/OpenCV). Étapes : détection de texte → OCR et traduction par zone → découper et combler l'arrière-plan de la zone de texte (avec un algorithme d'inpainting) → dessiner le nouveau texte → sortie.
Outils : Python (Pillow, OpenCV, EasyOCR, pytesseract, API de traduction Baidu ou Google), Adobe PixelSense, traitement d'images en C#/.NET et similaires.
Entrée / sortie : un bitmap ordinaire en entrée ; un bitmap de même résolution en sortie. Tout le flux est construit à la main ou scripté, sans interface graphique prête à l'emploi.
Automatisation : élevée (si le script est bien conçu). Entièrement traitable en lot.
Précision et fidélité : dépendent des détails de l'algorithme. Il peut correspondre grossièrement à la mise en page mais ne peut généralement pas faire correspondre les polices automatiquement — vous choisissez la plus proche à la main. Il ne peut pas non plus réparer les arrière-plans aussi harmonieusement que les modèles de diffusion, comblant souvent les trous avec une couleur unie ou une moyenne de voisinage, et il est limité sur les arrière-plans complexes ou les polices non standard.
Temps et coût : coût de développement élevé (nécessite de la programmation), le temps d'exécution dépendant de l'efficacité de l'OCR et du dessin (quelques secondes par image). Par rapport aux services tiers, il est gratuit en argent mais exige un gros effort de codage.
Avantages et inconvénients : contrôle total du pipeline et bon pour l'automatisation en lot, mais la fidélité des détails de design est inférieure à celle des outils d'IA dédiés et nécessite un réglage des paramètres et des corrections a posteriori. Convient aux scénarios de personnalisation poussée ou de confidentialité des données (sans réseau public).
Idéal pour : les environnements d'entreprise aux exigences de processus particulières, ou le remplacement simple d'étiquettes à petite échelle — par ex. un marchand qui scripte un flux pour OCR, traduire et réécrire les étiquettes d'images produits. Techniquement exigeant mais flexible.
Méthode 9 : service professionnel humain + DTP
Comment cela fonctionne : externaliser à une équipe de traduction et de design. Un traducteur professionnel traduit d'abord le texte, puis un designer de publication assistée par ordinateur (DTP) le remplace étape par étape en se référant à l'original. Cela comprend : identifier et éditer le fichier source (PSD/InDesign) → traduire le texte → ajuster la mise en page et restituer dans le même logiciel.
Outils : généralement la suite Adobe, InDesign, Illustrator. Les prestataires peuvent utiliser des outils de TAO (Trados, MemoQ) pour assurer la cohérence terminologique, mais la sortie finale dépend du logiciel de design.
Entrée / sortie : toute image ou fichier source en entrée ; généralement une image localisée de haute qualité ou un fichier modifiable en sortie.
Automatisation : faible. Un service entièrement manuel nécessitant une intervention humaine à chaque étape.
Précision et fidélité : maximales. Les traducteurs et les designers peuvent adapter le texte aux nuances culturelles tout en préservant ou ajustant précisément le design, et la qualité de la sortie est garantie par des professionnels.
Temps et coût : les plus élevés. Les coûts combinent les frais de traduction et le temps de design, généralement bien plus élevés que les options automatiques. Convient aux projets de grande valeur ou aux contenus très sensibles.
Avantages et inconvénients : une qualité et une fiabilité de premier ordre, à un coût et un délai bien plus élevés que toute méthode automatisée.
Idéal pour : les campagnes d'image de marque, les supports de salons majeurs, le contenu imagé des documents gouvernementaux ou juridiques, et les publications localisées nécessitant une relecture humaine.
Méthode 10 : traduction automatique via des fichiers vectoriels / sources
Comment cela fonctionne : si l'image source provient d'un logiciel vectoriel ou de design, vous pouvez remplacer le texte à l'intérieur de l'environnement de design. Par exemple, InDesign ou Illustrator avec des plugins ou des scripts peuvent extraire le texte via OCR ou conversion automatique, le traduire et le réinsérer dans les blocs de texte. Sinon, convertissez l'image en PDF, faites-en une traduction OCR, puis réimportez-la.
Outils : Adobe Acrobat (OCR + export vers Word), la fonction rechercher-remplacer du texte d'Illustrator, les scripts d'InDesign ou des plugins tiers (Lokalise, le plugin InDesign de Transifex, etc.).
Entrée / sortie : généralement un document modifiable ou un PDF en entrée ; le texte remplacé directement dans le fichier d'origine en sortie.
Automatisation : moyenne. Dépend de l'automatisation et de la prise en charge des scripts du logiciel.
Précision et fidélité : élevées. Comme vous éditez directement la source, tous les calques et effets sont préservés — à condition que le fichier d'origine soit disponible. S'il s'agit d'une image déjà aplatie, une aide OCR est nécessaire et le comportement est celui de la méthode 2.
Temps et coût : moyens. Le remplacement automatisé nécessite encore un réglage fin humain.
Avantages et inconvénients : une composition précise à partir du fichier source, mais cela dépend de la disponibilité du fichier modifiable d'origine et du bon logiciel.
Idéal pour : les projets de traduction où vous détenez la source du design — par ex. la traduction d'un manuel mis en page avec InDesign — ou les situations d'urgence où vous faites d'abord une traduction OCR grossière puis affinez dans le fichier source.
Le comparatif côte à côte
| Méthode | Fidélité du design | OCR / reconnaissance | Multilingue | Difficulté technique | Coût | Vitesse | Idéal pour |
|---|---|---|---|---|---|---|---|
| 1. Logiciel de design pro (manuel) | Très élevée | N/A (humain) | Toutes | Élevée (nécessite un designer) | La plus élevée (main-d'œuvre) | Lente (manuelle) | Actifs de marque / marketing haut de gamme |
| 2. OCR + composition | Élevée | Élevée (texte structuré) | Nombreuses | Moyenne à élevée (logiciels/scripts) | Faible (open source) | Moyenne | Documentation technique, diagrammes annotés, graphiques structurés |
| 3. Service de traduction de documents | Élevée | Élevée (OCR professionnel) | Très nombreuses | Faible (clé en main) | Moyenne à élevée (frais de service) | Rapide | PDF/scans en lot, documents professionnels |
| 4. Outils d'IA en ligne (ReWords, etc.) | Élevée | Élevée (IA) | Nombreuses | Faible (clé en main) | Faible/moyenne (gratuit + payant) | Rapide | Affiches e-commerce, BD, localisation quotidienne multi-images |
| 5. Applications caméra de téléphone | Faible | Moyenne à élevée (prise à la main) | Nombreuses | Très faible (clé en main) | Faible (gratuit) | Temps réel | Lecture rapide en voyage / au quotidien |
| 6. Édition par grand modèle multimodal | Élevée | Élevée (modèle) | Très nombreuses | Faible (clé en main) | Moyenne à élevée (frais d'API) | Moyenne | Infographies, affiches pub, captures d'interface exigeant un raisonnement rapide |
| 7. Modèles de diffusion (DALL·E, etc.) | Moyenne à élevée | Moyenne (nécessite un masque) | Nombreuses | Moyenne (art du prompt) | Moyenne (API/calcul) | Moyenne | Design créatif, exigences de style souples |
| 8. Pipeline Python personnalisé | Moyenne | Moyenne (selon l'outil) | Nombreuses | Élevée (programmation) | Faible (open source) | Flexible (lot automatique) | Environnements d'automatisation (personnalisation entreprise, lot) |
| 9. Humain professionnel + DTP | Très élevée | N/A (humain) | Toutes | Très élevée (équipe experte) | La plus élevée (frais de service) | Très lente (manuelle) | Publications haut de gamme, exigences strictes de texte/format |
| 10. Traduction directe du fichier source | Très élevée | Élevée (depuis la source) | Nombreuses | Moyenne (logiciel de design) | Faible (logiciel existant) | Moyenne | Projets avec source modifiable (livres InDesign, traduction de rapports) |
Note : ici, « fidélité » désigne le degré de correspondance entre l'image traduite et le design d'origine. Les applications mobiles servent à la compréhension et ajoutent un large masque, donc la fidélité est faible ; les services professionnels de design et de traduction de documents préservent entièrement la mise en page et les polices, donc ils obtiennent une note élevée.
Trois tutoriels de bout en bout
Si vous voulez aller plus loin qu'un simple clic sur un bouton, voici les trois approches qui valent la peine d'être apprises. Chacune inclut le flux complet et du code fonctionnel.
Tutoriel 1 : édition multimodale avec GPT-4 Vision
Aperçu : cet exemple montre comment utiliser GPT-4 d'OpenAI avec des fonctions d'image (ou DALL·E) pour éditer le texte à l'intérieur d'une image. Préparation : inscrivez-vous auprès d'OpenAI et obtenez une clé API. Préparez une image d'exemple avec du texte et un masque correspondant. Supposons que nous voulions traduire l'anglais « Summer sale » en chinois « 夏季特卖 ».
Flux : fournir l'image d'origine → appeler le point de terminaison d'édition GPT-4V ou DALL·E → le modèle reconnaît et traduit le texte → le modèle génère une nouvelle image → télécharger et relire.
- Préparez l'image et le masque. Assurez-vous que l'original (
orig.png) et le masque (mask.png) sont alignés, le masque ne couvrant que la zone de texte « Summer sale ». - Appelez l'API (en utilisant le SDK Python d'OpenAI comme exemple) :
```python import openai openai.api_key = "YOUR_API_KEY"
Demandez au modèle de traduire le texte de la zone masquée en chinois
tout en laissant tout le reste inchangé.
response = openai.Image.create_edit( image=open("orig.png", "rb"), mask=open("mask.png", "rb"), prompt="用中文翻译上面的文字,不改变其他内容。", n=1, size="1024x768" )
Enregistrez l'image renvoyée sur le disque
with open("output.png", "wb") as f: f.write(response['data'][0]['image']) ```
Cela demande au modèle de traduire le texte de la région masquée en chinois et de laisser le reste intact, puis de générer le résultat.
- Examinez la sortie. Vérifiez
output.png. Le modèle devrait avoir remplacé « Summer sale » par « 夏季特卖 », avec un style de police similaire et un arrière-plan identique.
Figure : exemple de traduction avec GPT-4V (à gauche : coréen d'origine, à droite : sortie du modèle en vietnamien).
- Enregistrez le résultat. Utilisez
output.pnget, si besoin, ajustez finement la position ou le style du texte dans un éditeur d'images.
Mises en garde : relisez toujours le texte généré par GPT-4V. S'il manque quelque chose, essayez un prompt plus détaillé ou traduisez par blocs plus petits. L'API OpenAI facture selon la taille de l'image et le nombre de générations.
Tutoriel 2 : outils d'IA en ligne (ReWords / EditTextImage)
Aperçu : utilisez l'application ReWords ou un site similaire pour traduire une image — ReWords dans cet exemple. Préparation : ouvrez un outil en ligne tel que ReWords ou EditTextImage ; aucune installation requise.
Flux : importer l'original → le système fait l'OCR et détecte le texte → il traduit automatiquement et affiche le texte suggéré → vous ajustez le texte et verrouillez ce qui doit rester → l'IA génère la nouvelle image → télécharger l'image traduite.
- Importez l'image. Ouvrez le site ReWords, choisissez la fonction « Translate Text in Image » et importez l'image à traduire (ici, une publicité contenant « SUMMER SALE »).
- Choisissez une langue et éditez. La plateforme détecte chaque ligne de texte, vous choisissez la langue cible (par ex. le chinois), et elle renvoie des suggestions ligne par ligne. Corrigez les erreurs de traduction et verrouillez les mots qui ne doivent pas changer (comme les noms de marque).
- Générez l'image. Cliquez sur Generate ou Apply, et l'IA supprime le texte d'origine et redessine la traduction avec la police, la couleur et l'arrière-plan d'origine.
- Téléchargez le résultat. Téléchargez la nouvelle image. Dans l'exemple ci-dessous, à gauche se trouve l'image d'origine « SUMMER SALE » et à droite la version « 夏季特卖 » générée par ReWords.
Figure : exemple de traduction d'image avec ReWords (à gauche : original, à droite : traduit par IA).
Astuces : ces outils disposent généralement d'un quota gratuit (ReWords inclut plusieurs générations gratuites par image), au-delà duquel il faut payer ou utiliser des crédits. La qualité de traduction est élevée, mais vérifiez le texte — en particulier les nombres et les noms propres. C'est idéal lorsque vous ne pouvez pas obtenir le fichier de design d'origine et devez localiser l'image directement.
Tutoriel 3 : traduction automatisée avec Python OCR + OpenCV
Aperçu : un script qui extrait le texte d'une image, le traduit et le restitue dans l'image. Nous utiliserons Tesseract OCR avec OpenCV/Pillow pour traduire une image espagnole en anglais.
Flux : charger l'original → détection de texte et OCR (Tesseract) → appeler un moteur de traduction (API Google Translate) → utiliser OpenCV pour effacer la région du texte d'origine → dessiner la traduction avec Pillow → produire l'image localisée.
- Installez les dépendances (d'abord Tesseract-OCR et les bibliothèques Python) :
```bash
Installer Tesseract (exemple pour Ubuntu)
sudo apt-get install tesseract-ocr
Installer les bibliothèques Python
pip install pytesseract pillow googletrans==4.0.0-rc1 ```
- Le script :
```python from PIL import Image, ImageDraw, ImageFont import pytesseract from googletrans import Translator
Charger l'image d'origine
image = Image.open("image_with_text.png")
Exécuter l'OCR (reconnaître le texte espagnol)
text = pytesseract.image_to_string(image, lang='spa') print("Recognized text:", text)
Traduire le texte
translator = Translator() result = translator.translate(text, src='es', dest='en') print("Translation:", result.text)
Pour cet exemple, la position du texte est connue ; en production, vous
utiliseriez pytesseract.image_to_boxes pour obtenir une boîte par caractère.
x, y, w, h = 50, 50, 300, 50 # coordonnées d'exemple
Effacer le texte d'origine sur l'image
draw = ImageDraw.Draw(image) draw.rectangle(((x, y), (x + w, y + h)), fill="white") # couvrir en blanc
Dessiner le texte traduit
font = ImageFont.truetype("arial.ttf", size=36) draw.text((x, y), result.text, font=font, fill="black")
Enregistrer la sortie
image.save("translated_image.png") ```
- Comment cela fonctionne : le script fait d'abord l'OCR de l'original avec Tesseract, récupère la traduction avec Google Translate (
googletrans), puis utilise Pillow pour effacer la région d'origine et dessiner la traduction. L'exemple traite une seule région fixe ; une application réelle déterminerait les régions dynamiquement à partir des résultats OCR et ferait correspondre les polices (simplifié ici à titre d'illustration). - Sortie : son exécution produit
translated_image.png, avec la région du texte d'origine remplacée par la traduction anglaise.
Mises en garde : ce flux dépend de la précision du positionnement OCR et de la capacité à faire correspondre les polices. En pratique, combinez la détection de contours d'OpenCV pour un découpage précis, et utilisez Pillow pour mesurer la largeur du texte en vue d'un retour à la ligne automatique. Pour du texte multiligne, parcourez chaque segment en boucle. L'ensemble peut être traité en lot, mais la fidélité de la mise en page est inférieure à celle des méthodes d'inpainting par IA, alors testez et attendez-vous à ajuster les paramètres.
Comment choisir : un guide de décision
Faites correspondre la méthode à trois critères — la fidélité, le coût et le fait que vous déteniez ou non le fichier source :
- Vous n'avez pas de fichier source et vous voulez aller vite (le cas courant) : utilisez un outil d'IA en ligne comme ReWords AI (méthode 4). Importez, choisissez une langue, générez, téléchargez.
- L'image est riche en texte et structurée (graphiques, manuels, schémas) : OCR + composition (méthode 2), ou un service de documents préservant le format pour le travail en lot (méthode 3).
- Le résultat doit être parfait à l'impression et critique pour la marque : design manuel (méthode 1) ou humain professionnel + DTP (méthode 9).
- Vous voulez l'automatiser au sein de votre propre flux de travail : une API de modèle multimodal (méthode 6) ou un pipeline Python personnalisé (méthode 8).
- Vous devez traduire un instantané rapide juste pour le lire : une application caméra de téléphone (méthode 5) — mais jamais pour publier.
- Vous détenez encore le fichier source modifiable : éditez-le directement (méthode 10). C'est le chemin le plus propre possible lorsqu'il est disponible.
Cinq règles pour préserver le design
Quelle que soit la voie que vous empruntez, ces habitudes séparent le « traduit » du « localisé professionnellement » :
- Prévoyez les variations de longueur du texte. L'allemand et le français s'allongent généralement ; le chinois et le japonais se contractent. Attendez-vous à redimensionner, réorganiser sur plusieurs lignes ou recomposer l'interlettrage, et ne supposez jamais que la traduction tient telle quelle dans le cadre d'origine.
- Faites correspondre la police, pas seulement les mots. Reproduisez la graisse, la couleur, l'interlettrage d'origine, ainsi que tout contour ou ombre. Une traduction parfaite dans une mauvaise police paraît quand même fausse.
- Reconstruisez proprement l'arrière-plan. La zone réparée derrière le texte doit être indiscernable de son environnement — adoucissez les bords et vérifiez la jointure à un zoom 1:1.
- Traitez les éléments non textuels. Les flèches, les annotations, la numérotation et les légendes portent souvent du texte ou y renvoient ; tenez-en compte pour que la version localisée reste cohérente.
- Relisez la traduction elle-même. La traduction automatique est rapide mais imparfaite. Les nombres, les unités, les noms de marque et les noms propres méritent une vérification humaine avant publication.
L'essentiel
Vous n'avez pas besoin du fichier de design d'origine pour traduire le texte à l'intérieur d'une image. Vous devez choisir la bonne méthode pour la fidélité visée — et pour la plupart des images du quotidien, cette méthode est un outil d'IA en un clic qui lit le texte, le traduit et le redessine sur place sans perturber la mise en page.
Quand les enjeux sont élevés et l'image complexe, les outils plus lourds — design manuel, services de traduction de documents ou DTP professionnel — gardent toute leur place. Mais pour la grande majorité des menus, affiches, images produits et visuels de réseaux sociaux, vous pouvez localiser en quelques minutes.
Prenez une image que vous avez toujours voulu traduire, importez-la dans ReWords AI et constatez à quel point une traduction par IA en une minute préserve le design, avant d'envisager la voie manuelle.
References
- Documentation d'OpenAI sur l'édition d'images et l'édition DALL·E.
- Recherches sur la traduction de PDF et d'images avec préservation du format.
- Reportage d'Atlas Cloud sur l'extraction OCR et le replacement dans les flux de travail de design.
- Documentation produit des outils de traduction d'images en ligne (ReWords AI, EditTextImage et similaires).
- Documentation de Tesseract OCR, OpenCV et Pillow pour les pipelines personnalisés.