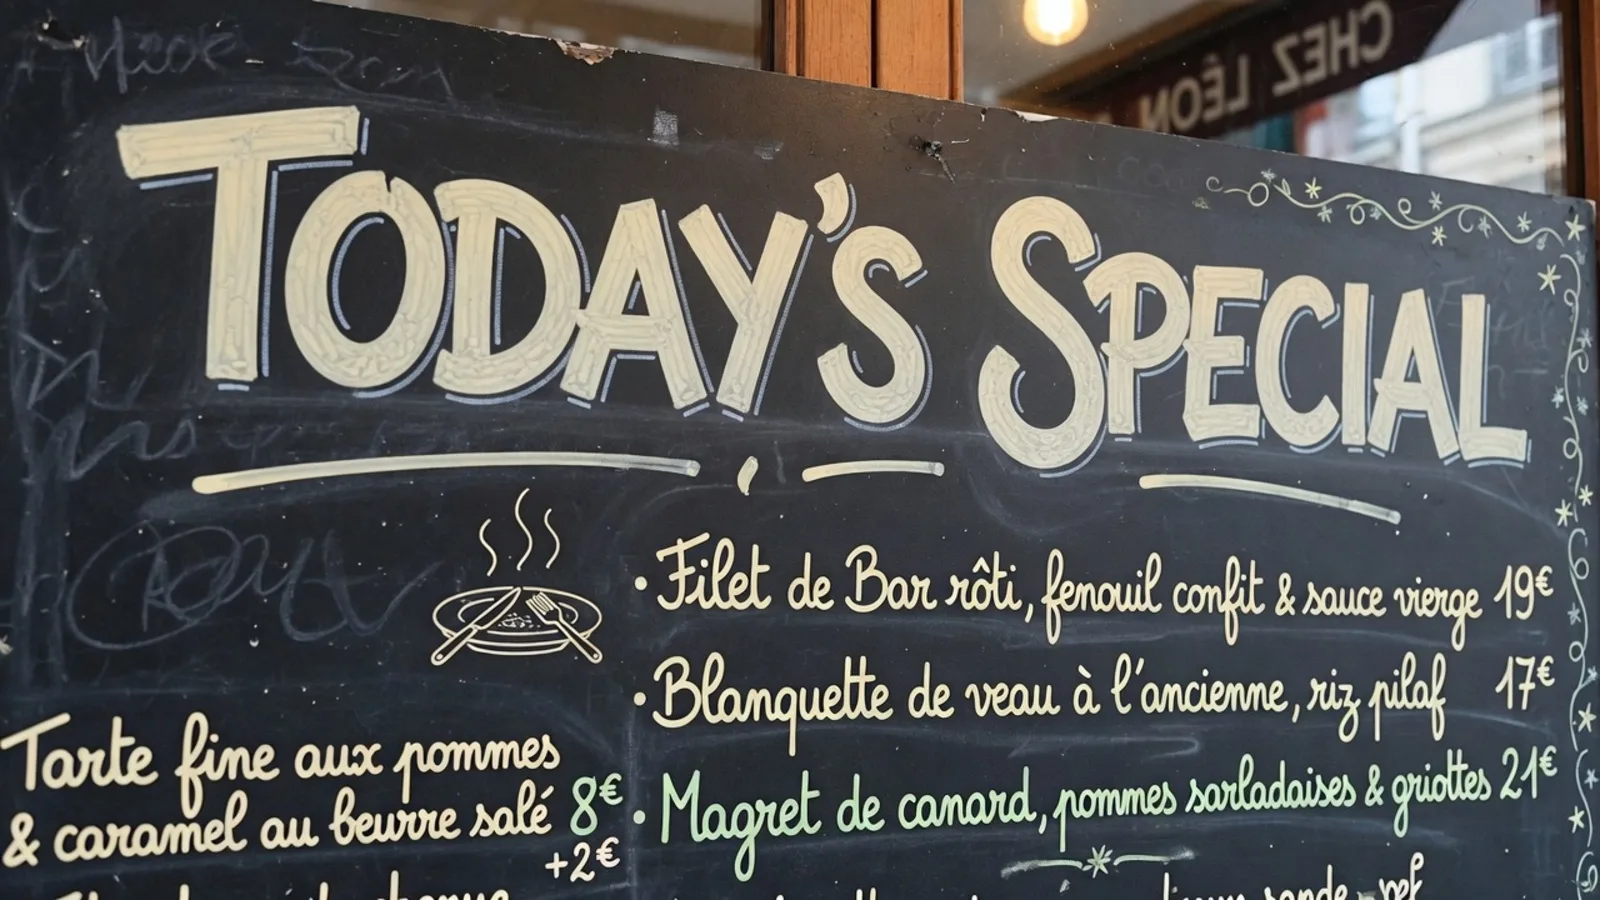
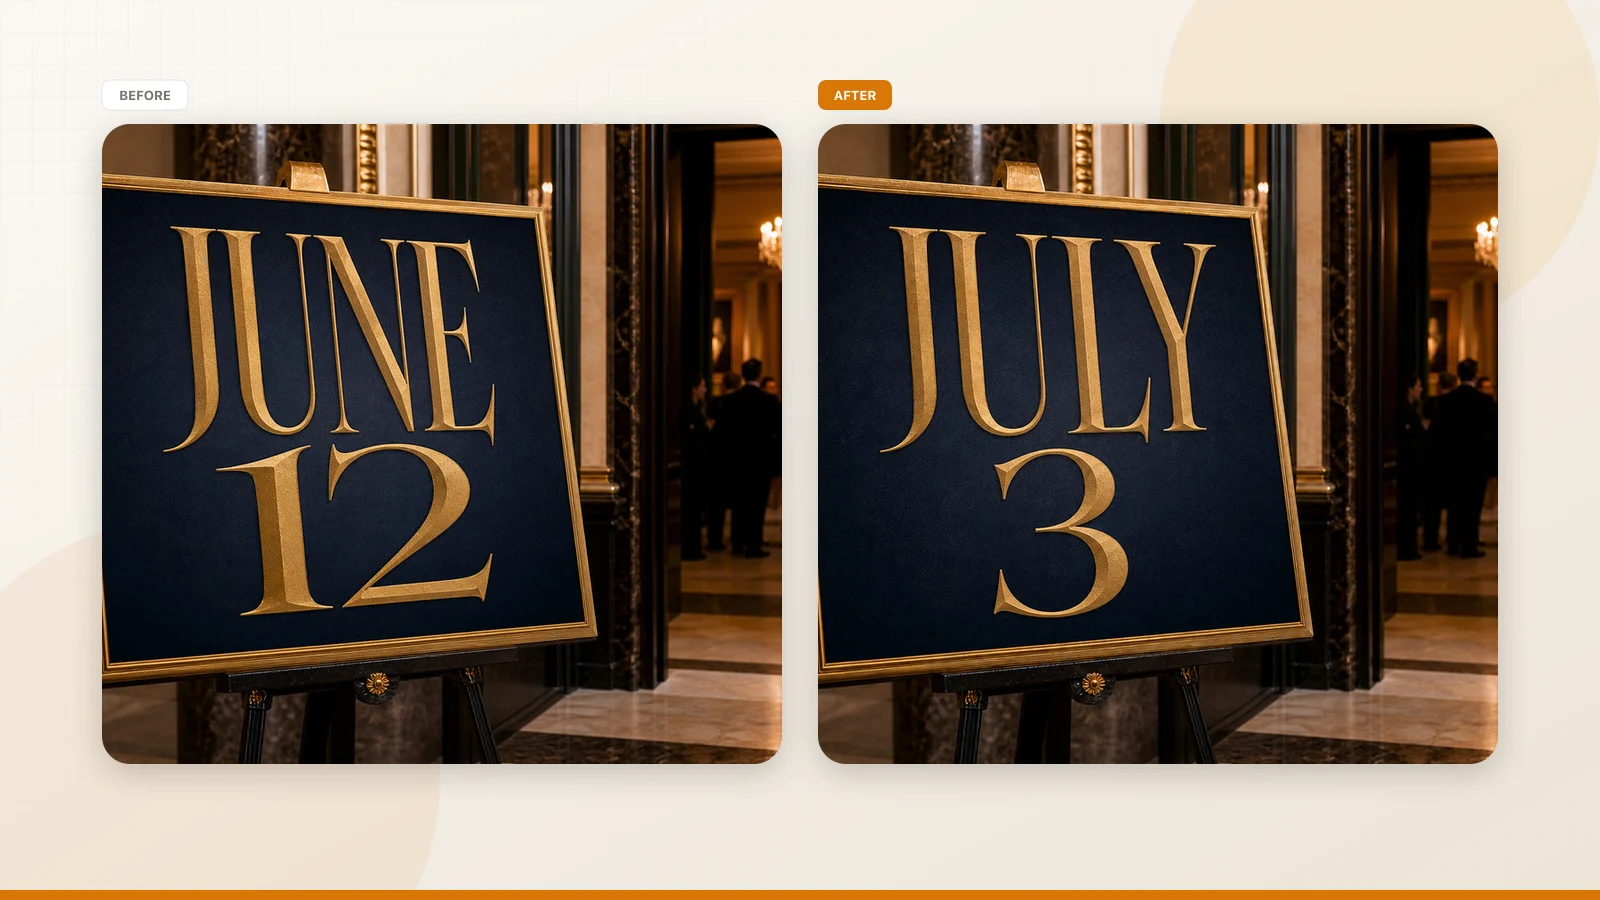
Diez formas de localizar las palabras dentro de una imagen ya terminada, manteniendo el diseño, las fuentes y el fondo exactamente como los dejó el diseñador.
Un cartel de campaña en inglés. Un menú en japonés. Una etiqueta de producto en alemán. Un diagrama técnico rotulado en español. Necesitas cada uno de ellos en otro idioma, y lo único que tienes es la imagen exportada.
Traducir un documento es sencillo: le entregas el texto a un traductor y recibes las palabras de vuelta. Traducir el texto dentro de una imagen es algo completamente distinto. No se trata solo de cambiar palabras. Estás editando píxeles de forma quirúrgica mientras el diseño de un diseñador te observa por encima del hombro, y cualquier error —una fuente que no encaja del todo, un fondo que no queda perfectamente alineado, una palabra traducida que es un 30 % más larga que el original— se nota de inmediato.
Este es exactamente el problema que vuelve tan incómoda la localización de imágenes: hay que cambiar el significado sin cambiar el diseño. El informe que sigue traza diez enfoques reales para lograrlo, desde el trabajo totalmente manual de un diseñador hasta la IA de un solo clic, con la fidelidad, el costo y los modos de fallo de cada uno.
Traducir texto en imagen
Traduce texto integrado en imágenes con nuestro traductor gratis en línea y reedita líneas antes de renderizar.
Por qué es tan difícil traducir el texto dentro de una imagen
Cuando traduces un documento, el diseño se adapta. Cuando traduces texto incrustado en una imagen, el diseño está congelado en píxeles. Esa única restricción genera una serie de problemas:
La longitud del texto cambia. Una frase corta en inglés puede crecer un 30 % o más en alemán o francés, mientras que esa misma frase se reduce drásticamente en chino o japonés. El espacio en el diseño original es fijo, así que la traducción debe reajustarse —cambiando el tamaño, redistribuyendo las líneas o modificando el interletrado— sin romper la composición.
Las fuentes y el estilo deben coincidir. La tipografía, el grosor, el color, el interletrado y los efectos como sombras o contornos del original tienen que reproducirse. Si fallas en ellos, la versión localizada se ve sutilmente ajena junto al original.
El fondo debe reconstruirse. Borrar el texto original destruye los píxeles que hay debajo. Sobre un color plano esto es trivial; sobre una foto, un degradado o una textura, estás reconstruyendo una imagen ausente.
Los elementos que no son texto también requieren cuidado. Las flechas, los globos, la numeración y las leyendas a menudo contienen texto o señalan hacia él, por lo que una localización limpia debe tenerlos en cuenta.
Cada método que sigue es una forma distinta de equilibrar esos cuatro problemas. La elección correcta depende de qué tan fiel deba ser el resultado, cuánto texto contenga la imagen y si dispones del archivo fuente original.
La ruta más rápida: traducción de imágenes con IA en línea
Antes de los métodos manuales, conviene saber que existe el atajo, y es el que la mayoría de la gente debería probar primero.
Las herramientas de IA en línea creadas justo para esta tarea, como ReWords AI, combinan la detección de texto, la traducción automática y el inpainting de imágenes con IA en un único flujo. En lugar de superponer un nuevo cuadro de texto, detectan el texto que ya está en la imagen, lo traducen, borran el original, reconstruyen el fondo y redibujan la traducción con una fuente, un color y un tamaño que coinciden, de modo que el diseño permanece intacto.
Cómo funciona:
- Sube la imagen. Abre la herramienta, elige la función «Translate Text in Image» y sube la imagen (por ejemplo, un anuncio con una banda de «SUMMER SALE»).
- Elige un idioma y edita. La plataforma detecta automáticamente cada línea de texto. Selecciona el idioma de destino y te devuelve una sugerencia de traducción línea por línea que puedes corregir a mano. Bloquea cualquier palabra que no deba cambiar, como los nombres de marca.
- Genera. Haz clic en Generate o Apply, y la IA elimina el texto original y redibuja la traducción usando la fuente, el color y el fondo originales.
- Descarga. Revisa el resultado y descarga la imagen localizada.
Figura: Ejemplo de traducción con IA en línea (izquierda: original; derecha: traducida).
Por qué es la opción por defecto: no necesita un archivo de diseño de origen, ni instalar software, ni conocimientos de diseño. Una imagen típica vuelve en segundos o en un minuto. Las herramientas de esta categoría suelen incluir una cuota gratuita (ReWords ofrece unas pocas generaciones gratuitas por imagen), y créditos de pago a partir de ahí.
Dónde hay que tener cuidado: la traducción en sí merece una revisión —sobre todo los números y los nombres propios—, y el texto denso, la iluminación compleja o las fuentes muy decorativas pueden hacer tropezar de vez en cuando con la reconstrucción de la IA. También conviene tener presentes los derechos de autor y el contenido sensible.
El mejor uso en el mundo real: imágenes de productos de comercio electrónico, gráficos publicitarios y para redes sociales localizados, menús, folletos y cómics: los trabajos de localización del día a día en los que ya no tienes el archivo original.
El kit completo: 10 formas de traducir el texto de una imagen sin romper el diseño
Si la imagen es compleja, si hay mucho en juego o si prefieres construir tu propio flujo de trabajo, aquí están los diez enfoques que vale la pena conocer. Cada uno detalla cómo funciona, qué necesita, cuán fiel es y para quién es.
Método 1: Edición de diseño manual (Photoshop / Illustrator)
Cómo funciona: Un diseñador profesional lo hace a mano. Primero, extrae el texto original (mediante OCR o transcripción manual) y lo traduce. Después, en Photoshop, Illustrator o una herramienta similar, vuelve a escribir la traducción con una fuente y un estilo que coincidan sobre la zona del texto original. El flujo es: extraer el texto → traducir y corregir → encontrar o recrear la fuente que coincida → borrar el texto original, insertar la traducción y ajustar los efectos.
Herramientas: Adobe Photoshop, Illustrator, InDesign, GIMP, Figma; herramientas de OCR como Tesseract pueden ayudar con la extracción.
Entrada / Salida: Cualquier formato de imagen de entrada (PNG/JPEG); una nueva imagen de salida en el mismo formato, o un archivo PSD/AI editable con capas.
Automatización: Baja. En su mayor parte manual, con automatización solo en la etapa de extracción por OCR.
Precisión y fidelidad: Máxima. El diseñador controla por completo la fuente, la posición y el estilo, y puede reproducir el diseño original al píxel. La fidelidad depende de la habilidad, es lento y es sensible a la expansión de la longitud de la traducción.
Tiempo y costo: Altos. Una edición profesional puede llevar de minutos a horas según la complejidad, y el software tiene una curva de aprendizaje: es ineficiente cuando traduces en volumen.
Pros y contras: Conserva por completo el diseño y el estilo (en teoría, un reemplazo sin costuras), lo que encaja con textos exigentes de marketing y marca. Pero es lento, caro y propenso a errores, y a menos que tengas la fuente idéntica, lograr una coincidencia perfecta es difícil.
Ideal para: Carteles publicitarios, diseño de envases, prototipos de interfaz y material impreso que exigen una localización de alta fidelidad.
Nota de caso: Atlas Cloud señala que, después de que el OCR extrae el texto, este todavía debe «volver a colocarse en el diseño» a mano, mientras que la edición de imagen pura fusiona los cambios en una nueva capa de mapa de bits con menos control sobre las letras individuales: la composición manual es más lenta, pero es la más precisa.
Método 2: OCR + composición tipográfica en software de diseño
Cómo funciona: Un flujo semimanual, algo más automatizado. Primero, ejecuta OCR sobre la imagen para extraer el contenido y la posición de cada cuadro de texto. Después, obtén las traducciones mediante traducción automática o humana. Por último, vuelve a renderizar la traducción en la imagen en las posiciones y los estilos originales usando software de maquetación o un script. Flujo: reconocimiento OCR → traducción del texto → reconstrucción del diseño → imagen de salida.
Herramientas: Librerías y aplicaciones de OCR (Tesseract, EasyOCR, OCR de Adobe Acrobat); API de traducción (Google Translate, DeepL, Baidu Translate); herramientas de maquetación (Adobe InDesign, Photoshop, o Pillow/Matplotlib en un entorno de programación).
Entrada / Salida: Cualquier formato de imagen de entrada (PNG/JPEG); una nueva imagen de salida. Se puede usar un documento vectorial (PDF/AI) como paso intermedio para conservar el diseño.
Automatización: Media. El OCR y la traducción pueden automatizarse, pero la composición final suele necesitar mano humana, sobre todo cuando los idiomas de origen y destino difieren mucho en longitud y hay que ajustar el tamaño de fuente y el interlineado.
Precisión y fidelidad: Alta. Si haces coincidir las fuentes y las posiciones de los marcos, el diseño se conserva bien. Pero la expansión de la traducción puede romper la distribución espacial original, lo que exige escalar o redistribuir las líneas, y los errores de posicionamiento en gráficos complejos perjudican la fidelidad.
Tiempo y costo: Medios. La parte de OCR y traducción es rápida (de segundos a minutos), pero la composición posterior lleva de minutos a decenas de minutos.
Pros y contras: Más rápido que el trabajo puramente manual, pero depende de la precisión del OCR y de la coincidencia de fuentes; pueden colarse pequeñas diferencias en el interletrado y las ligaduras. Encaja con imágenes con mucho texto y altos requisitos de diseño. El pero: no se ocupa de los elementos que no son texto (líneas guía, numeración); esos requieren trabajo manual.
Ideal para: Localizar anotaciones de gráficos, manuales técnicos y diagramas educativos con muchos elementos de texto.
Contexto: las herramientas de traducción de PDF siguen por lo general esta lógica: analizar la estructura del documento, traducir región por región y luego «reemplazar el texto en el sitio y conservar el diseño». Si ejecutas OCR y traducción bloque por bloque sobre una imagen, obtienes el mismo resultado en el sitio.
Método 3: Servicios dedicados de traducción de documentos (con conservación de formato)
Cómo funciona: Usa un servicio empresarial o en línea de traducción con conservación de formato. Estas herramientas analizan el diseño y las fuentes del archivo o la imagen de entrada, traducen automáticamente cada bloque de texto y vuelven a componer la salida. Pasos clave: análisis del diseño (identificar las coordenadas de los cuadros de texto y las fuentes) → traducción del texto (servicio en la nube o MT local) → re-renderización del diseño → archivo de salida. Las imágenes normalmente se conservan intactas.
Herramientas: Plataformas en línea o software comercial como PDFTranslator (motores Gemini + ChatGPT), la plataforma Pangeanic ECO, Pairaphrase y Smartcat. Muchos aceptan PDF o imágenes de entrada y producen un PDF o gráfico traducido que mantiene el estilo original.
Entrada / Salida: Escaneos, imágenes o PDF de entrada (JPG/PNG/PDF); un archivo traducido en el mismo formato como salida, con el diseño, las tablas y las posiciones de los gráficos esencialmente intactos.
Automatización: Alta. El sistema se ejecuta de principio a fin y solo necesita una ligera corrección humana.
Precisión y fidelidad: Alta. Los servicios avanzados usan OCR de alta precisión, además de LLM/sistemas de traducción dedicados, para lograr un mapeo a nivel de coordenadas del texto y el formato. El diseño y las fuentes se conservan (la fidelidad a nivel de documento puede alcanzar el 90 % o más), y el error proviene principalmente de las diferencias de longitud de la traducción.
Tiempo y costo: Bajos. La traducción es rápida: de segundos a minutos para la mayoría de los trabajos (un PDF de 60 páginas en minutos). Pero suele ser un servicio de pago o exige comprar cuota de API.
Pros y contras: La ventaja es su alta automatización, el ahorro de tiempo y una buena fidelidad. La desventaja es su sensibilidad a las tarifas de API (los documentos masivos o largos cuestan dinero) y el soporte limitado para diseños poco habituales o escritura a mano. Encaja con la traducción por lotes de documentos o imágenes.
Ideal para: Documentos técnicos multilingües de empresa, manuales de producto, materiales de formación e informes financieros en los que el diseño debe conservarse fielmente. En esencia, estos sistemas son el flujo de OCR + traducción + composición automática.
Método 4: Herramientas en línea de traducción de imágenes con IA
Cómo funciona: Servicios de IA dedicados traducen y modifican el texto directamente en una imagen, a menudo usando aprendizaje profundo para «enmascarar y repintar» de forma automática. Normalmente: sube el original → OCR automático de las regiones de texto → traducción automática (con corrección manual) → el modelo borra el original y repinta la traducción con un estilo de fuente similar → descarga la nueva imagen. Estas herramientas agrupan OCR, MT y compleción de imagen en una traducción de un solo clic.
Herramientas: ReWords AI, ImageGPT, EditTextImage, Codia, VisualGPT y similares. Las interfaces suelen permitirte bloquear las líneas de texto que no deben cambiar y editar la traducción sugerida.
Entrada / Salida: Un mapa de bits normal de entrada (PNG/JPEG); un mapa de bits de la misma resolución como salida, con la traducción renderizada en el estilo original.
Automatización: Alta. Subes y haces clic en «generar»; la IA se encarga de los pasos intermedios.
Precisión y fidelidad: Altas en general. Los modelos generativos modernos igualan el estilo de la fuente y la textura del fondo lo suficiente como para producir resultados de «edición no visible», aunque un texto muy denso, una iluminación compleja o fuentes muy decorativas pueden introducir defectos. La precisión del OCR depende de la calidad del origen, y la traducción automática es en gran medida neuronal: la calidad varía y merece una revisión humana.
Tiempo y costo: De bajos a medios. La mayoría de las herramientas en línea responden en segundos o en un minuto (a menudo con límites de uso gratuito), no necesitan instalación local y son amables con los usuarios no técnicos; el trabajo en volumen requiere pago o créditos.
Pros y contras: Cómodo y eficiente, y reemplaza el texto directamente sobre la imagen sin el archivo de diseño original. Pero la calidad depende de la IA, a veces exige reintentos o ajustes finos del prompt, y conviene manejar con cuidado los derechos de autor y la información sensible.
Ideal para: La localización cotidiana de imágenes de productos de comercio electrónico, anuncios y gráficos para redes sociales localizados, menús, folletos y cómics. Por ejemplo, ReWords muestra cómo reemplazar «SUMMER SALE» en el envase de un producto por «夏季特卖» manteniendo idéntico el fondo, y EditTextImage muestra «Summer sale — 30% off everything» traducido al alemán «Sommer-Sale — 30 % auf alles» con el diseño intacto. Son escenarios de localización clásicos.
Figura: Ejemplo de traducción con una herramienta de IA en línea (izquierda: original; derecha: traducida).
Método 5: Aplicaciones móviles de traducción instantánea
Cómo funciona: Usa la aplicación de traducción de imágenes de un teléfono (Google Translate, el modo cámara de Baidu Translate, Microsoft Translator) sobre una foto o una imagen importada. La mayoría reconoce el texto en tiempo real y superpone la traducción en la pantalla, o produce una captura con el texto traducido. Flujo: hacer/importar una foto → OCR automático → traducción automática → superponer o marcar el original → ver el resultado.
Herramientas: La aplicación Google Translate, la cámara de Baidu Translate, la función de escanear y traducir integrada en WeChat y similares.
Entrada / Salida: Una foto de teléfono o captura de pantalla de entrada; normalmente una imagen superpuesta o el texto traducido como salida. Algunas ofrecen una imagen anotada guardada.
Automatización: Totalmente automática. No requiere introducir texto: es sencilla de manejar.
Precisión y fidelidad: Bajas. El objetivo principal es comprender; la traducción usa una fuente predeterminada y una máscara de fondo tosca, y el diseño y el estilo originales no se conservan en absoluto. La calidad del OCR y de la traducción se acerca a la de las herramientas profesionales, pero la salida no sirve como archivo de diseño publicable.
Tiempo y costo: Extremadamente bajos. Traducción en tiempo real, normalmente unos pocos segundos.
Pros y contras: Rápida y cómoda, sin necesidad de conocimientos especializados: suficiente para el uso diario. Pero no puede conservar el diseño original, puede añadir un logotipo o una marca de agua, y la salida es solo para lectura de referencia, no para publicación final.
Ideal para: Entender rápidamente menús, señales de calle y manuales extranjeros de viaje o en la vida diaria. Los usuarios que fotografían texto con Baidu Translate y guardan la imagen a menudo ven la marca de la herramienta o un parche que cubre parte de ella. Estas herramientas son mejores para asistir a la lectura que para una localización formal.
Método 6: Edición con grandes modelos multimodales (p. ej., GPT-4 Vision)
Cómo funciona: Usa los últimos modelos de IA multimodales (GPT-4V/4.5, la edición de imágenes de ChatGPT, la edición de OpenAI DALL·E 3) para una edición de imágenes basada en instrucciones de alto nivel. Introduces la imagen original y usas un prompt en lenguaje natural para «traducir el texto manteniendo el diseño sin cambios». El modelo combina la detección de texto, la comprensión semántica y la generación de imágenes para cambiar las palabras conservando los elementos del diseño y el estilo. Flujo: imagen de entrada + instrucción → el modelo reconoce y traduce el texto → el modelo genera una nueva imagen → corrección humana.
Herramientas: OpenAI ChatGPT (con funciones de imagen como GPT-4V), la API de edición de imágenes DALL·E 3, Google Imagen Editor (en su mayor parte en fase de investigación) y acceso para desarrolladores a través de la API de OpenAI.
Entrada / Salida: Una imagen más un prompt de texto de entrada; una nueva imagen como salida (normalmente en la resolución original o según lo especificado).
Automatización: Alta. Basta con un prompt sencillo; el modelo hace el resto.
Precisión y fidelidad: Altas en general. Estos modelos conservan bien las relaciones del diseño y el estilo. Los ejemplos oficiales de OpenAI muestran la traducción al español de un diagrama de instrucciones de una cafetera manteniendo el diseño, y Atlas Cloud informa de que GPT-4V traduce el texto de una infografía a otros idiomas dejando todo lo demás intacto. Aun así, pueden pasar por alto algo de texto o introducir pequeños desplazamientos, sobre todo cuando la longitud del texto traducido difiere mucho de la del original, por lo que pueden ser necesarios arreglos posteriores.
Tiempo y costo: Medios. Generar una imagen suele llevar de segundos a decenas de segundos, pero los modelos avanzados requieren llamadas al servidor con costes de API o suscripción, además de tu tiempo escribiendo prompts y revisando la salida.
Pros y contras: Una experiencia amable con imágenes traducidas de un solo clic, y conserva las relaciones visuales (flechas, leyendas, jerarquía del diseño) en fondos complejos. Pero el control fino es limitado: hay que esperar errores ortográficos, algo de texto sin traducir o artefactos de composición que necesitan ojo humano. Todavía no puede sustituir a la composición tipográfica fina, pero rinde bien en la mayoría de los escenarios de marketing.
Ideal para: Localizar rápidamente infografías, carteles y material promocional ilustrado. Por ejemplo, puedes darle a ChatGPT una imagen publicitaria en inglés y el prompt «traduce todo el texto al chino, no cambies nada más», y el modelo genera la imagen en el idioma correspondiente.
Figura: Ejemplo de traducción multimodal con GPT-4V (izquierda: entrada en coreano; derecha: salida en vietnamita).
Método 7: Edición profunda con modelos de difusión (DALL·E, Stable Diffusion)
Cómo funciona: La edición de imágenes basada en difusión enmascara la región de texto de la imagen original y luego genera contenido de reemplazo a partir de un prompt. Flujo general: detectar el texto y generar una máscara → diseñar el prompt (por ejemplo, «reemplaza X por Y, mantén el fondo sin cambios») → usar DALL·E 3 o Stable Diffusion Inpainting para rellenar → obtener la nueva imagen. Por ejemplo, sube el original y una máscara de texto a la API de OpenAI y luego envía una solicitud de edición para «reemplazar el texto».
Herramientas: La API de edición DALL·E 3 de OpenAI, Adobe Firefly Generative Fill, HuggingFace Diffusers (por ejemplo, runwayml/stable-diffusion-inpainting). Controles como la detección de texto de ControlNet y el inpainting de LaMa ayudan a marcar las regiones que hay que reemplazar.
Entrada / Salida: El original + una máscara de texto + un prompt de entrada; un archivo de imagen como salida. El modelo normalmente iguala el idioma y el estilo de la traducción de forma automática.
Automatización: Media-alta. El paso de enmascarado necesita una herramienta adicional (dibujada a mano o generada por programa), pero la generación en sí es de un solo clic.
Precisión y fidelidad: Altas, pero algo por debajo de los modelos dedicados a la edición de texto. Los modelos de difusión suelen ser imprecisos con el texto largo (pueden partir palabras), y la consistencia del estilo depende de la calidad del prompt. Su punto fuerte es la reparación del fondo: puede integrar las traducciones en texturas complejas de forma natural. Su punto débil son las formas de letra a veces imperfectas, un ligero desenfoque o detalles no deseados. Los mejores resultados requieren máscaras y prompts ajustados.
Tiempo y costo: Medios. Generar una imagen suele llevar de diez a decenas de segundos (o depende de tu GPU en local); los servicios en la nube añaden tiempo de cola.
Ideal para: Traducción creativa —arte conceptual, eslóganes en ilustraciones— y cualquier caso en el que un ligero cambio de estilo sea aceptable. En el ejemplo siguiente, Stable Diffusion tradujo la banda inglesa «Summer sale — 30% off everything» al alemán «Sommer-Sale — 30 % auf alles», volviéndola a renderizar mientras mantenía el fondo sin cambios.
Figura: Ejemplo de reemplazo de texto con Stable Diffusion (izquierda: banda original en inglés; derecha: resultado en alemán).
Método 8: Flujo personalizado de visión por computador + script
Cómo funciona: Un flujo de automatización totalmente hecho a medida. Usa visión por computador para detectar las regiones de texto (por ejemplo, detección de bordes/contornos con OpenCV o un modelo de OCR profundo), combínala con una API de traducción automática y dibuja la traducción sobre la imagen original con una librería de imágenes (Pillow/OpenCV). Pasos: detección de texto → OCR y traducción por cuadro → recortar y rellenar el fondo de la región de texto (con un algoritmo de inpainting) → dibujar el nuevo texto → salida.
Herramientas: Python (Pillow, OpenCV, EasyOCR, pytesseract, las API de Baidu o Google Translate), Adobe PixelSense, procesamiento de imágenes con C#/.NET y similares.
Entrada / Salida: Un mapa de bits normal de entrada; un mapa de bits de la misma resolución como salida. Todo el flujo es hecho a medida o programado con scripts, sin una interfaz gráfica lista para usar.
Automatización: Alta (si el script está bien construido). Totalmente apto para lotes.
Precisión y fidelidad: Dependen de los detalles del algoritmo. Puede igualar el diseño de forma aproximada, pero normalmente no puede igualar las fuentes de forma automática: eliges la más cercana a mano. Tampoco puede reparar los fondos con la misma naturalidad que los modelos de difusión; suele rellenar los huecos con un color plano o la media del entorno, y tiene limitaciones con fondos complejos o fuentes no estándar.
Tiempo y costo: Alto coste de desarrollo (requiere programar), con un tiempo de ejecución que depende de la eficiencia del OCR y del dibujo (segundos por imagen). En comparación con los servicios de terceros, su coste monetario es cero, pero el esfuerzo de programación es elevado.
Pros y contras: Control total del flujo y bueno para la automatización por lotes, pero la fidelidad al detalle del diseño va por detrás de las herramientas de IA dedicadas y necesita ajuste de parámetros y corrección posterior. Encaja con escenarios de personalización profunda o de privacidad de datos (sin red pública).
Ideal para: Entornos empresariales con requisitos de proceso especiales, o el reemplazo sencillo de etiquetas a pequeña escala, por ejemplo, un comerciante que programa un flujo para hacer OCR, traducir y reescribir las etiquetas de las imágenes de producto. Técnicamente exigente, pero flexible.
Método 9: Servicio profesional de traductor humano + DTP
Cómo funciona: Externalízalo a un equipo de traducción y diseño. Un traductor profesional traduce primero el texto, y luego un diseñador de autoedición (DTP) lo reemplaza paso a paso cotejándolo con el original. Incluye: identificar y editar el archivo fuente (PSD/InDesign) → traducir el texto → ajustar el diseño y volver a renderizar en el mismo software.
Herramientas: Normalmente la suite de Adobe, InDesign, Illustrator. Los proveedores pueden usar herramientas TAO (Trados, MemoQ) para mantener la coherencia terminológica, pero la salida final depende del software de diseño.
Entrada / Salida: Cualquier imagen o archivo fuente de entrada; normalmente una imagen localizada de alta calidad o un archivo editable como salida.
Automatización: Baja. Un servicio totalmente manual que requiere intervención humana en cada paso.
Precisión y fidelidad: Máximas. Los traductores y los diseñadores pueden adaptar el texto a los matices culturales mientras conservan o ajustan el diseño con precisión, y la calidad de la salida está garantizada por profesionales.
Tiempo y costo: Máximos. Los costes combinan las tarifas de traducción y el tiempo de diseño, normalmente mucho más que las opciones automáticas. Encaja con proyectos de alto valor o contenido muy sensible.
Pros y contras: Calidad y fiabilidad de primer nivel, a un coste económico y temporal mucho mayor que cualquier método automatizado.
Ideal para: Campañas de imagen de marca, materiales importantes de ferias comerciales, contenido de imagen en documentos gubernamentales o legales y publicaciones localizadas que necesitan corrección humana.
Método 10: Traducción automática mediante archivos vectoriales / fuente
Cómo funciona: Si la imagen de origen proviene de software vectorial o de diseño, puedes reemplazar el texto dentro del propio entorno de diseño. Por ejemplo, InDesign o Illustrator con complementos o scripts pueden extraer el texto mediante OCR o conversión automática, traducirlo y volver a insertarlo en los marcos de texto. Como alternativa, convierte la imagen a PDF, tradúcela con OCR y vuelve a importarla.
Herramientas: Adobe Acrobat (OCR + exportación a Word), la función de buscar y reemplazar texto de Illustrator, los scripts de InDesign o complementos de terceros (Lokalise, el plugin de InDesign de Transifex, etc.).
Entrada / Salida: Normalmente un documento editable o PDF de entrada; el texto reemplazado directamente en el archivo original como salida.
Automatización: Media. Depende de la automatización y el soporte de scripts del software.
Precisión y fidelidad: Altas. Como editas la fuente directamente, se conservan todas las capas y los efectos, siempre que dispongas del archivo original. Si es una imagen ya aplanada, necesitas ayuda de OCR y se comporta como el Método 2.
Tiempo y costo: Medios. El reemplazo automatizado sigue necesitando ajustes finos humanos.
Pros y contras: Composición tipográfica precisa desde el archivo fuente, pero depende de tener el archivo original editable y el software adecuado.
Ideal para: Proyectos de traducción en los que tienes la fuente de diseño, por ejemplo, traducir un manual maquetado en InDesign, o situaciones de emergencia en las que haces primero una traducción aproximada con OCR y luego la refinas en el archivo fuente.
La comparación cara a cara
| Método | Fidelidad del diseño | OCR / reconocimiento | Multilingüe | Dificultad técnica | Costo | Velocidad | Mejor uso |
|---|---|---|---|---|---|---|---|
| 1. Software de diseño profesional (manual) | Muy alta | N/A (humano) | Cualquiera | Alta (necesita un diseñador) | Máximo (mano de obra) | Lenta (manual) | Activos de marca / marketing de altas prestaciones |
| 2. OCR + composición | Alta | Alta (texto estructurado) | Muchos | Media-alta (software/scripts) | Bajo (código abierto) | Media | Documentos técnicos, diagramas rotulados, gráficos estructurados |
| 3. Servicio de traducción de documentos | Alta | Alta (OCR profesional) | Muchísimos | Baja (llave en mano) | Media-alta (tarifa de servicio) | Rápida | PDF/escaneos masivos, documentos profesionales |
| 4. Herramientas de IA en línea (ReWords, etc.) | Alta | Alta (IA) | Muchos | Baja (llave en mano) | Bajo/media (gratis + pago) | Rápida | Carteles de comercio electrónico, cómics, localización diaria de varias imágenes |
| 5. Aplicaciones de cámara del teléfono | Baja | Media-alta (en mano) | Muchos | Muy baja (llave en mano) | Bajo (gratis) | En tiempo real | Lectura rápida para viajes / vida diaria |
| 6. Edición con grandes modelos multimodales | Alta | Alta (modelo) | Muchísimos | Baja (llave en mano) | Media-alta (tarifa de API) | Media | Infografías, carteles publicitarios, capturas de UI que requieren razonamiento rápido |
| 7. Modelos de difusión (DALL·E, etc.) | Media-alta | Media (necesita máscara) | Muchos | Media (habilidad con prompts) | Media (API/cómputo) | Media | Diseño creativo, requisitos de estilo flexibles |
| 8. Flujo personalizado en Python | Media | Media (según la herramienta) | Muchos | Alta (programación) | Bajo (código abierto) | Flexible (lote autom.) | Entornos de automatización (personalizados de empresa, por lotes) |
| 9. Humano profesional + DTP | Muy alta | N/A (humano) | Cualquiera | Muy alta (equipo experto) | Máximo (tarifa de servicio) | Muy lenta (manual) | Publicaciones de gama alta, exigencias estrictas de texto/formato |
| 10. Traducción directa desde el archivo fuente | Muy alta | Alta (desde la fuente) | Muchos | Media (software de diseño) | Bajo (software existente) | Media | Proyectos con fuente editable (libros de InDesign, traducción de informes) |
Nota: aquí «fidelidad» significa cuán fielmente la imagen traducida coincide con el diseño original. Las aplicaciones de teléfono sirven para comprender y añaden una máscara grande, por lo que su fidelidad es baja; el diseño profesional y los servicios de traducción de documentos conservan por completo el diseño y las fuentes, por lo que puntúan alto.
Tres tutoriales de principio a fin
Si quieres profundizar más allá de hacer clic en un botón, aquí tienes los tres enfoques que vale la pena aprender. Cada uno incluye el flujo completo y código funcional.
Tutorial 1: Edición multimodal con GPT-4 Vision
Resumen: Este ejemplo muestra cómo usar GPT-4 de OpenAI con funciones de imagen (o DALL·E) para editar el texto dentro de una imagen. Preparación: Regístrate en OpenAI y obtén una clave de API. Prepara una imagen de muestra con texto y una máscara que coincida. Supongamos que queremos traducir el inglés «Summer sale» al chino «夏季特卖».
Flujo: introducir la imagen original → llamar al endpoint de edición de GPT-4V o DALL·E → el modelo reconoce y traduce el texto → el modelo genera una nueva imagen → descargar y corregir.
- Prepara la imagen y la máscara. Asegúrate de que el original (
orig.png) y la máscara (mask.png) estén alineados, y que la máscara cubra solo la región del texto «Summer sale». - Llama a la API (usando el SDK de Python de OpenAI como ejemplo):
```python import openai openai.api_key = "YOUR_API_KEY"
Pide al modelo que traduzca al chino el texto del área enmascarada
y que deje todo lo demás sin cambios.
response = openai.Image.create_edit( image=open("orig.png", "rb"), mask=open("mask.png", "rb"), prompt="用中文翻译上面的文字,不改变其他内容。", n=1, size="1024x768" )
Guarda en disco la imagen devuelta
with open("output.png", "wb") as f: f.write(response['data'][0]['image']) ```
Esto le indica al modelo que traduzca al chino el texto de la región enmascarada y deje el resto sin tocar, y luego genere el resultado.
- Revisa la salida. Comprueba
output.png. El modelo debería haber reemplazado «Summer sale» por «夏季特卖», con un estilo de fuente similar y un fondo idéntico.
Figura: Ejemplo de traducción con GPT-4V (izquierda: original en coreano; derecha: salida del modelo en vietnamita).
- Guarda el resultado. Usa
output.pngy, de forma opcional, ajusta con precisión la posición o el estilo del texto en un editor de imágenes.
Advertencias: Corrige siempre el texto generado por GPT-4V. Si falta algo, prueba con un prompt más detallado o traduce en bloques más pequeños. La API de OpenAI factura según el tamaño de la imagen y el número de generaciones.
Tutorial 2: Herramientas de IA en línea (ReWords / EditTextImage)
Resumen: Usa la aplicación ReWords o un sitio similar para traducir una imagen; en este ejemplo, ReWords. Preparación: Abre una herramienta en línea como ReWords o EditTextImage; no requiere instalación.
Flujo: subir el original → el sistema hace OCR y detecta el texto → traduce automáticamente y muestra el texto sugerido → ajustas el texto y bloqueas lo que debe permanecer → la IA renderiza la nueva imagen → descargar la imagen traducida.
- Sube la imagen. Abre el sitio de ReWords, elige la función «Translate Text in Image» y sube la imagen que quieres traducir (aquí, un anuncio que contiene «SUMMER SALE»).
- Elige un idioma y edita. La plataforma detecta cada línea de texto, tú eliges el idioma de destino (por ejemplo, chino) y te devuelve sugerencias línea por línea. Corrige cualquier error de traducción y bloquea las palabras que no deberían cambiar (como los nombres de marca).
- Genera la imagen. Haz clic en Generate o Apply, y la IA elimina el texto original y redibuja la traducción con la fuente, el color y el fondo originales.
- Descarga el resultado. Descarga la nueva imagen. En el ejemplo siguiente, la izquierda es la imagen original «SUMMER SALE» y la derecha es la versión «夏季特卖» generada por ReWords.
Figura: Ejemplo de traducción de imagen con ReWords (izquierda: original; derecha: traducida por IA).
Consejos: Estas herramientas suelen tener una cuota gratuita (ReWords incluye varias generaciones gratuitas por imagen), y a partir de ahí, pago o créditos. La calidad de la traducción es alta, pero verifica el texto, sobre todo los números y los nombres propios. Es ideal cuando no puedes conseguir el archivo de diseño original y necesitas localizar la imagen directamente.
Tutorial 3: Traducción automatizada con OCR en Python + OpenCV
Resumen: Un script que extrae el texto de una imagen, lo traduce y lo vuelve a renderizar dentro de la imagen. Usaremos Tesseract OCR con OpenCV/Pillow para traducir una imagen en español al inglés.
Flujo: cargar el original → detección de texto y OCR (Tesseract) → llamar a un motor de traducción (API de Google Translate) → usar OpenCV para borrar la región del texto original → dibujar la traducción con Pillow → generar la imagen localizada.
- Instala las dependencias (primero Tesseract-OCR y las librerías de Python):
```bash
Instala Tesseract (ejemplo para Ubuntu)
sudo apt-get install tesseract-ocr
Instala las librerías de Python
pip install pytesseract pillow googletrans==4.0.0-rc1 ```
- El script:
```python from PIL import Image, ImageDraw, ImageFont import pytesseract from googletrans import Translator
Carga la imagen original
image = Image.open("image_with_text.png")
Ejecuta el OCR (reconoce texto en español)
text = pytesseract.image_to_string(image, lang='spa') print("Recognized text:", text)
Traduce el texto
translator = Translator() result = translator.translate(text, src='es', dest='en') print("Translation:", result.text)
En este ejemplo la posición del texto es conocida; en producción
usarías pytesseract.image_to_boxes para obtener un cuadro por carácter.
x, y, w, h = 50, 50, 300, 50 # coordenadas de ejemplo
Borra el texto original de la imagen
draw = ImageDraw.Draw(image) draw.rectangle(((x, y), (x + w, y + h)), fill="white") # cubrir con blanco
Dibuja el texto traducido
font = ImageFont.truetype("arial.ttf", size=36) draw.text((x, y), result.text, font=font, fill="black")
Guarda la salida
image.save("translated_image.png") ```
- Cómo funciona: el script primero aplica OCR al original con Tesseract, obtiene la traducción con Google Translate (
googletrans) y luego usa Pillow para borrar la región original y dibujar la traducción. El ejemplo maneja una única región fija; una aplicación real determinaría las regiones de forma dinámica a partir de los resultados del OCR y haría coincidir las fuentes (aquí se simplifica a modo de ilustración). - Salida: al ejecutarlo se genera
translated_image.png, con la región del texto original reemplazada por la traducción al inglés.
Advertencias: Este flujo depende de la precisión del posicionamiento del OCR y de la capacidad de hacer coincidir fuentes. En la práctica, combina la detección de contornos de OpenCV para un recorte preciso y usa Pillow para medir la anchura del texto y lograr el ajuste automático de líneas. Para texto de varias líneas, recorre cada segmento en un bucle. Todo el proceso puede hacerse por lotes, pero la fidelidad del diseño va por detrás de los métodos de inpainting con IA, así que pruébalo y cuenta con ajustar parámetros.
Cómo elegir: una guía de decisión
Ajusta el método a tres cosas: la fidelidad, el costo y si tienes el archivo fuente:
- No tienes el archivo fuente y lo quieres rápido (el caso habitual): usa una herramienta de IA en línea como ReWords AI (Método 4). Sube, elige un idioma, genera, descarga.
- La imagen tiene mucho texto y está estructurada (gráficos, manuales, diagramas): OCR + composición (Método 2), o un servicio de documentos con conservación de formato para el trabajo en volumen (Método 3).
- El resultado debe ser perfecto para impresión y crítico para la marca: diseño manual (Método 1) o humano profesional + DTP (Método 9).
- Lo quieres automatizado dentro de tu propio flujo de trabajo: una API de modelo multimodal (Método 6) o un flujo personalizado en Python (Método 8).
- Necesitas traducir una captura rápida solo para leerla: una aplicación de cámara del teléfono (Método 5), pero nunca para publicar.
- Todavía tienes el archivo fuente editable: edítalo directamente (Método 10). Es la ruta más limpia posible cuando está disponible.
Cinco reglas para conservar el diseño
Sea cual sea la ruta que tomes, estos hábitos separan lo «traducido» de lo «localizado profesionalmente»:
- Planifica los cambios de longitud del texto. El alemán y el francés normalmente se expanden; el chino y el japonés se contraen. Cuenta con cambiar el tamaño, redistribuir las líneas o modificar el interletrado, y nunca des por hecho que la traducción cabe tal cual en el cuadro original.
- Haz coincidir la fuente, no solo las palabras. Reproduce el grosor, el color, el interletrado y cualquier trazo o sombra originales. Una traducción perfecta con la tipografía equivocada sigue leyéndose como errónea.
- Reconstruye el fondo de forma limpia. La zona reparada detrás del texto debe ser indistinguible de su entorno: difumina los bordes y revisa la costura con un zoom 1:1.
- Ocúpate de los elementos que no son texto. Las flechas, los globos, la numeración y las leyendas a menudo contienen texto o señalan hacia él; tenlos en cuenta para que la versión localizada siga siendo coherente.
- Corrige la propia traducción. La traducción automática es rápida, pero imperfecta. Los números, las unidades, los nombres de marca y los nombres propios merecen una comprobación humana antes de publicar.
La conclusión
No necesitas el archivo de diseño original para traducir el texto dentro de una imagen. Lo que necesitas es elegir el método adecuado para la fidelidad que buscas, y para la mayoría de las imágenes cotidianas ese método es una herramienta de IA de un solo clic que lee el texto, lo traduce y lo redibuja en el sitio sin alterar el diseño.
Cuando hay mucho en juego y la imagen es compleja, las herramientas más pesadas —el diseño manual, los servicios de documentos o el DTP profesional— siguen teniendo su lugar. Pero para la gran mayoría de menús, carteles, imágenes de producto y gráficos para redes sociales, puedes localizar en minutos.
Toma una imagen que llevas tiempo queriendo traducir, súbela a ReWords AI y comprueba con qué fidelidad una traducción con IA de un minuto conserva el diseño antes de plantearte la vía manual.
References
- Documentación de edición de imágenes y de edición con DALL·E de OpenAI.
- Investigación sobre traducción de PDF e imágenes con conservación de formato.
- Informe de Atlas Cloud sobre la extracción por OCR y su recolocación en flujos de diseño.
- Documentación de producto de las herramientas en línea de traducción de imágenes (ReWords AI, EditTextImage y similares).
- Documentación de Tesseract OCR, OpenCV y Pillow para flujos personalizados.